nrow(data)
ncol(data)R 语言技巧
R
dplyr
stringr
正则表达式
CSS颜色
文本分析
数据可视化
代码片段
常用 R 技巧与代码片段:dplyr 数据处理、stringr 文本操作、CSS 颜色名称、代码速查表等。
常用要点
| 要点 | 说明 |
|---|---|
| 相对路径 | 数据与代码放同一文件夹,用相对路径读取,避免路径含空格报错 |
统计量加 na.rm = TRUE |
sum、mean、sd、IQR 等均需加,否则有缺失值时结果为 NA |
| 明确观测单位 | 确认每行代表什么; 混合类型(如 post/comment)应先 filter(type == "post") |
count() 内计算时命名 |
如 count(month = month(date)) |
区分 filter() 和 select() |
filter(condition) 选行; select(col) 选列 (filter逻辑运算符) |
取值用 nrow() / pull() |
nrow() 返回行数;pull() 从数据框取出单个值 |
| 文本处理用 stringr + Regex | str_length() 数字符;str_count(text, "\\S+") 数单词 |
| 新增列后赋值回原变量 | data <- data |> mutate(…) |
TRUE / FALSE 别名 |
等价于 T / F |
| 善用 RStudio Snippet | 用代码模板减少重复输入 |
1 观察数据
1.1 行数 / 列数
1.2 有多少符合条件的 Observation
data |> filter(条件) |> nrow()# 示例: 已知 data 有 type 列, 其中只有 "comment" 和 "post" 两种值
# 求一共多少个 post
# 方法1: 用 nrow() 直接返回行数, 其他 dplyr 函数都需要最终用 pull() 来取出数值
data |>
filter(type == "post") |>
nrow()
# 方法2:
data |>
filter(type == "post") |>
count(type) |> # 此处 count 和 filter 的顺序即使调换结果也一样
pull(n)
# 方法3:
data |>
filter(type == "post") |>
summarize(n = n()) |>
pull(n)1.3 某列中 Observation 数量最多的 类 是哪个
data |> count(col, sort=T) |> head(1) |> pull(col)# 示例: 已知 data 里有 date 列, 其 datatype 是 Date (yyyy-mm-dd)
# 求哪一年的 post 最多
# 方法1:
data |>
filter(type == "post") |>
count(year = year(date), sort = TRUE) |>
head(1) |> # 上一行已经指定了 sort=T, 此处直接用 head(1) 即可
pull(year)
# 方法2:
data |>
filter(type == "post") |>
count(year = year(date)) |> # count 生成一个两列的 df, year 和 n
slice_max(n, n = 1) |> # 第一个 n 是列名, 第二个是行数, 意为选取n最大的一行
pull(year)1.4 某列的 min / max 值是多少
# 问的是所有行的话 (e.g. "overall activity", "across the whole dataframe")
# 无需用 pipe, 如果有限制条件 (e.g. "only posts"), 先 filter
min(data$col, na.rm = TRUE)
max(data$col, na.rm = TRUE)
1.5 某列有多少 unique value
n_distinct(data$col)2 清理数据
2.1 求 mean / median 并保留 2 位小数
summarize(mean = round(mean(col, na.rm = TRUE), 2)) |> pull(mean)# 示例: 求 2019 年 post 的 score 的平均值, 保留 2 位小数
data |>
filter(type == "post" & year(date) == 2019) |>
summarize(mean = round(mean(score, na.rm = TRUE), 2)) |>
pull(mean)# 示例: 求每年的 post median score, 保留 2 位小数,
# 按 median score 从高到低排列, 展示成一个 dataframe
data |>
filter(type == "post") |>
group_by(year = year(date)) |>
summarize(
median_score = round(median(score, na.rm = TRUE), 2),
.groups = "drop" # group + summarize 必须加上 drop
) |>
arrange(desc(median_score)) # 排序, 也可以写成 arrange(-median_score)2.2 增加一列
data <- data |> mutate(new_col = 对于col进行操作)# 添加一列 字符数
data <- data |>
mutate(text_length = str_length(text))
# 添加一列 单词数
data <- data |>
mutate(word_count = str_count(text, "\\S+"))2.3 某列最大值所在行的另一列值
data |>
slice_max(col1, n = 1) |>
pull(col2)# 示例: word_count 最多的 post 的 author 是谁?
data |>
# 问的是 post, 但 data 里不都是 post, 首先要 filter
filter(type == "post") |>
slice_max(word_count, n = 1) |>
pull(author)2.4 求 text length (字符数)
str_length(text)2.5 求单词数量
str_count(text, "\\S+")3 可视化
3.1 Bar Chart
# 示例: 画出 2019 年每月 post 数量的 bar chart
# 第一步: 获取用于绘图的数据
bar_data <- data |>
filter(type == "post" & year(date) == 2019) |>
count(month = month(date)) # 无需 sort = TRUE
# 第二步: 画图
ggplot(bar_data, aes(x = factor(month), y = n)) +
# month 列是数字, 直接用的话 x 轴会变成连续的, 要用 factor(month)
# 注: 由于"月份"是时间, 本身有顺序, 无需把 bar 按照大小排列;
# 如果是 nominal 比如"地区", 可以用 x = reorder(area, -n) 来降序排列
# 如果地区过多或地区名称过长, 可以用 coord_flip() 来转成横向 bar chart
# 注意要用 geom_col 而不是 _bar, 因为此处 y 是 n 列中的值 (预先计算好的行数),
# 而不是让 ggplot 自己去数 x 中不同 category 的行数
geom_col(fill = "steelblue") + # 随便指定一个喜欢的颜色
labs(
title = "Monthly Post Count in 2019",
x = "Month",
y = "Post Count"
)3.2 Histogram
# 画出 post score 的 histogram
ggplot(data |> filter(type == "post"), aes(x = score)) +
geom_histogram(fill = "steelblue", bins = 30) + # 指定 bin 数
labs(
title = "Post Score Distribution",
x = "Post Score",
y = "Frequency"
)4 文本分析
# 示例: 用一个 dataframe 展示出 post 中 top10 词频的词, 并保存到 top1 词成变量
data |>
filter(type == "post") |>
unnest_tokens(word, text) |>
anti_join(stop_words) |>
count(word, sort = TRUE) |>
head(10)
top1 <- data |>
filter(type == "post") |>
unnest_tokens(word, text) |>
anti_join(stop_words) |>
count(word, sort = TRUE) |>
head(1) |>
pull(word)5 统计
5.1 求统计量
round(sd(data$col, na.rm = TRUE), 2)
IQR(data$col, na.rm = TRUE)5.2 先处理再求统计量
filter(条件) |> summarize(mean = mean(col, na.rm = TRUE)) |> pull(mean)5.3 检测统计量 + 解读结果
t.test(col1 ~ col2, data = data)5.4 线性回归 + 系数
m <- lm(col1 ~ col2, data = data)
coef(m)[[1]] # intercept
coef(m)[[2]] # slope6 附加
6.1 常用 dplyr 函数
| 函数 | 作用 | 示例 |
|---|---|---|
filter(条件) |
保留满足条件的行 | filter(type == "post" & score > 10) |
select(列) |
根据列名选列 | select(col1), col1:col3, -col3 |
count(列) |
这列中所有 unique value 的行数 | count(year = year(date), sort = TRUE) |
nrow() |
数当前有多少行 | 没有参数, 一般配合 filter() 使用:filter(score > mean(score, na.rm=T)) |> nrow() |
slice_max(列, n=行数) |
选出这列中值最大的行 | slice_max(score, n = 10) |
pull(列) |
返回这列的值 | 一般先 filter / slice_max / head / summarize 到只剩一行, 然后 pull(列名), 比如:summarize(mean_age=mean(age,na.rm=T))|> pull(mean_age) |
mutate(新列=表达式) |
在原df基础上添加/修改列 | mutate(perc = col1/col2*100) |
group_by(分类的列) |
分组 (配合 summarize/mutate) | group_by(age) |
summarize(...) |
返回总结报告 | group_by(age) |>summarize(avg = mean(score, na.rm=T), .groups=“drop”) |
arrange(列) |
排序(默认升序) | arrange(age, desc(score)) |
glimpse(df) |
查看结构(≈ str()) |
glimpse(data) |
rename(新=旧) |
重命名列(不新建列) | rename(new_col = old_col) |
group_by+summarize:必须加.groups="drop";保留分组列 + 汇总列,行数压缩为每组一行group_by+mutate:保留所有列且行数不变,之后须ungroup()mean(condition)→ 满足条件的比例;sum(condition)→ 满足条件的个数
注意区分
nrow()和n(): 同样是数行数,nrow()接受 dataframe 作为参数;n()是 dplyr 上下文函数, 只能在summarize()/mutate()内部使用 (如summarize(number_of_observation = n())), pipe 时只能用nrow()
# 示例:
# 已知 data 有一列 type, 只有 "post" 和 "comment" 两种值;
# 另一列 word_count 是帖子或评论中的词数, 求有多少帖子词数少于 10
data |>
filter(type == "post" & word_count < 10) |>
nrow() # 直接返回数字
data |>
filter(type == "post" & word_count < 10) |>
summarize(count = n()) |> # summarize() 仍然返回 dataframe
pull(count) # 需要 pull 才能得到数字6.2 filter() 中的逻辑运算符
| Operator | 说明 |
|---|---|
! & | |
not / and / or |
== != |
向量相等 / 不等 |
> >= < <= |
大于 / 大于等于 / 小于 / 小于等于 |
%in% |
左元素是否存在于右向量 (非向量比较) |
%in%判断元素存在性;==按位置匹配(长度不等会循环)
# 示例:
# 已知 data 中有一列 date, 该列的 datatype 是 Date (yyyy-mm-dd);
# 已知另一列 type, 该列有 "post" 和 "comment" 两种值;
# 求年份是 2019 和 2023 的 post 一共有多少个
data |>
filter(type == "post" & year(date) %in% c(2019, 2023)) |>
nrow()
# 1. 条件1 是 type 为 "post", 用 == 符号
# 2. 条件2 是 年份 为 2019 或 2023,
# 首先要取出 date 列中的 年份, 使用 year() 取出完整日期(yyyy-mm-dd)中的年份;
# 然后满足年份是 2019 或 2023, 此处可以用两种方法:
# 1) (year(date) == 2019 | year(date) == 2023)
# 2) year(date) %in% c(2019, 2023)
# 3. 同时满足两个条件, 用 & 符号连接
# 注: 如果上一步使用了 1) 的写法, 最好在外面加上括号后再用 & 连接两个条件
# 4. 用 nrow() 数符合 filter 条件的一共有多少行
# 扩展:
# 如果求年份从 2019 到 2023 的所有 post 一共有多少个, 可以用
# year(date) %in% 2019:2023
# 因为 2019:2023 实际返回 c(2019, 2020, 2021, 2022, 2023)6.3 select() 中的辅助函数
注意: select() 选择的是列, filter() 选择的是行; 两者功能不同, 不可混用
| 写法 | 效果 |
|---|---|
select(col1:col3) |
选 col1 到 col3 |
select(-col3) |
排除 col3 |
select(contains(“x”)) |
列名含 “x” |
select(starts_with(“c”)) |
列名以 “c” 开头 |
select(ends_with(“3”)) |
列名以 “3” 结尾 |
select(everything()) |
全选 |
6.4 Regex
# 添加一列 字符数
data <- data |>
    mutate(text_length = str_length(text))

# 添加一列 单词数
data <- data |>
mutate(word_count = str_count(text, "\\S+"))| Pattern | Meaning | Example | Matches |
|---|---|---|---|
. |
任意单个字符 | "a.c" |
“abc”, “a1c”, “a c” |
^ |
字符串开头 | "^The" |
“The dog” 但不匹配 “See The dog” |
$ |
字符串结尾 | "end$" |
“the end” 但不匹配 “endless” |
* |
前一个字符出现零次或多次 | "ab*c" |
“ac”, “abc”, “abbc” |
+ |
前一个字符出现一次或多次 | "ab+c" |
“abc”, “abbc” 但不匹配 “ac” |
? |
前一个字符出现零次或一次 | "colou?r" |
“color”, “colour” |
\\ |
转义特殊字符 | "\\." |
字面意义的句点 “.” |
| Pattern | Meaning | Example |
|---|---|---|
[abc] |
匹配 a、b 或 c | "[aeiou]" 匹配元音 |
[a-z] |
匹配任意小写字母 | |
[A-Z] |
匹配任意大写字母 | |
[0-9] |
匹配任意数字 | 等同于 \\d |
[^abc] |
匹配除 a、b、c 以外的任意字符 | [^0-9] 匹配非数字 |
| Shorthand | Meaning | Equivalent |
|---|---|---|
\\d |
任意数字 | [0-9] |
\\D |
任意非数字 | [^0-9] |
\\w |
任意单词字符 | [a-zA-Z0-9_] |
\\W |
任意非单词字符 | [^a-zA-Z0-9_] |
\\s |
任意空白字符 | 空格、制表符、换行 |
\\S |
任意非空白字符 |
6.5 stringr 函数
| Function | Purpose | Example |
|---|---|---|
str_detect() |
是否存在匹配 (TRUE/FALSE) | str_detect(x, "pattern") |
str_subset() |
返回匹配的元素 | str_subset(x, "pattern") |
str_extract() |
提取第一个匹配 | str_extract(x, "pattern") |
str_extract_all() |
提取所有匹配 | str_extract_all(x, "pattern") |
str_replace() |
替换第一个匹配 | str_replace(x, "pattern", "replacement") |
str_replace_all() |
替换所有匹配 | str_replace_all(x, "pattern", "replacement") |
str_match() |
提取第一个匹配的分组 | str_match(x, "pattern") |
str_count() |
统计匹配次数 | str_count(x, "pattern") |
str_split() |
按模式拆分字符串 | str_split(x, "pattern") |
6.6 常用颜色名称
| 颜色名称 | 预览 | 颜色名称 | 预览 |
|---|---|---|---|
| pink | ████ | beige | ████ |
| lightpink | ████ | darkseagreen | ████ |
| lightcoral | ████ | mediumseagreen | ████ |
| palevioletred | ████ | forestgreen | ████ |
| rosybrown | ████ | green | ████ |
| indianred | ████ | seagreen | ████ |
| firebrick | ████ | teal | ████ |
| tomato | ████ | lightseagreen | ████ |
| coral | ████ | mediumaquamarine | ████ |
| salmon | ████ | powderblue | ████ |
| lightsalmon | ████ | lightblue | ████ |
| sandybrown | ████ | skyblue | ████ |
| orange | ████ | lightskyblue | ████ |
| peru | ████ | lightsteelblue | ████ |
| tan | ████ | steelblue | ████ |
| wheat | ████ | mediumpurple | ████ |
| bisque | ████ | plum | ████ |
| linen | ████ | thistle | ████ |
6.7 相对路径
相对路径。 将 Rmd 文件与 csv 放在同一文件夹, 用 read_csv("./exam-data.csv") 读取; ./ 指当前文件夹。推荐使用相对路径, 可避免路径含空格导致的报错。
绝对路径。 在 Finder 中选中文件后按 ⌥⌘C 可复制绝对路径, 如 data <- read_csv("/Users/username/EM747/mid-exam/exam-data.csv")。
6.8 RStudio Snippet
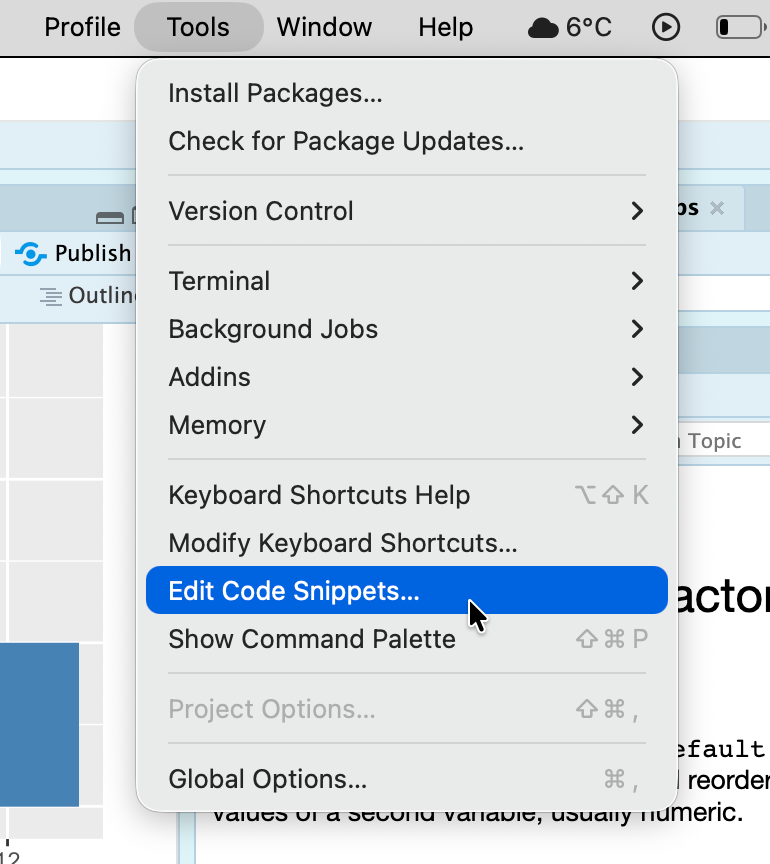
在 RStudio > Tools > Edit Code Snippets
R > 在最下方添加新代码 > 保存
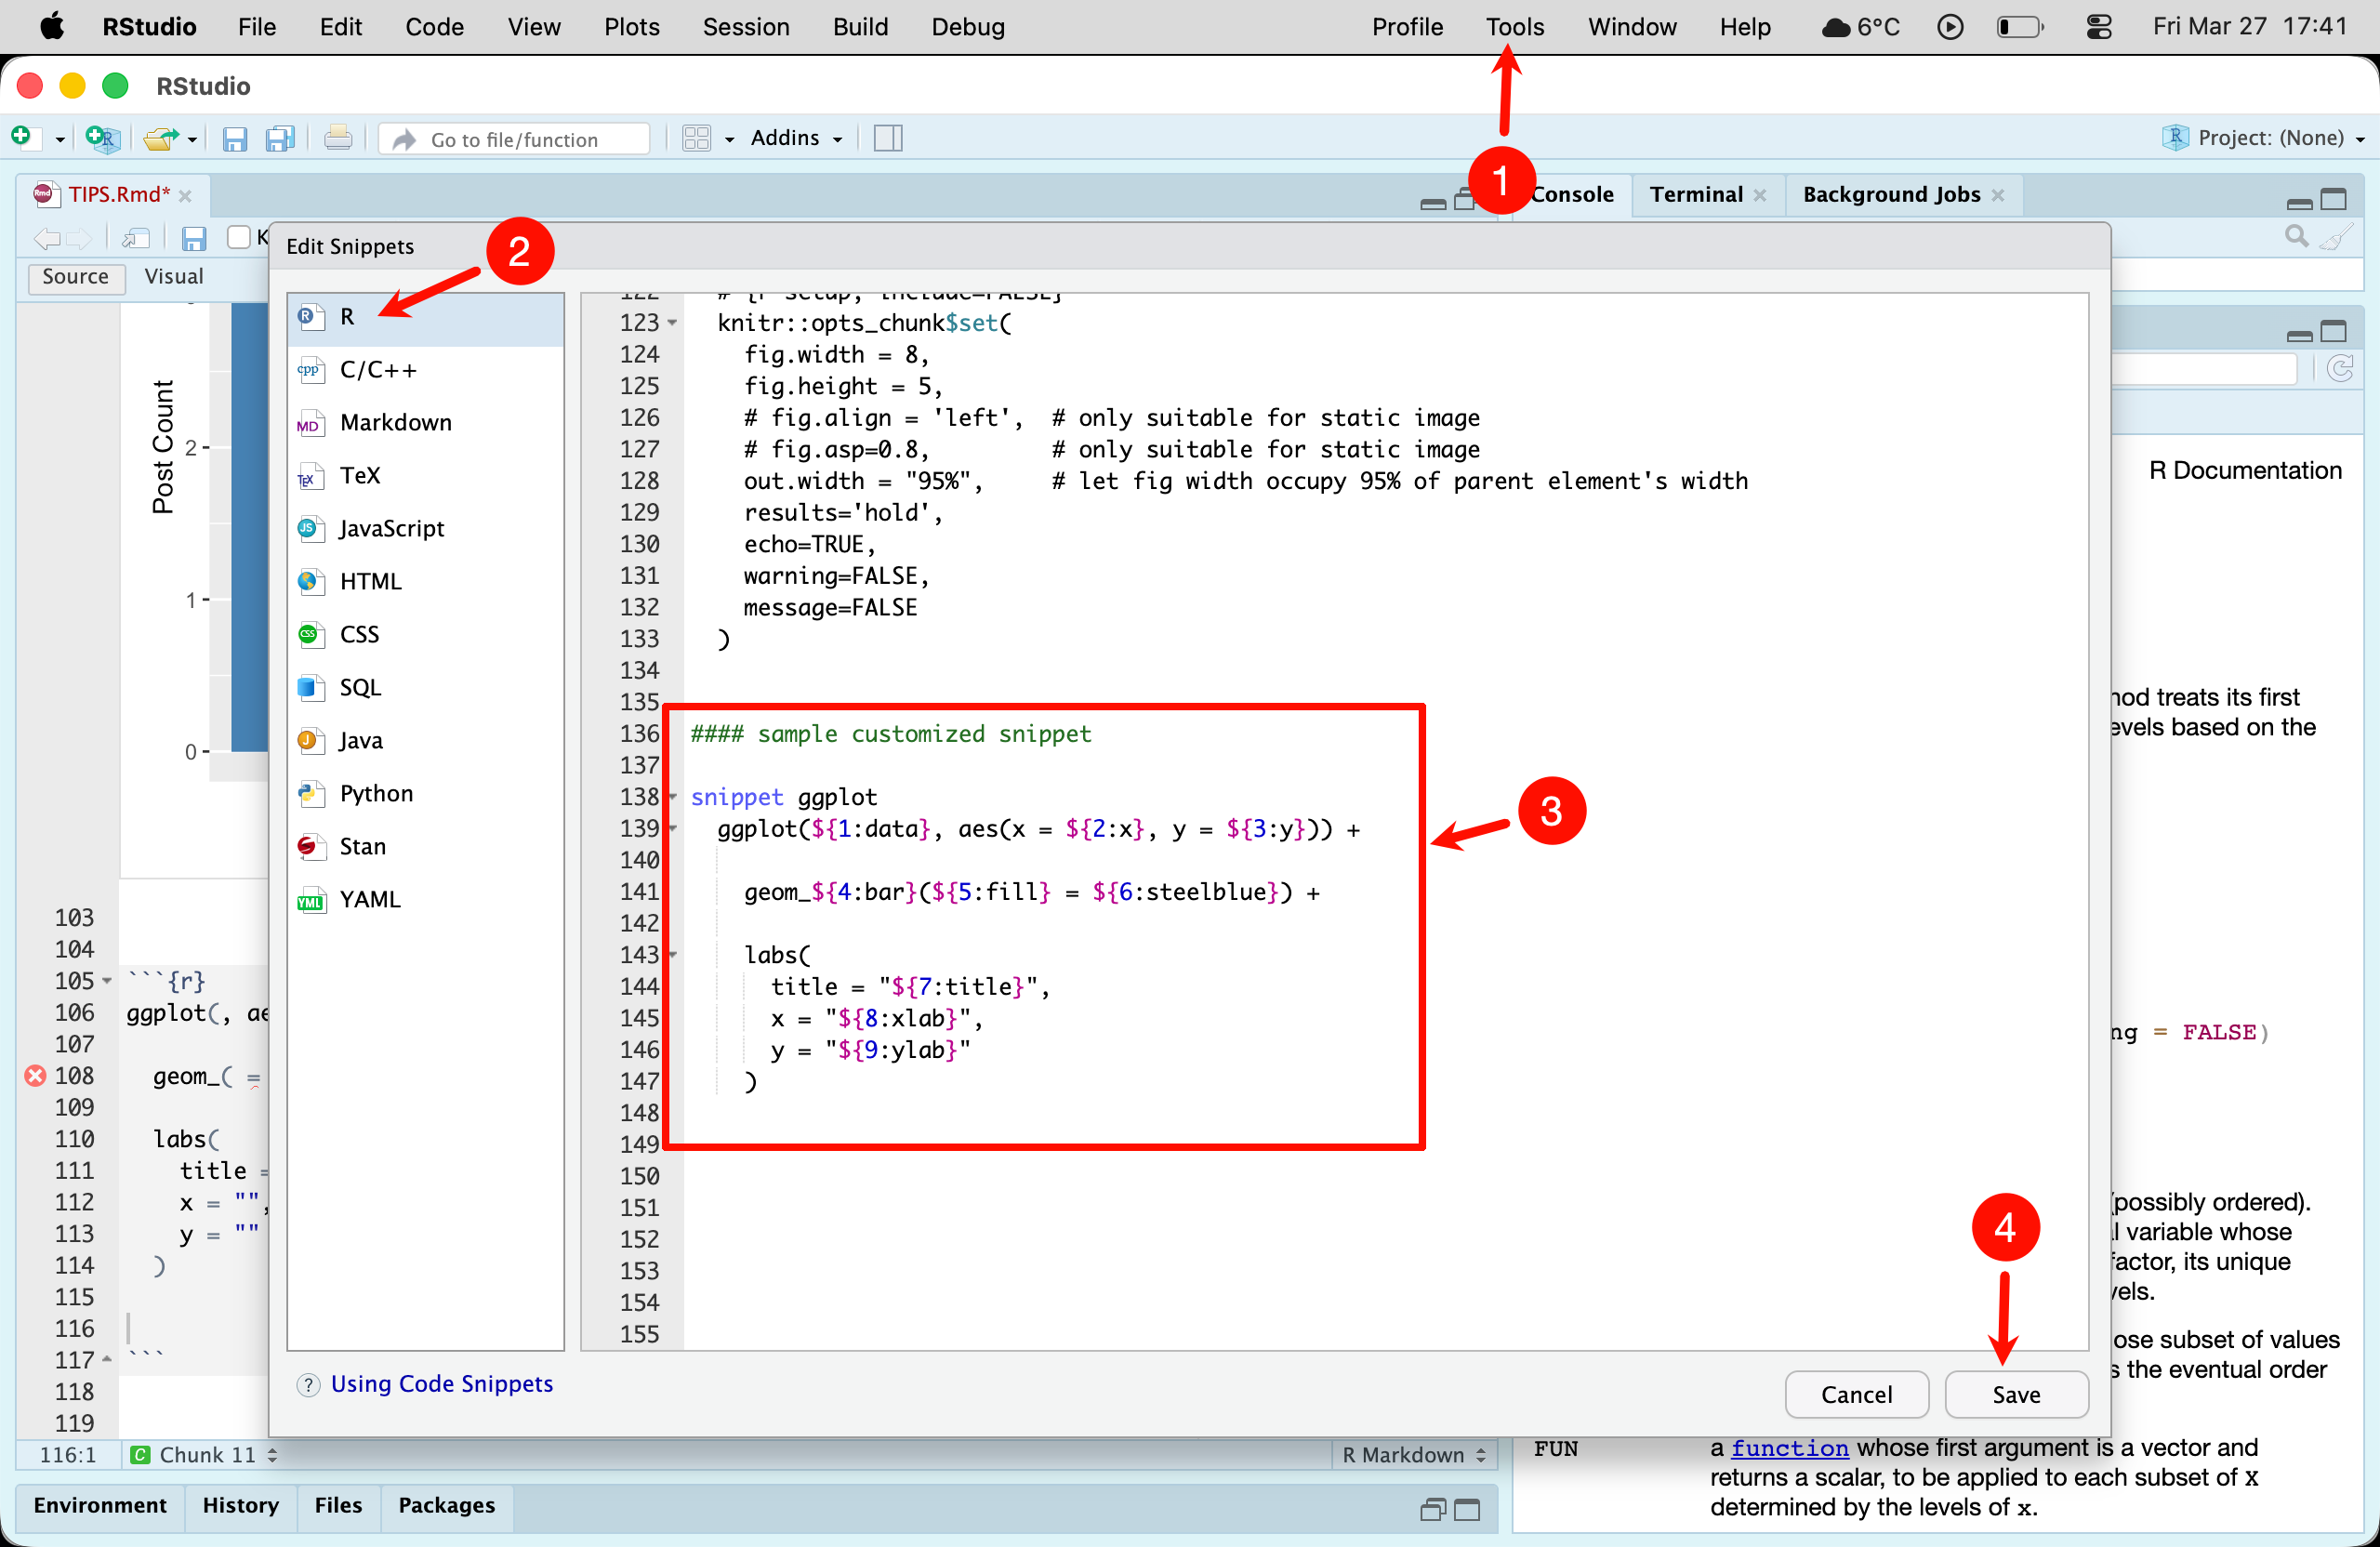
例如 ggplot 画图的模板:
snippet ggplot
    ggplot(${1:data}, aes(x = ${2:x}, y = ${3:y})) +
        geom_${4:bar}(${5:fill} = "${6:steelblue}") +
        labs(
            title = "${7:title}",
            x = "${8:xlab}",
            y = "${9:ylab}"
        )
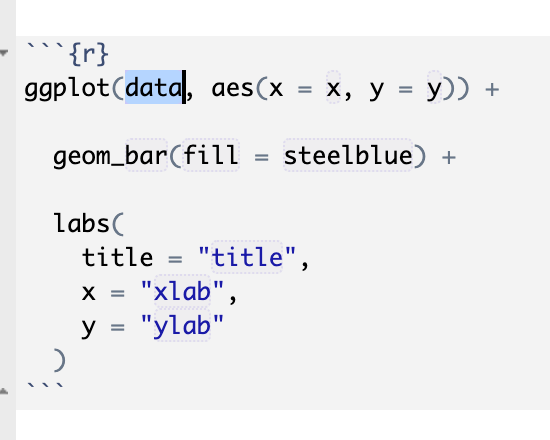
保存成功后, 在 R 代码块里输入 ggplot, 选择 snippet:
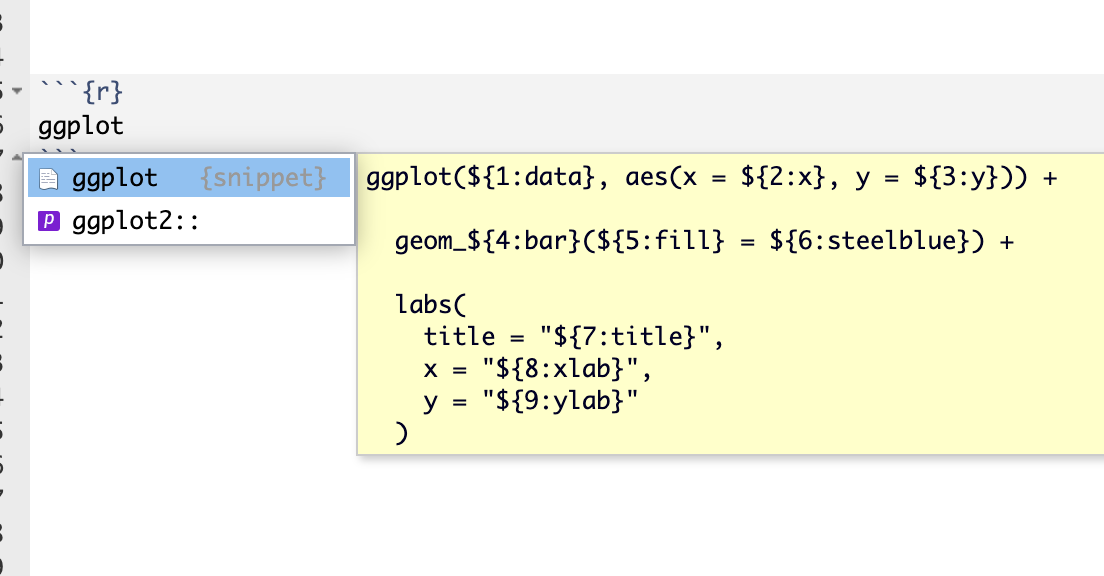
按回车, 自动嵌入模板: