环境与版本
R==4.5.2
MASS==7.3.65
tidyverse==2.0.0
tidytext==0.4.3
textdata==0.4.5
topicmodels==0.2.17
scales==1.4.0
broom==1.0.12
textutils==0.4.3
knitr==1.51R==4.5.2
MASS==7.3.65
tidyverse==2.0.0
tidytext==0.4.3
textdata==0.4.5
topicmodels==0.2.17
scales==1.4.0
broom==1.0.12
textutils==0.4.3
knitr==1.51过去几年间,人工智能(AI)的快速发展从根本上改变了技术融入日常生活的方式,重塑了各行各业、沟通方式以及公共话语的形态 (Stone 等, 2022)。随着AI从一个小众技术领域演变为广受讨论的社会现象,围绕它的公众舆论在各数字平台上显著扩展。社交媒体,尤其是Twitter(现更名为X),在这一转变中发挥了核心作用,为用户、创始人个人及各类机构提供了积极讨论、评估和协商AI技术意义与影响的空间 (Bruns & Highfield, 2015)。在此背景下,Twitter数据为我们理解人们对AI的认知与观点如何随时间演变提供了宝贵视角,尤其是在技术快速进步时期。通过计算社会数据分析方法对此类话语展开研究,对社会科学领域具有重要意义,使研究者得以系统地考察技术创新如何在社会中被解读、辩论、协商与文化整合。
尽管学界对AI相关传播的关注日益增多,但针对公众话语如何伴随AI工具主流化进程纵向演变的研究相对匮乏 (Cave 等, 2019)。现有研究大多聚焦于通过问卷调查或短期数据集测量的公众认知或态度 (Cave 等, 2019),难以捕捉随时间推移而发生的关注焦点、话语框架和情感反应的动态变化。为弥补这一不足,本研究考察了2017至2021年间Twitter上的AI相关话语,这一时期AI工具的应用得到了显著扩展。通过分析大规模推文数据,本研究旨在识别主题结构与情感模式随时间的变化规律,以及这些变化如何反映更宏观的社会文化转变。
为此,本研究围绕以下两个研究问题展开:
2017至2021年间,随着AI技术走向主流,Twitter上AI相关话语的核心主题与议题如何演变?
所识别的主题与特定情感极性如何与用户互动(如点赞、回复和转推数)相关联?
为回答上述研究问题,本研究采用了一个经过整理与匿名处理的大规模数据集,该数据集通过Twitter API收集了2017至2021年间的AI相关推文,包含互动指标、话题标签、语言及时间特征等元数据,可支持公众话语、情感与主题演变方面的研究 (Marcellis-Warin 等, 2025)。本研究的分析单元为每条推文及其关联的元数据。
library(MASS)         # glm.nb — 在加载 tidyverse 之前加载,以避免命名冲突
library(tidyverse)    # readr, tidyr, tibble, dplyr, ggplot2, lubridate 等
library(tidytext)     # 文本分析(分词)
library(textdata)     # 情感词典
library(topicmodels)  # 主题建模
library(scales)       # 坐标轴刻度
library(broom)        # tidy() 模型输出

# 导入数据集
data0 <- read_csv("../../../src/data/tweets_ai.csv")

# 查看结构
glimpse(data0)
Rows: 893,076
Columns: 19
$ id <dbl> 8.265808e+17, 8.265807e+17, 8.265806e+17, 8.265806e+17…
$ conversation_id <dbl> 8.265808e+17, 8.265807e+17, 8.265806e+17, 8.265806e+17…
$ created_at <chr> "2017-01-31 18:59:44 EST", "2017-01-31 18:59:35 EST", …
$ date <date> 2017-01-31, 2017-01-31, 2017-01-31, 2017-01-31, 2017-…
$ time <time> 18:59:44, 18:59:35, 18:59:14, 18:59:01, 18:59:01, 18:…
$ timezone <dbl> -400, -400, -400, -400, -400, -400, -400, -400, -400, …
$ tweet <chr> "What topic could spark human dialogue on AI? Artifici…
$ language <chr> "en", "en", "en", "en", "en", "en", "en", "en", "en", …
$ urls <chr> "['https://blog.hubspot.com/marketing/artificial-intel…
$ photos <chr> "[]", "[]", "[]", "[]", "[]", "[]", "['https://pbs.twi…
$ replies_count <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ retweets_count <dbl> 0, 4, 1, 0, 0, 0, 1, 0, 0, 0, 0, 0, 2, 0, 0, 0, 0, 0, …
$ likes_count <dbl> 0, 1, 0, 0, 0, 0, 2, 0, 1, 0, 0, 1, 1, 0, 0, 0, 1, 0, …
$ hashtags <chr> "[]", "['artificialintelligence', 'ai', 'chasmwaxing']…
$ cashtags <chr> "[]", "[]", "[]", "[]", "[]", "[]", "[]", "[]", "[]", …
$ retweet <lgl> FALSE, FALSE, FALSE, FALSE, FALSE, FALSE, FALSE, FALSE…
$ quote_url <chr> NA, NA, NA, NA, NA, NA, NA, NA, NA, "https://twitter.c…
$ video <dbl> 0, 0, 0, 0, 0, 0, 1, 1, 0, 0, 0, 1, 0, 0, 1, 1, 1, 1, …
$ thumbnail <chr> NA, NA, NA, NA, NA, NA, "https://pbs.twimg.com/media/C…cat("原始观测数:", nrow(data0), "\n")
cat("原始变量数:", length(data0), "\n")原始观测数: 893076
原始变量数: 19 为便于分析,本研究通过保留英语原创推文(排除转推)来缩减样本规模,并按发帖年份进行分层抽样,样本量为3,000条,以在保证足够分析样本的前提下兼顾计算效率(筛选过程详见附录)。
# 查看语言分布
data0 |>
  count(language, sort = TRUE) |>
  head(4)

cat("\n")

# 查看原创性
data0 |> count(retweet)
# A tibble: 4 × 2
language n
<chr> <int>
1 en 833879
2 fr 16259
3 und 12504
4 es 5557
# A tibble: 1 × 2
retweet n
<lgl> <int>
1 FALSE 893076# 仅保留英语原创推文
data <- data0 |>
filter(language == "en" & retweet == FALSE)
cat("预处理后观测数:", nrow(data), "\n")预处理后观测数: 833879 # 检查日期列的缺失值
cat("日期列存在缺失值:", anyNA(data$date), "\n")日期列存在缺失值: FALSE # 按年份查看观测数
data |>
group_by(year = year(date)) |>
count(year)# A tibble: 5 × 2
# Groups: year [5]
year n
<dbl> <int>
1 2017 305247
2 2018 216067
3 2019 204567
4 2020 77905
5 2021 30093# 按年份等比例分层随机抽样
N <- 3000
st_size <- N / length(unique(year(data$date))) # 各层样本量
set.seed(32)
data <- data |>
group_by(year = year(date)) |>
slice_sample(n = st_size) |>
ungroup()原始数据集包含多个变量,如每条推文的文本内容、时间与互动指标等元数据以及话题标签。变量的多元性使多维度社会数据分析成为可能。本研究使用从原始变量衍生的7个变量,包括推文文本内容、话题标签、现金标签、发帖日期以及点赞、回复和转推计数(详细描述见@tbl-data-doc)。具体而言,原始发帖日期变量经预处理并标准化为协调世界时(UTC),存储于新变量date_utc中;原推文文本内容变量重命名为text。
| 变量 | 数据类型 | 描述 |
|---|---|---|
date_utc |
日期 | 每条推文的发帖日期,格式为 yyyy-mm-dd(UTC时区) |
text |
字符 | 每条推文的文本内容 |
hashtags |
字符 | 每条推文包含的话题标签列表 |
cashtags |
字符 | 每条推文包含的现金标签列表(如股票代码) |
likes_count |
数值 | 每条推文获得的点赞数 |
replies_count |
数值 | 每条推文获得的回复数 |
retweets_count |
数值 | 每条推文被转推的次数 |
# 发帖日期信息列
str(data[["created_at"]])
chr [1:3000] "2017-08-29 15:18:24 EDT" "2017-03-27 18:42:13 EDT" ...# 检查唯一时区后缀
data |>
mutate(suffix = str_sub(created_at, -3, -1)) |>
count(suffix, sort = TRUE)# A tibble: 2 × 2
suffix n
<chr> <int>
1 EDT 1710
2 EST 1290# 将发帖日期标准化为 UTC
data <- data |>
mutate(
created_at_ct = ymd_hms(created_at, tz = "America/New_York"),
date_utc = date(with_tz(created_at_ct, tzone = "UTC"))
)# 仅保留待用变量
data <- data |>
mutate(text = tweet) |>
select(
date_utc, text, hashtags, cashtags,
likes_count, replies_count, retweets_count
)
cat("观测数:", nrow(data), "\n")
cat("变量数:", length(data), "\n")
cat("数据存在缺失值:", anyNA(data), "\n")观测数: 3000
变量数: 7
数据存在缺失值: FALSE str(data)tibble [3,000 × 7] (S3: tbl_df/tbl/data.frame)
$ date_utc : Date[1:3000], format: "2017-08-29" "2017-03-27" ...
$ text : chr [1:3000] "Brands Can’t Afford to Underestimate the Power of Artificial Intelligence, OMD’s Retail Revolution https://t.c"| __truncated__ "NASA : One of our planet’s few exposed lava lakes is changing, and artificial intelligence… https://t.co/h7Lp7"| __truncated__ "Artificial intelligence to be showcased in Guangzhou - Business - https://t.co/Qk6gmORE4m https://t.co/NsuAj"| __truncated__ "Artificial Intelligence: Implications On Marketing, Analytics, And You https://t.co/v8p1metjJE via @avinash vi"| __truncated__ ...
$ hashtags : chr [1:3000] "['ai', 'ml', 'dl']" "[]" "['ai', 'ml', 'dl']" "[]" ...
$ cashtags : chr [1:3000] "[]" "[]" "[]" "[]" ...
$ likes_count : num [1:3000] 0 0 0 0 0 3 0 0 0 0 ...
$ replies_count : num [1:3000] 0 0 0 0 0 0 0 0 0 0 ...
$ retweets_count: num [1:3000] 0 0 0 0 1 3 1 0 0 1 ...表 2 展示了数值变量的描述性统计。作为补充,表 3 呈现了这些数值变量中零值与非零值的计数与比例。
三项互动指标(点赞、回复和转推计数)的描述性统计均呈现高度偏态分布,表明数据集中大多数推文未获得任何互动。其中,点赞是最常见的互动形式,均值为3.04,40.40%的推文至少获得一个点赞;转推紧随其后,均值为2.35,非零值比例为41.40%。回复则明显稀少,仅7.07%的推文收到回应,均值仅为0.14。较大的标准差,加上第75百分位数值(0或1)与最大值(898个点赞、83条回复、367次转推)之间的显著差距,表明存在少量病毒式传播的推文,不成比例地拉高了平均值。
num_vars <- c("likes_count", "replies_count", "retweets_count")

# 计算各数值变量的汇总统计并转为长格式
num_stats_table <- data |>
  summarise(across(
    all_of(num_vars),
    list(
      mean   = ~round(mean(.x, na.rm = TRUE), 2),
      sd     = ~round(sd(.x, na.rm = TRUE), 2),
      min    = ~min(.x, na.rm = TRUE),
      q1     = ~quantile(.x, 0.25, na.rm = TRUE),
      median = ~median(.x, na.rm = TRUE),
      q3     = ~quantile(.x, 0.75, na.rm = TRUE),
      max    = ~max(.x, na.rm = TRUE)
    ),
    .names = "{.col}###{.fn}"
  )) |>
  # "###" 是用于在 pivot_longer 中分割 "col###stat" 的安全分隔符
  pivot_longer(
    everything(),
    names_to  = c("Variable", ".value"),
    names_sep = "###"
  )

knitr::kable(
  num_stats_table |>
    rename(
      变量 = Variable,
      均值 = mean, 标准差 = sd, 最小值 = min,
      `25%分位数` = q1, 中位数 = median, `75%分位数` = q3, 最大值 = max
    ),
  align = c('l', 'c', 'c', 'c', 'c', 'c', 'c', 'c'),
  caption = "数值变量描述性统计摘要"
)| 变量 | 均值 | 标准差 | 最小值 | 25%分位数 | 中位数 | 75%分位数 | 最大值 |
|---|---|---|---|---|---|---|---|
| likes_count | 3.04 | 23.28 | 0 | 0 | 0 | 1 | 898 |
| replies_count | 0.14 | 1.65 | 0 | 0 | 0 | 0 | 83 |
| retweets_count | 2.35 | 11.12 | 0 | 0 | 0 | 1 | 367 |
# 统计各互动指标的零值与非零值数量
zero_counts_table <- data |>
  summarise(across(
    all_of(num_vars),
    list(
      zero         = ~sum(.x == 0, na.rm = TRUE),
      non_zero     = ~sum(.x > 0, na.rm = TRUE),
      pct_non_zero = ~round(sum(.x > 0, na.rm = TRUE) / n() * 100, 2)
    ),
    .names = "{.col}###{.fn}"
  )) |>
  pivot_longer(
    everything(),
    names_to  = c("Variable", ".value"),
    names_sep = "###"
  )

knitr::kable(
  zero_counts_table |>
    rename(
      变量 = Variable,
      `零值计数`    = zero,
      `非零值计数`  = non_zero,
      `非零值比例 (%)` = pct_non_zero
    ),
  caption = "数值变量的零值与非零值统计"
)| 变量 | 零值计数 | 非零值计数 | 非零值比例 (%) |
|---|---|---|---|
| likes_count | 1787 | 1213 | 40.43 |
| replies_count | 2788 | 212 | 7.07 |
| retweets_count | 1759 | 1241 | 41.37 |
本研究涉及的日期变量为date_utc,由原始变量created_at衍生并标准化为UTC(转换过程详见附录)。该变量的时间范围从2017年1月27日至2021年7月19日,共跨越5年(1,634天)。
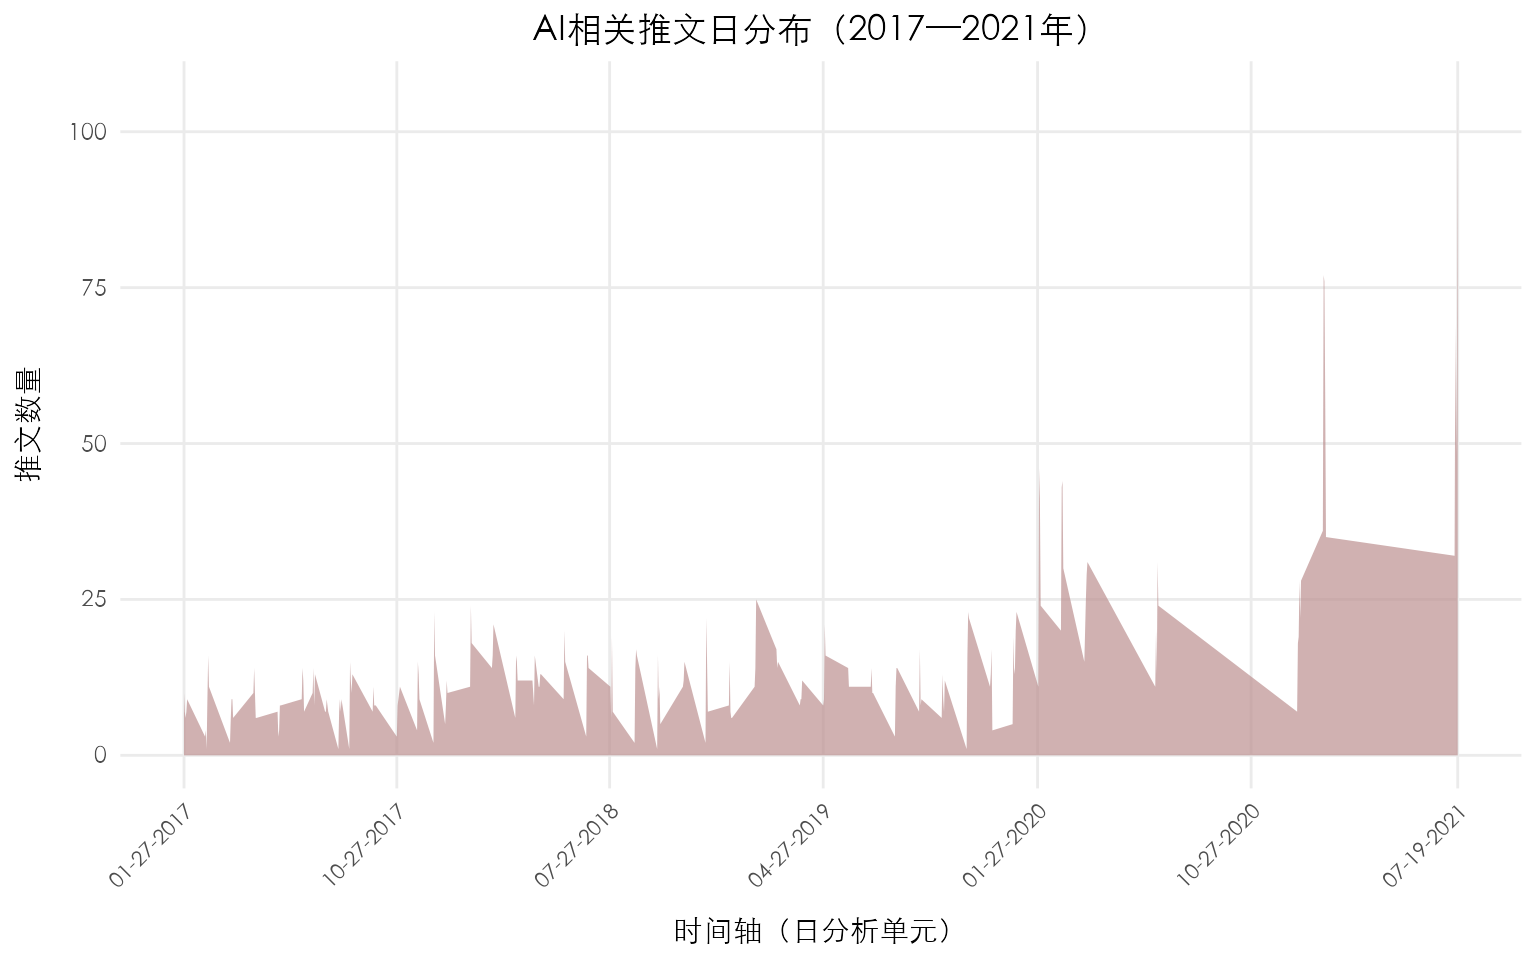
本研究的时间分析单元为每天。图 1 展示了推文的日分布情况,x轴显示数据集的时间范围(2017年1月27日至2021年7月19日),y轴表示每日观测到的推文数量。总体而言,数据集早期年份的推文量相对较低且较为稳定,每日通常波动在0至20条之间;在2020至2021年前后出现了明显的活跃度上升,出现了若干显著峰值,其中有一天的推文量接近100条,表明观测期末段公众对AI相关话语的关注度显著提升。
cat("日期范围(yyyy-mm-dd):\n",
    as.character(range(data$date_utc)[1]), "至",
    as.character(range(data$date_utc)[2]), "\n")
max(data$date_utc) - min(data$date_utc)
日期范围(yyyy-mm-dd):
2017-01-27 至 2021-07-19
Time difference of 1634 daysdaily_count <- data |>
count(date_utc)
min_date <- min(daily_count$date_utc)
max_date <- max(daily_count$date_utc)
# 明确包含两端端点,使坐标轴始终显示实际起止日期
x_breaks <- sort(unique(c(
min_date,
seq(min_date, max_date, by = "9 months"), max_date))
)
ggplot(daily_count, aes(x = date_utc, y = n)) +
geom_area(fill = "rosybrown", alpha = 0.7) +
scale_x_date(breaks = x_breaks, date_labels = "%m-%d-%Y") +
labs(
title = "AI相关推文日分布(2017—2021年)",
x = "时间轴(日分析单元)",
y = "推文数量"
) +
theme_minimal() +
theme(
axis.text.x = element_text(angle = 45, hjust = 1, size = 8),
axis.title.x = element_text(margin = margin(t = 10)),
axis.title.y = element_text(margin = margin(r = 10)),
panel.grid.minor = element_blank(),
plot.title = element_text(hjust = 0.5)
)
本研究涉及三个文本变量:text、hashtags和cashtags。
text变量包含每条推文的唯一文本内容,无缺失值(NA)也无空内容(空字符串""),样本量为3,000条。text变量中唯一值的数量为2,995。例如,"Brands Can't Afford to Underestimate the Power of Artificial Intelligence, OMD's Retail Revolution https://t.co/l1hSywqKgM #ai #ml #dl"即为其中一个值。
cat("空推文数量:", sum(data$text == ""), "\n")
cat("唯一推文数量:", length(unique(data$text)), "\n\n")
cat("前6条唯一推文:\n")
head(unique(data$text))
空推文数量: 0
唯一推文数量: 2995
前6条唯一推文:
[1] "Brands Can’t Afford to Underestimate the Power of Artificial Intelligence, OMD’s Retail Revolution https://t.co/l1hSywqKgM #ai #ml #dl"
[2] "NASA : One of our planet’s few exposed lava lakes is changing, and artificial intelligence… https://t.co/h7Lp70dYlv) https://t.co/JFljeXzLE0"
[3] "Artificial intelligence to be showcased in Guangzhou - Business - https://t.co/Qk6gmORE4m https://t.co/NsuAjIJiAo #ai #ml #dl"
[4] "Artificial Intelligence: Implications On Marketing, Analytics, And You https://t.co/v8p1metjJE via @avinash via @avinash https://t.co/SojmDRiXk6"
[5] "#ArtificialIntelligence #AI Automation high on employers' agenda as skills gaps set to bite - CIPD (blog) https://t.co/mtAfFTvA16 https://t.co/SNKDxkSUeT"
[6] "Surden on Values Embedded in Legal Artificial Intelligence @HarrySurden https://t.co/vBkBoWU1Nz" hashtags是另一个文本变量,包含每条推文中以#符号开头的小写话题标签列表(原始推文中的所有话题标签均已转为小写),无缺失值(NA)。具体而言,该变量包含2,059个非空值(即2,059条观测包含一个或多个话题标签),其中有1,539个非空唯一值(不含"[]")。例如,"['ai', 'ml', 'dl']"和"['artificialintelligence', 'ai']"是其中的两个值。
此外,由于每条推文可包含多个话题标签,各值被拆分为单个话题标签以获取更细粒度的洞察(拆分过程详见附录)。统计发现,共有2,382个非空唯一单个话题标签,例如"ai"和"ml"是其中的两个。
# 统计非空话题标签值及唯一值数量
unique_hashtags <- data |>
  filter(hashtags != "[]") |>
  select(hashtags) |>
  count(hashtags)

cat("非空话题标签数量:", sum(data$hashtags != "[]"), "\n")
cat("唯一非空话题标签数量:", nrow(unique_hashtags), "\n\n")
cat("前6个唯一话题标签:\n")
head(unique(data$hashtags))
非空话题标签数量: 2059
唯一非空话题标签数量: 1539
前6个唯一话题标签:
[1] "['ai', 'ml', 'dl']"
[2] "[]"
[3] "['artificialintelligence', 'ai']"
[4] "['summer', 'artificialintelligence', 'ai']"
[5] "['artificialintelligence', 'ai', 'nlp', 'ecommerce']"
[6] "['ai']" # 查找唯一单个话题标签
single_hashtags <- data |>
mutate(single_hashtags = str_remove_all(hashtags, "[\\[\\]']")) |>
separate_rows(single_hashtags, sep = ",\\s*") |>
filter(single_hashtags != "") |>
count(single_hashtags)
cat("非空唯一单个话题标签数量:", nrow(single_hashtags), "\n\n")
cat("前6个非空唯一单个话题标签:\n")
head(unique(single_hashtags$single_hashtags))非空唯一单个话题标签数量: 2382
前6个非空唯一单个话题标签:
[1] "004nino" "100daysofcod" "100daysofcode" "100daysofmlcode"
[5] "10xgrowth" "1trendstoday" 类似地,cashtags变量包含每条推文中的小写现金标签列表,即Twitter(现X)上可点击的金融代码符号,由股票或加密货币缩写加$前缀构成。该变量无缺失值(NA),共有22个非空值(即22条观测包含一个或多个现金标签)和18个非空唯一值。例如,"['aieq', 'bikr']"和"['blk']"是其中的两个值。此外,共有23个非空唯一单个现金标签,如"ark"、"blk"和"btc"。
# 统计非空现金标签值及唯一值数量
unique_cashtags <- data |>
  filter(cashtags != "[]") |>
  select(cashtags) |>
  count(cashtags)

cat("非空现金标签数量:", sum(data$cashtags != "[]"), "\n")
cat("非空唯一现金标签数量:", nrow(unique_cashtags), "\n\n")
cat("前6个唯一现金标签:\n")
head(unique(data$cashtags))
非空现金标签数量: 22
非空唯一现金标签数量: 18
前6个唯一现金标签:
[1] "[]" "['v']" "['blk']" "['infy']"
[5] "['aieq', 'bikr']" "['qlys']" # 去除列表格式,将每个现金标签拆分为独立行
single_cashtags <- data |>
mutate(single_cashtags = str_remove_all(cashtags, "[\\[\\]']")) |>
separate_rows(single_cashtags, sep = ",\\s*") |>
filter(single_cashtags != "") |>
count(single_cashtags)
cat("非空唯一单个现金标签数量:", nrow(single_cashtags), "\n\n")
cat("非空唯一单个现金标签(前若干个):\n")
head(unique(single_cashtags$single_cashtags))非空唯一单个现金标签数量: 23
非空唯一单个现金标签(前若干个):
[1] "aieq" "ark" "axxa" "bikr" "blk" "btc" 作为后续分析的预处理步骤,进行文本清洗与分词处理。
# 文本清洗
data <- data |>
mutate(textBU = text) |> # 清洗前备份原始文本
filter(!is.na(text)) |>
mutate(
text = textutils::HTMLdecode(text), # 解码 HTML 实体(如 &)
text = str_to_lower(text), # 标准化为小写
text = str_remove_all(text, "https?://\\S+"), # 去除 URL
text = str_remove_all(text, "\\d+"), # 去除数字
text = str_remove_all(text, "[@]\\w+"), # 去除 @提及
text = str_squish(text) # 合并多余空白
) |>
mutate(
tweet_index = row_number(), # 用于连接的顺序 ID
nwords = str_count(text, "\\w+") # 清洗后的词数
)
head(data$text)[1] "brands can’t afford to underestimate the power of artificial intelligence, omd’s retail revolution #ai #ml #dl"
[2] "nasa : one of our planet’s few exposed lava lakes is changing, and artificial intelligence…"
[3] "artificial intelligence to be showcased in guangzhou - business - #ai #ml #dl"
[4] "artificial intelligence: implications on marketing, analytics, and you via via"
[5] "#artificialintelligence #ai automation high on employers' agenda as skills gaps set to bite - cipd (blog)"
[6] "surden on values embedded in legal artificial intelligence" # 对话题标签分词
hashtag_tokens <- data |>
select(tweet_index, date_utc, hashtags) |>
mutate(hashtag = str_remove_all(hashtags, "[\\[\\]']")) |>
separate_rows(hashtag, sep = ",\\s*") |>
filter(hashtag != "")
# 对现金标签分词
cashtag_tokens <- data |>
select(tweet_index, date_utc, cashtags) |>
mutate(cashtag = str_remove_all(cashtags, "[\\[\\]']")) |>
separate_rows(cashtag, sep = ",\\s*") |>
filter(cashtag != "")
# 推文级标签特征
tag_features <- data |>
select(tweet_index, date_utc, likes_count, replies_count, retweets_count) |>
left_join(
hashtag_tokens |> count(tweet_index, name = "n_hashtag"),
by = "tweet_index"
) |>
left_join(
cashtag_tokens |> count(tweet_index, name = "n_cashtag"),
by = "tweet_index"
) |>
mutate(
n_hashtag = replace_na(n_hashtag, 0L),
n_cashtag = replace_na(n_cashtag, 0L),
has_hashtag = n_hashtag > 0,
has_cashtag = n_cashtag > 0,
year = year(date_utc)
)
tag_features |>
select(tweet_index, n_hashtag, n_cashtag, has_hashtag, has_cashtag) |>
head()# A tibble: 6 × 5
tweet_index n_hashtag n_cashtag has_hashtag has_cashtag
<int> <int> <int> <lgl> <lgl>
1 1 3 0 TRUE FALSE
2 2 0 0 FALSE FALSE
3 3 3 0 TRUE FALSE
4 4 0 0 FALSE FALSE
5 5 2 0 TRUE FALSE
6 6 0 0 FALSE FALSE 在模型估计之前,先进行相关性分析作为探索步骤,以检验主题特征、情感得分与用户互动指标之间的两两关系。这一初步分析有助于识别潜在关联,并为后续建模的变量选择提供依据,同时对数据集内关系的方向与强度形成初步理解。
本研究采用广义线性模型(GLM)构建模型,以考察变量间的关系。选择GLM而非简单线性回归,是因为互动数据包含大量零值,这种分布特征是标准线性模型可能无法充分处理的。通过适应非正态响应分布,GLM为基于计数的社交媒体互动数据提供了更灵活、更合适的建模方法。
在文本分析方面,本研究采用两种互补的计算技术。潜在狄利克雷分配(LDA)主题建模是一种广泛使用的无监督机器学习技术,用于揭示数据集中潜在的主题结构,识别AI相关话语的核心议题。同时,本研究还采用了基于词典的情感分析——一种通过利用预定义词汇资源对情感极性(如正面、负面或中性)进行分类,从而评估文本数据情感倾向的自然语言处理方法——以建立推文的整体情感极性与趋势。此外,词频-逆文档频率(TF-IDF)用于追踪关键AI相关词汇的显著性如何从2017年到2021年发生变化,从而提供词汇变化的纵向视角,反映AI走向主流过程中的语言演变。
这些方法直接支持了探究所识别主题和情感极性与用户互动关联的研究问题:主题建模和情感分析识别潜在主题与情感,TF-IDF则提供数据集中AI相关关键词随时间演变趋势的纵向视角。这些技术共同为后续推断性分析提供依据,通过GLM从统计层面揭示文本变量与互动指标之间的预测关系。
为识别AI相关推文的潜在主题结构,对预处理后的推文语料库应用了LDA。分词后,使用自定义停用词表对推文进行过滤,去除了通用英语停用词、Twitter特定词汇(如"rt"、"tweet")及搜索关键词"artificial intelligence"。TF-IDF过滤器随后保留了出现在超过0.1%但少于75%文档中的词汇,在减少词汇噪声的同时保留了具有信息量的词项。由此生成的文档-词项矩阵作为LDA模型的输入,该模型使用吉布斯采样估计,设置K=5个主题,迭代2,000次,烧入期500次。
# 自定义领域特定停用词
mystopwords <- c(
  stop_words$word,
  "comment", "post",
  "twitter", "tweet", "tweets",
  "rt", "retweet", "retweets",
  "artificial", "intelligence"
)
mystopwords <- tolower(unique(mystopwords))
cat("停用词总数:", length(mystopwords), "\n")

# 分词
tm_token_data <- data |>
  unnest_tokens(word, text) |>
  anti_join(data.frame(word = mystopwords)) |>
  mutate(nchar = nchar(word)) |>
  filter(nchar > 2) |>
  filter(!grepl("[0-9]{1}", word)) |>
  filter(!grepl("\\W", word))

cat("词元总数:", nrow(tm_token_data), "\n")
停用词总数: 738
词元总数: 27565 n_docs_total <- n_distinct(tm_token_data$tweet_index)
# 保留文档频率在 (0.1%, 75%) 范围内的词汇
good_words <- tm_token_data |>
count(tweet_index, word) |>
group_by(word) |>
summarise(doc_freq = n() / n_docs_total, .groups = "drop") |>
filter(doc_freq < 0.75, doc_freq > 0.001)
tm_token_data_pruned <- tm_token_data |>
inner_join(good_words, by = "word")
cat("TF-IDF 过滤后词汇量:", nrow(good_words), "个词\n")
cat("过滤后词元数:", nrow(tm_token_data_pruned), "\n")
# 文档-词项矩阵
tweet_dtm <- tm_token_data_pruned |>
count(tweet_index, word) |>
cast_dtm(tweet_index, word, n)
cat("DTM:", nrow(tweet_dtm), "篇文档 x", ncol(tweet_dtm), "个词项\n")TF-IDF 过滤后词汇量: 1800 个词
过滤后词元数: 20112
DTM: 2961 篇文档 x 1800 个词项set.seed(32)
lda_model <- LDA(
tweet_dtm, k = 5, method = "Gibbs",
control = list(seed = 32, iter = 2000, burnin = 500, verbose = 0)
)
# 持久化到磁盘,使对象在分块缓存失效后依然可用且可被外部访问
save(lda_model, file = "./lda_model_ai.RData")图 2 展示了五个主题中概率(beta值)最高的前10个词汇,为主题解读提供依据。根据词汇分布,各主题标注如下:主题1代表机器人技术与自动化,关键词包括 robotics、automation 和 robot;主题2反映技术、研究与金融市场,涵盖 blockchain、technology、research、market 和 healthcare 等词汇;主题3聚焦数据科学、机器学习与安全,包括 data、learning、machine 和 security 等词项;主题4代表面向商业的AI创新,以 business、future、innovation、digital 和 digitaltransformation 等词为特征;主题5强调AI应用生态词汇,包括 machinelearning、bigdata、datascience、iot 和 deeplearning。
lda_beta <- tidy(lda_model, matrix = "beta")

lda_beta |>
  group_by(topic) |>
  slice_max(beta, n = 10) |>
  ungroup() |>
  mutate(term = reorder_within(term, beta, topic)) |>
  ggplot(aes(beta, term, fill = factor(topic))) +
  geom_col(show.legend = FALSE) +
  facet_wrap(~topic, scales = "free") +
  scale_y_reordered() +
  labs(
    title = "各LDA主题前10高频词(K = 5)",
    x = "Beta(词汇概率)",
    y = NULL
  ) +
  theme_minimal() +
  theme(
    plot.title = element_text(hjust = 0.5)
  )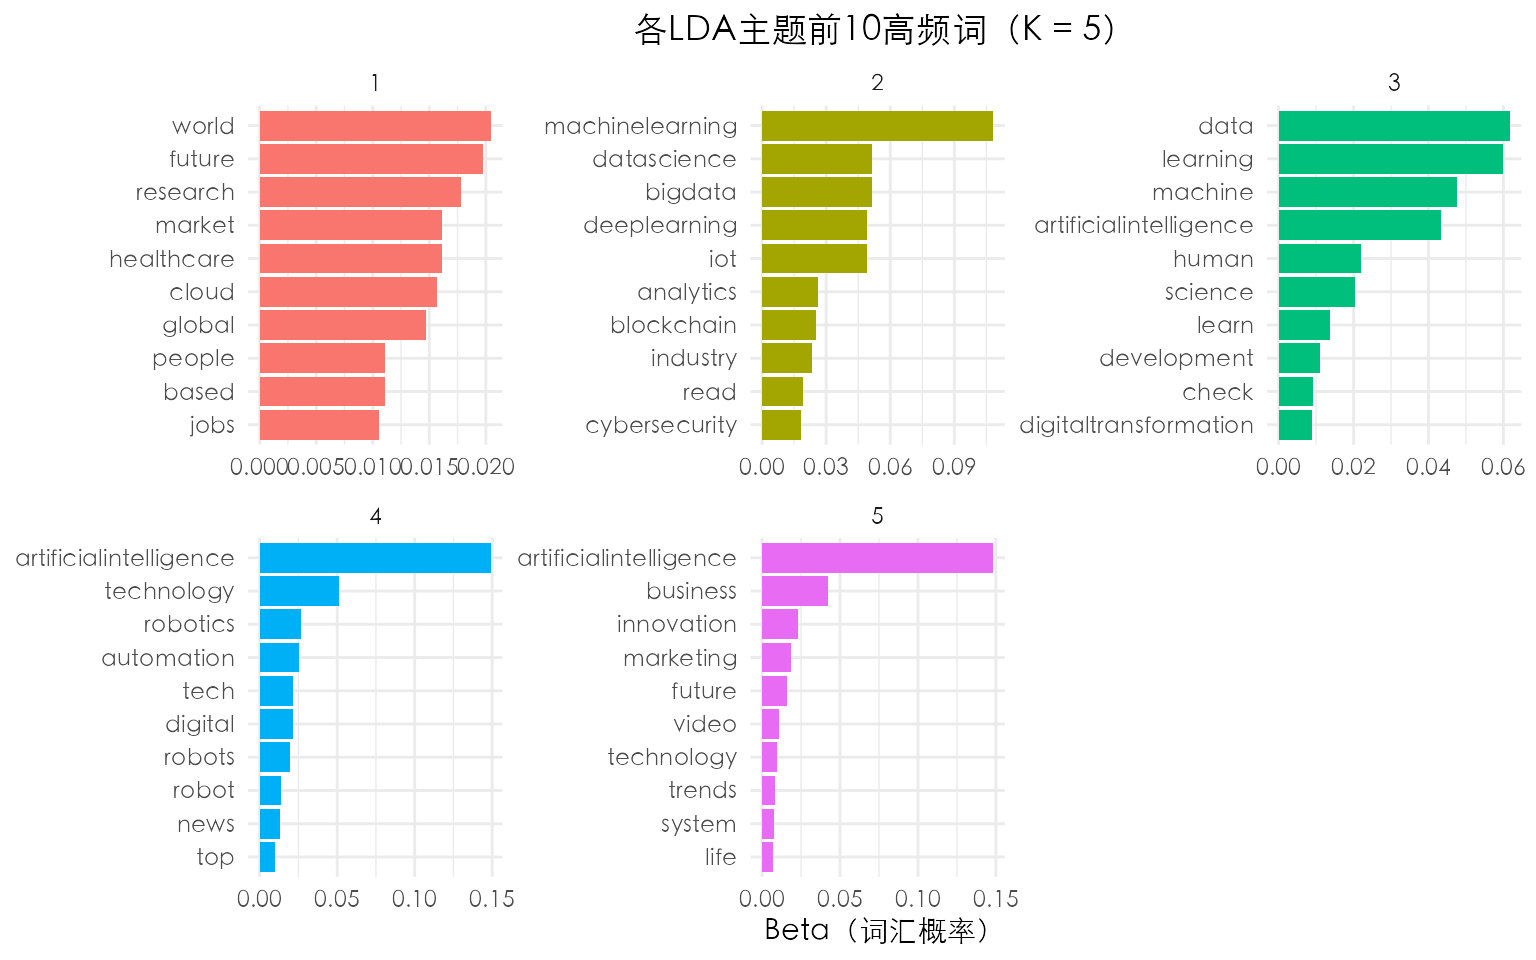
表 4 展示了3,000条抽样推文中主导主题(即每条推文中成员概率最高的主题)的分布情况。主题1(机器人技术与自动化)最为普遍,占推文总数的28.4%,其次为主题2(技术与市场,23.3%)、主题3(数据科学与安全,19.0%)、主题4(商业与创新,15.3%)和主题5(AI生态流行词,14.0%)。分布呈中度不均衡,主题1和主题2合计覆盖超过半数推文。
# gamma矩阵:文档-主题概率
lda_gamma <- tidy(lda_model, matrix = "gamma")

# 转为宽格式并与原始数据合并
gamma_wide <- lda_gamma |>
  mutate(tweet_index = as.integer(document)) |>
  select(-document) |>
  pivot_wider(names_from = topic, values_from = gamma, names_prefix = "topic_")

meta_theta_df <- data |>
inner_join(gamma_wide, by = "tweet_index")# 为每条推文分配主导主题(最高 gamma 值)并统计数量
dominant_dist <- lda_gamma |>
group_by(document) |>
slice_max(gamma, n = 1) |>
ungroup() |>
count(topic) |>
mutate(pct = round(n / sum(n) * 100, 1))
knitr::kable(
dominant_dist |>
rename(
主题 = topic,
`推文数量` = n,
`占比 (%)` = pct
),
align = c('c','c','c'),
caption = "推文中LDA主导主题分布"
)| 主题 | 推文数量 | 占比 (%) |
|---|---|---|
| 1 | 865 | 20.7 |
| 2 | 779 | 18.7 |
| 3 | 837 | 20.1 |
| 4 | 833 | 20.0 |
| 5 | 855 | 20.5 |
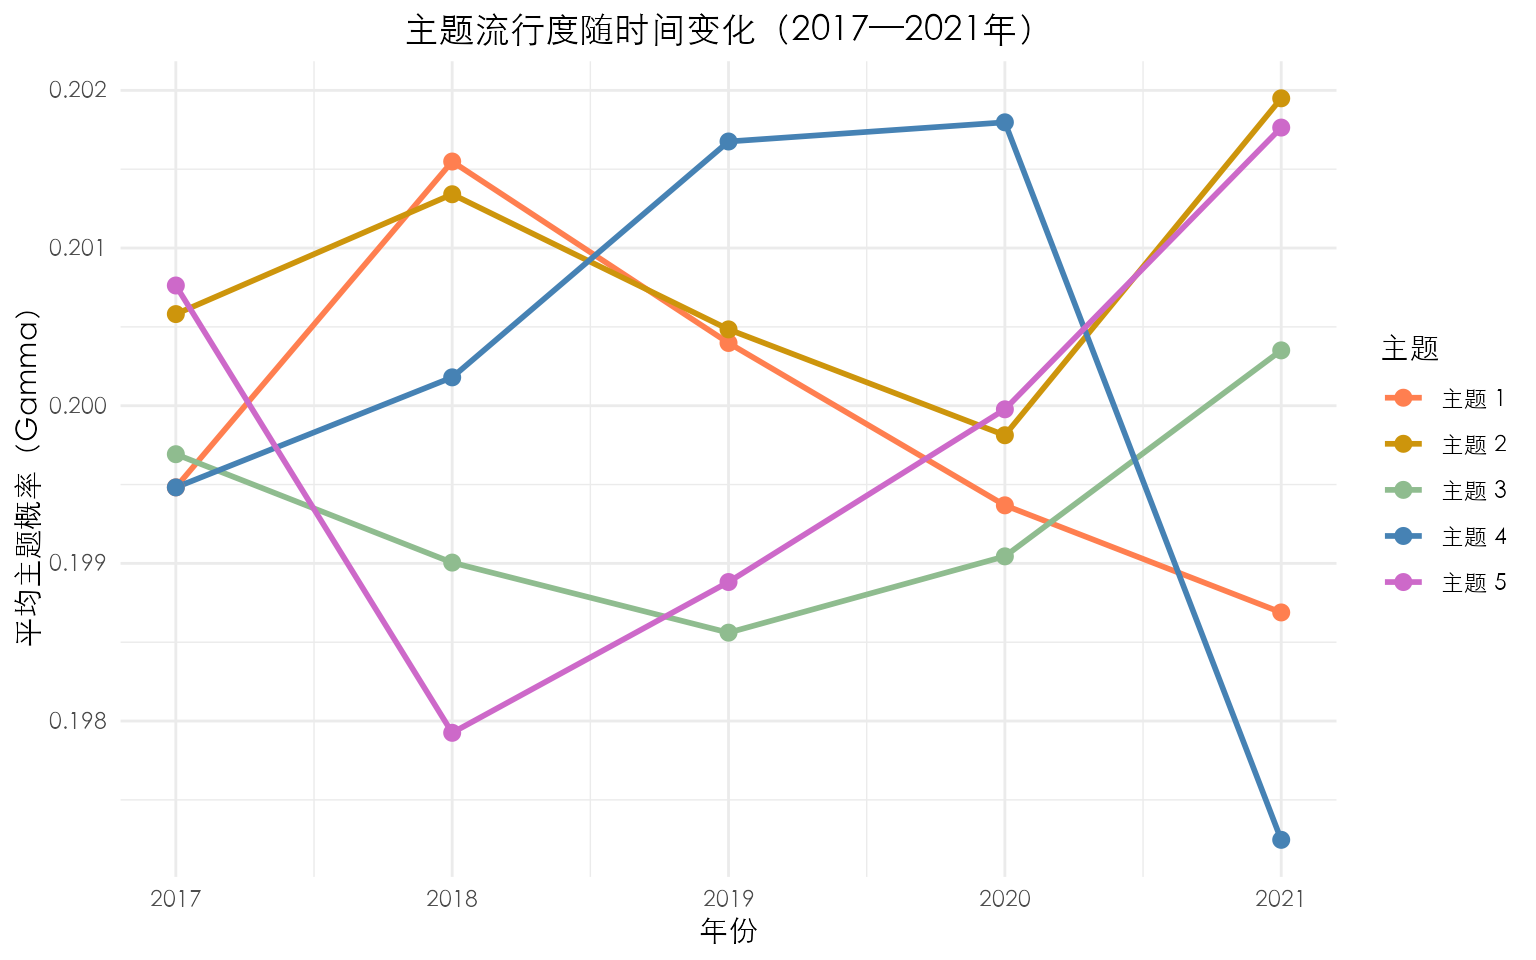
图 3 追踪了2017至2021年各年平均主题概率(gamma值)的变化趋势。值得注意的是,五个主题在整个研究期间的平均概率均接近0.20,表明主题结构随时间推移相对稳定。尽管整体稳定,但仍存在细微的方向性变化:主题4(商业与创新)从2017年到2021年呈现温和上升趋势,主题2(技术与市场)略有下降,主题5(AI生态流行词)到2021年也略有上升。这些模式表明,尽管AI话语的广泛主题平衡格局保持不变,但随着AI走向主流,面向商业和实施的语言逐渐获得了更突出的地位。
# 计算各年每个主题的平均概率(gamma),用于趋势可视化
topics_by_year <- lda_gamma |>
  mutate(tweet_index = as.integer(document)) |>
  left_join(data |> select(tweet_index, date_utc), by = "tweet_index") |>
  mutate(year = year(date_utc)) |>
  group_by(year, topic) |>
  summarise(mean_gamma = mean(gamma), .groups = "drop")

ggplot(topics_by_year, aes(x = year, y = mean_gamma, color = factor(topic))) +
  geom_line(linewidth = 1) +
  geom_point(size = 2.5) +
  scale_x_continuous(breaks = 2017:2021) +
  scale_color_manual(
    values = c(
      "1" = "coral", "2" = "darkgoldenrod3", "3" = "darkseagreen",
      "4" = "steelblue", "5" = "orchid3"
    ),
    labels = paste("主题", 1:5)
  ) +
  labs(
    title = "主题流行度随时间变化(2017—2021年)",
    x = "年份",
    y = "平均主题概率(Gamma)",
    color = "主题"
  ) +
  theme_minimal() +
  theme(
    plot.title = element_text(hjust = 0.5)
  )
话题标签与现金标签分析作为主题模型的补充,考察了用户在AI相关推文中自主使用的显式标签框架。表 5 汇总了话题标签和现金标签的整体使用情况。在3,000条抽样推文中,2,059条(68.6%)包含至少一个话题标签,平均每条推文含3.45个话题标签。相比之下,仅22条推文(0.7%)包含现金标签,平均每条推文仅含0.01个。这一巨大差异表明,通过现金标签进行的金融与市场导向标注在本语料库中处于边缘位置,而话题标签的使用则既普遍又密集。
# 汇总样本中话题标签和现金标签的使用情况
tag_presence_table <- tibble(
  tag_type = c("话题标签", "现金标签"),
  tweets_with_tag = c(
    sum(tag_features$has_hashtag), sum(tag_features$has_cashtag)
  ),
  pct_with_tag    = round(tweets_with_tag / nrow(tag_features) * 100, 1),
  avg_tags_per_tweet = c(
    round(mean(tag_features$n_hashtag), 2),
    round(mean(tag_features$n_cashtag), 2)
  )
)

knitr::kable(
  tag_presence_table |>
    rename(
      `标签类型`              = tag_type,
      `含标签推文数`          = tweets_with_tag,
      `占推文比例 (%)` = pct_with_tag,
      `每条推文平均标签数`   = avg_tags_per_tweet
    ),
  align = 'c',
  caption = "样本中话题标签与现金标签的使用情况"
)| 标签类型 | 含标签推文数 | 占推文比例 (%) | 每条推文平均标签数 |
|---|---|---|---|
| 话题标签 | 2059 | 68.6 | 3.45 |
| 现金标签 | 22 | 0.7 | 0.01 |
表 6 和 图 4 展示了2017至2021年全样本中使用频率最高的15个话题标签。前三名分别为 #artificialintelligence(1,427次)、#ai(1,094次)和 #machinelearning(483次),其后依次为 #bigdata、#datascience、#deeplearning、#iot 和 #ml。这一排名表明,AI推文主要通过技术性和行业性标签加以框架,而非社会、伦理或政治类标签。
# 统计并排序所有单个话题标签;保留前15个
top_hashtags <- hashtag_tokens |>
  count(hashtag, sort = TRUE) |>
  slice_max(n, n = 15)

knitr::kable(
  top_hashtags |> rename(话题标签 = hashtag, 频次 = n),
  align = 'c',
  caption = "AI相关推文中最常用话题标签(2017—2021年)"
)# 前15个最高频话题标签的水平条形图
top_hashtags |>
mutate(hashtag = reorder(hashtag, n)) |>
ggplot(aes(x = n, y = hashtag)) +
geom_col(fill = "darkcyan", alpha = 0.8) +
labs(
title = "AI相关推文中前15个话题标签",
x = "频次", y = NULL
) +
theme_minimal() +
theme(
plot.title = element_text(hjust = 0.5)
)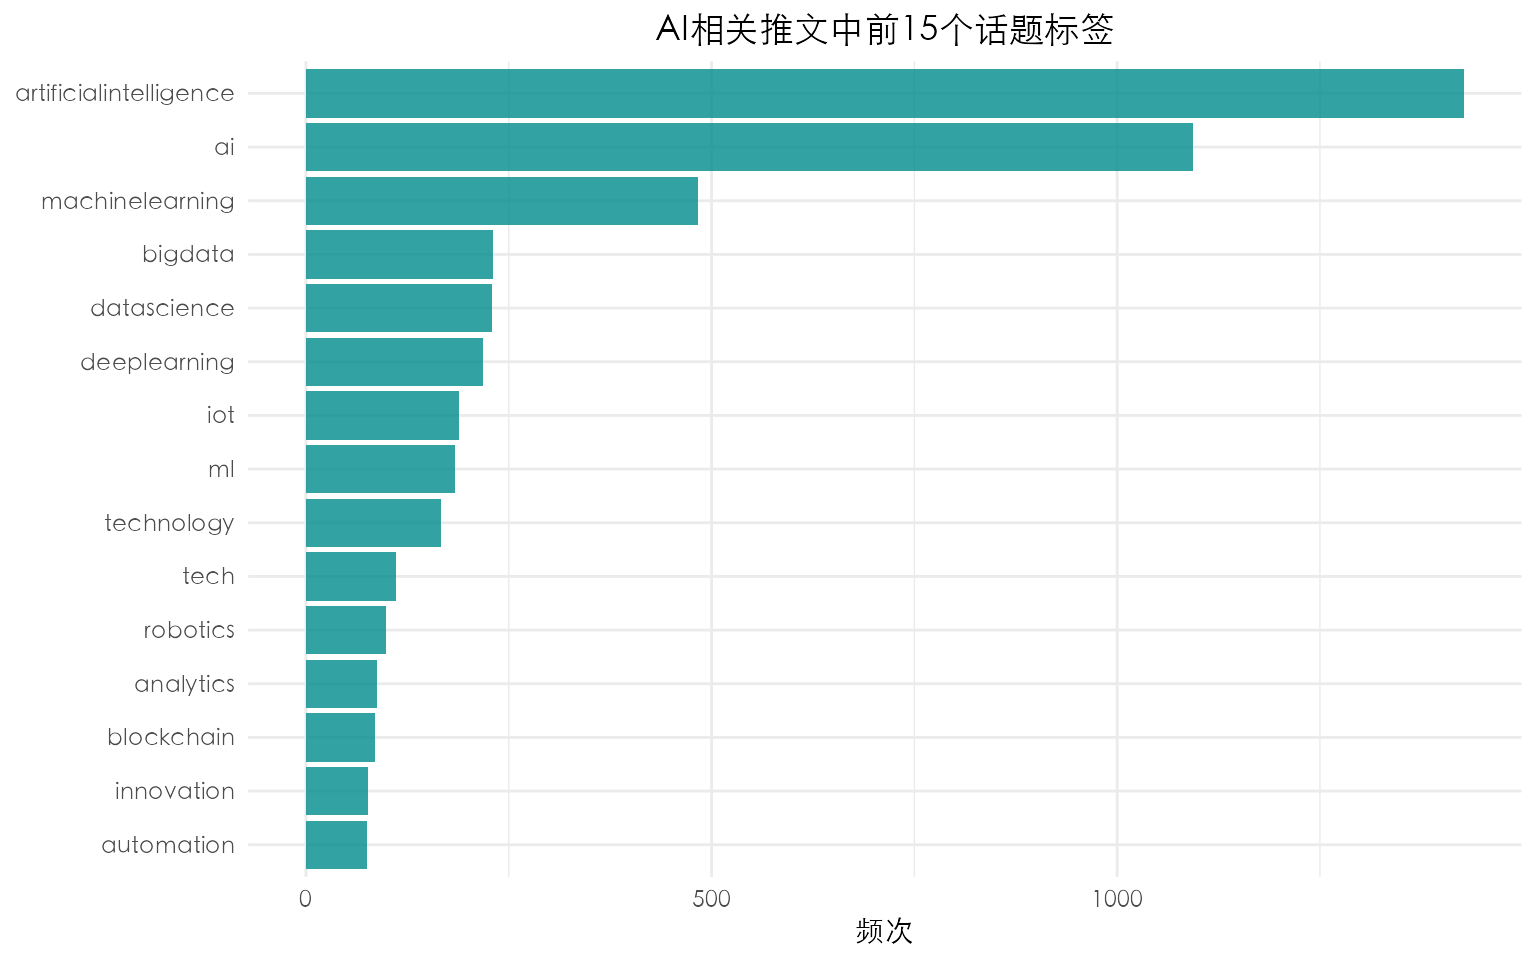
表 7 呈现了各年排名前五的话题标签。#artificialintelligence 和 #ai 在2017至2021年每一年均排名前两位。然而,第三至第五名随时间推移发生了变化:2017年和2018年,#bigdata 和 #iot 较为突出,而到2020年和2021年,#datascience 和 #deeplearning 取而代之。#machinelearning 的使用量稳步增长,从2017年的47次增至2021年的127次。图 5 展示了使用最广泛的8个话题标签的份额趋势,直观地印证了广义AI标签的持续主导地位,以及应用技术子领域标签日益上升的突出性。
# 按年统计话题标签数量,每年保留前5个
top_hashtags_year <- hashtag_tokens |>
  mutate(year = year(date_utc)) |>
  count(year, hashtag, sort = TRUE) |>
  group_by(year) |>
  slice_max(n, n = 5, with_ties = FALSE) |>
  ungroup()

knitr::kable(
  top_hashtags_year |> rename(年份 = year, 话题标签 = hashtag, 频次 = n),
  align = 'c',
  caption = "各年前五话题标签(2017—2021年)"
)| 年份 | 话题标签 | 频次 |
|---|---|---|
| 2017 | artificialintelligence | 226 |
| 2017 | ai | 214 |
| 2017 | machinelearning | 47 |
| 2017 | bigdata | 38 |
| 2017 | iot | 34 |
| 2018 | artificialintelligence | 231 |
| 2018 | ai | 215 |
| 2018 | machinelearning | 76 |
| 2018 | bigdata | 49 |
| 2018 | iot | 43 |
| 2019 | artificialintelligence | 316 |
| 2019 | ai | 229 |
| 2019 | machinelearning | 120 |
| 2019 | bigdata | 53 |
| 2019 | datascience | 52 |
| 2020 | artificialintelligence | 335 |
| 2020 | ai | 217 |
| 2020 | machinelearning | 113 |
| 2020 | datascience | 61 |
| 2020 | deeplearning | 50 |
| 2021 | artificialintelligence | 319 |
| 2021 | ai | 219 |
| 2021 | machinelearning | 127 |
| 2021 | datascience | 77 |
| 2021 | deeplearning | 64 |
# 识别整体使用量最高的8个话题标签
focus_hashtags <- hashtag_tokens |>
  count(hashtag, sort = TRUE) |>
  slice_max(n, n = 8, with_ties = FALSE) |>
  pull(hashtag)

# 计算各话题标签在每年内的使用份额
hashtag_trends <- hashtag_tokens |>
  mutate(year = year(date_utc)) |>
  filter(hashtag %in% focus_hashtags) |>
  count(year, hashtag) |>
  group_by(year) |>
  mutate(pct_year = n / sum(n)) |>
  ungroup()

ggplot(hashtag_trends, aes(x = year, y = pct_year, color = hashtag)) +
  geom_line(linewidth = 1) +
  geom_point(size = 2) +
  scale_x_continuous(breaks = 2017:2021) +
  scale_y_continuous(labels = percent_format(accuracy = 1)) +
  labs(
    title = "各年前8话题标签份额趋势",
    x = "年份",
    y = "话题标签使用份额",
    color = "话题标签"
  ) +
  theme_minimal() +
  theme(
    plot.title = element_text(hjust = 0.5)
  )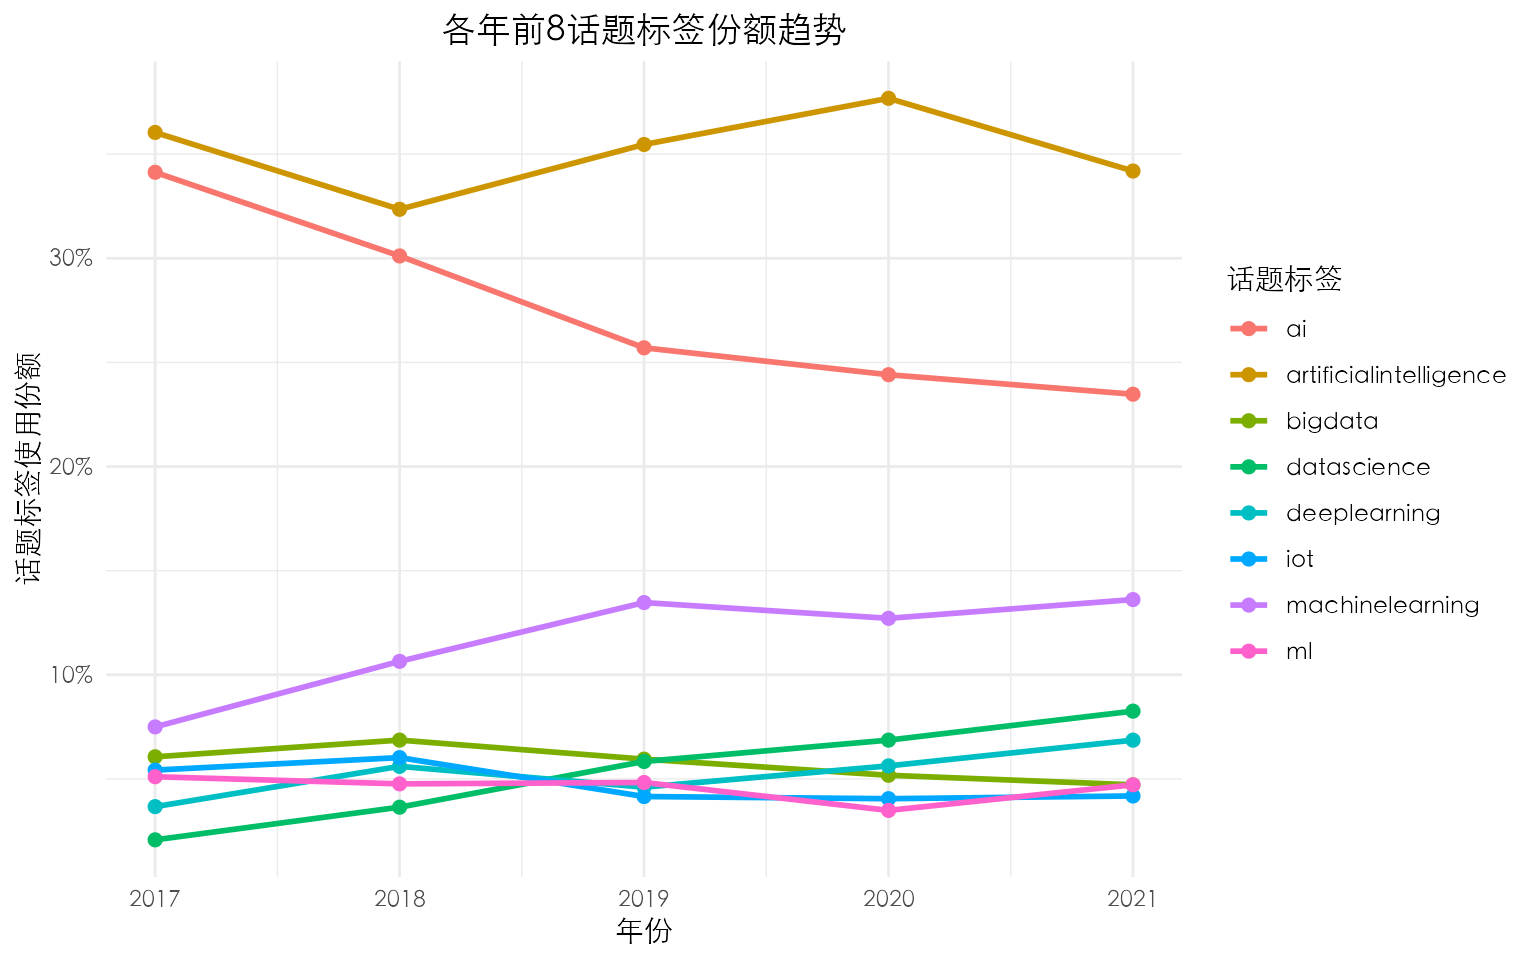
表 8 展示了使用频率最高的现金标签。排名前列的现金标签依次为 \(btc(4次)、\)btcusd(3次)和 $v(3次),其余几乎均仅出现一次。现金标签极低的频次表明,AI相关的市场与投资话语在本语料库中占据非常小的比例,现金标签更应被理解为加密货币或金融相关AI话题的偶发标记,而非一种主要的话语框架。
# 统计并排序现金标签频次;保留前5个
top_cashtags <- cashtag_tokens |>
  count(cashtag, sort = TRUE) |>
  slice_max(n, n = 5)

knitr::kable(
  top_cashtags |> rename(现金标签 = cashtag, 频次 = n),
  align = 'c',
  caption = "AI相关推文中最常用现金标签(2017—2021年)"
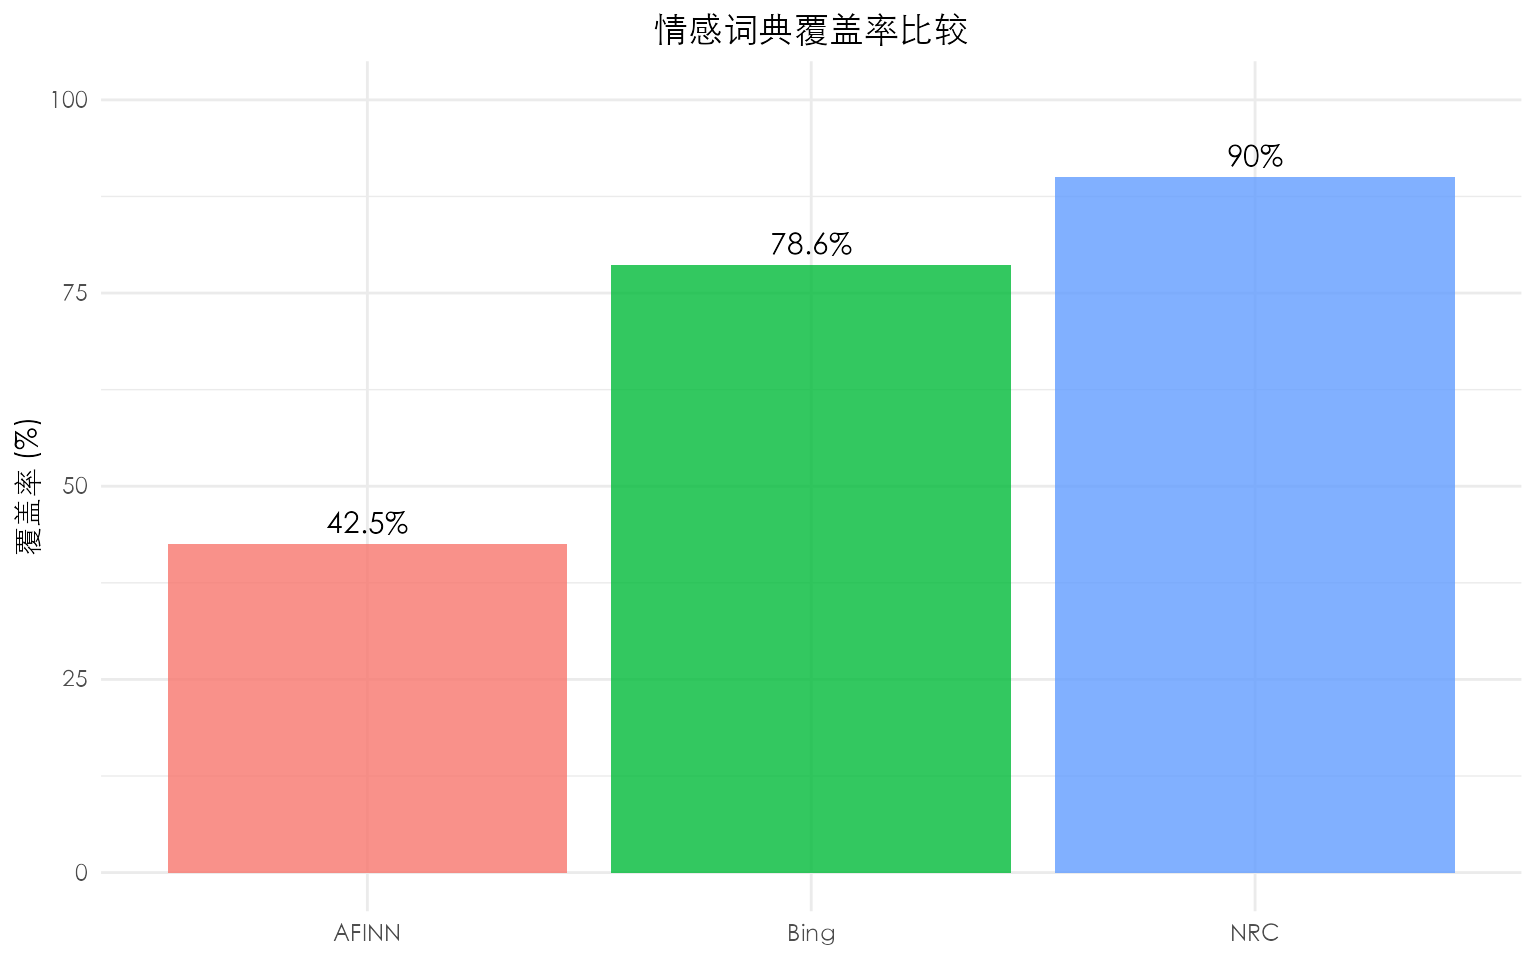
)情感分析使用了三种已建立的词典:AFINN、Bing和NRC。表 9 汇总了各词典在数据集中的覆盖情况。NRC覆盖率最广,对90.0%的推文进行了评分,其次为Bing(78.6%)和AFINN(42.5%)。图 6 直观地呈现了上述差异。尽管AFINN覆盖率较低,但基于三个原因将其选为主要情感度量指标。第一,AFINN提供连续强度量表(–5至+5),可捕捉正面或负面情感的程度,直接适用于回归建模。第二,在三种词典均评分的1,130条推文中,AFINN与Bing的相关性较强(r = .664),与NRC呈中等相关(r = .510),Bing与NRC的相关性为 r = .528,印证了三种度量指标捕捉到了一致的潜在信号。第三,NRC额外评分的推文并不足以为本分析目的而引入分类情绪框架的额外解读复杂性提供依据。
# 分词并去除停用词,用于情感分析
sa_token_data <- data |>
  unnest_tokens(word, text) |>
  anti_join(stop_words, by = "word") |>
  mutate(nchar_w = nchar(word))

cat("词元总数:", nrow(sa_token_data), "\n")
cat("唯一词元数:", n_distinct(sa_token_data$word), "\n")
cat("每条推文平均词元数:",
    round(nrow(sa_token_data) / n_distinct(sa_token_data$tweet_index), 1), "\n")
词元总数: 34076
唯一词元数: 8236
每条推文平均词元数: 11.4 # AFINN:数值评分,范围从 -5(极度消极)到 +5(极度积极)
afinn_scores <- sa_token_data |>
inner_join(get_sentiments("afinn"), by = "word") |>
group_by(tweet_index) |>
summarise(
sentiment_afinn = sum(value),
n_afinn_words = n(),
avg_afinn = mean(value),
.groups = "drop"
)
afinn_coverage <- nrow(afinn_scores)
afinn_coverage_pct <- round(afinn_coverage / nrow(data) * 100, 1)
cat("AFINN 覆盖率:", afinn_coverage, "条推文 (", afinn_coverage_pct, "% )\n")AFINN 覆盖率: 1275 条推文 ( 42.5 % )# Bing:正面/负面二元分类
bing_scores <- sa_token_data |>
inner_join(get_sentiments("bing"), by = "word") |>
group_by(tweet_index) |>
summarise(
n_positive = sum(sentiment == "positive"),
n_negative = sum(sentiment == "negative"),
n_bing_words = n(),
sentiment_bing = n_positive - n_negative,
.groups = "drop"
)
bing_coverage <- nrow(bing_scores)
bing_coverage_pct <- round(bing_coverage / nrow(data) * 100, 1)
cat("Bing 覆盖率:", bing_coverage, "条推文 (", bing_coverage_pct, "%)\n")Bing 覆盖率: 2359 条推文 ( 78.6 %)# NRC:8种基本情绪 + 正面/负面
nrc_raw <- sa_token_data |>
inner_join(get_sentiments("nrc"), by = "word")
nrc_scores <- nrc_raw |>
group_by(tweet_index, sentiment) |>
summarise(n = n(), .groups = "drop") |>
pivot_wider(names_from = sentiment, values_from = n, values_fill = 0) |>
mutate(sentiment_nrc = positive - negative)
nrc_coverage <- nrow(nrc_scores)
nrc_coverage_pct <- round(nrc_coverage / nrow(data) * 100, 1)
cat("NRC 覆盖率:", nrc_coverage, "条推文 (", nrc_coverage_pct, "%)\n")NRC 覆盖率: 2700 条推文 ( 90 %)# 将预先计算的覆盖率数据汇总为对比表
coverage_df <- data.frame(
lexicon = c("AFINN", "Bing", "NRC"),
tweets_scored = c(afinn_coverage, bing_coverage, nrc_coverage),
coverage_pct = c(afinn_coverage_pct, bing_coverage_pct, nrc_coverage_pct)
)
knitr::kable(
coverage_df |>
rename(
词典 = lexicon,
`已评分推文数` = tweets_scored,
`覆盖率 (%)` = coverage_pct
),
align = 'c',
caption = "各情感词典在推文样本中的覆盖率"
)| 词典 | 已评分推文数 | 覆盖率 (%) |
|---|---|---|
| AFINN | 1275 | 42.5 |
| Bing | 2359 | 78.6 |
| NRC | 2700 | 90.0 |
# 比较三种词典推文覆盖率(%)的条形图
ggplot(coverage_df, aes(x = lexicon, y = coverage_pct, fill = lexicon)) +
  geom_col(alpha = 0.8) +
  geom_text(aes(label = paste0(coverage_pct, "%")), vjust = -0.4, size = 4) +
  ylim(0, 100) +
  labs(
    title = "情感词典覆盖率比较",
    x = NULL,
    y = "覆盖率 (%)"
  ) +
  theme_minimal() +
  theme(
    legend.position = "none",
    plot.title = element_text(hjust = 0.5)
  )
# 三种词典均评分的推文之间的相关性
sentiment_cmp <- data |>
  select(tweet_index) |>
  left_join(
    afinn_scores |>
    select(tweet_index, sentiment_afinn), by = "tweet_index"
  ) |>
  left_join(
    bing_scores |>
    select(tweet_index, sentiment_bing), by = "tweet_index"
  ) |>
  left_join(
    nrc_scores |>
    select(tweet_index, sentiment_nrc), by = "tweet_index"
  )

complete_cmp <- sentiment_cmp |>
  filter(!is.na(sentiment_afinn), !is.na(sentiment_bing), !is.na(sentiment_nrc))

cat("三种词典均评分的推文数:", nrow(complete_cmp), "\n")
cat(
  "AFINN 与 Bing 的相关性: r =",
  round(cor(complete_cmp$sentiment_afinn, complete_cmp$sentiment_bing), 3),
  "\n"
)
cat(
  "AFINN 与 NRC 的相关性:  r =",
  round(cor(complete_cmp$sentiment_afinn, complete_cmp$sentiment_nrc), 3),
  "\n"
)
cat(
  "Bing  与 NRC 的相关性:  r =",
  round(cor(complete_cmp$sentiment_bing,  complete_cmp$sentiment_nrc), 3),
  "\n"
)
三种词典均评分的推文数: 1130
AFINN 与 Bing 的相关性: r = 0.665
AFINN 与 NRC 的相关性: r = 0.509
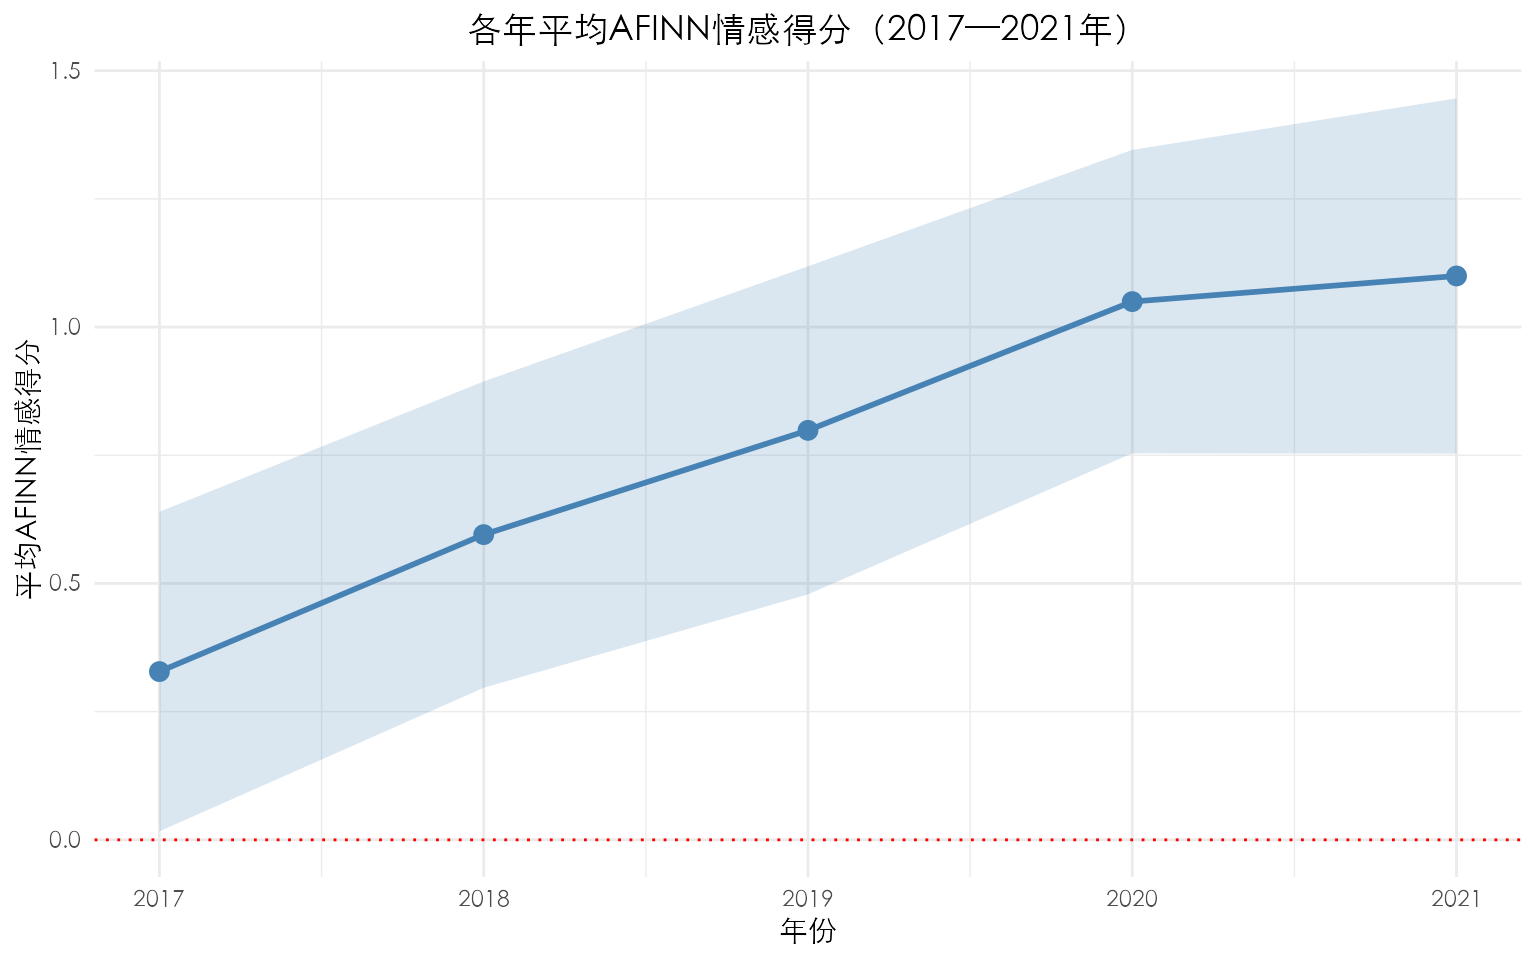
Bing 与 NRC 的相关性: r = 0.529 在获得AFINN评分的1,275条推文中,语料库整体情感略显正面(M = 0.81,中位数 = 1,范围:-18至12)。表 10 和 图 7 展示了各年平均AFINN得分及95%置信区间。趋势明显呈上升态势:平均情感得分从2017年的0.33升至2018年的0.60、2019年的0.80、2020年的1.05和2021年的1.11。95%置信区间表明这一上升趋势在后期年份愈加稳定。这一模式与AI逐渐常态化为实用且前景广阔的技术这一叙事相吻合,公众话语逐步转向对AI应用及社会效益更为乐观的预期。
# 将 AFINN 评分附加到数据中,并传播至 meta_theta_df
data <- data |>
  left_join(
    afinn_scores |>
    select(tweet_index, sentiment_afinn), by = "tweet_index"
  ) |>
  mutate(sentiment_norm = sentiment_afinn / nwords)

meta_theta_df <- meta_theta_df |>
  left_join(
    afinn_scores |>
    select(tweet_index, sentiment_afinn), by = "tweet_index"
  )

n_scored <- sum(!is.na(data$sentiment_afinn))
cat("获得AFINN评分的推文数:", n_scored,
    paste0("(", round(n_scored / nrow(data) * 100, 1), "%)"), "\n")
summary(data$sentiment_afinn)
获得AFINN评分的推文数: 1275 (42.5%)
Min. 1st Qu. Median Mean 3rd Qu. Max. NA's
-18.0000 -1.0000 1.0000 0.8071 2.0000 12.0000 1725 # 各年平均AFINN得分及标准误和95%置信区间
sentiment_by_year <- data |>
filter(!is.na(sentiment_afinn)) |>
mutate(year = year(date_utc)) |>
group_by(year) |>
summarise(
n = n(),
mean_sent = mean(sentiment_afinn),
se_sent = sd(sentiment_afinn) / sqrt(n),
.groups = "drop"
) |>
mutate(
ci_low = mean_sent - 1.96 * se_sent,
ci_high = mean_sent + 1.96 * se_sent
)
knitr::kable(
sentiment_by_year |>
rename(
年份 = year, `已评分推文数` = n, `平均情感得分` = mean_sent,
标准误 = se_sent, `95%置信区间下限` = ci_low, `95%置信区间上限` = ci_high
),
align = 'c',
caption = "各年平均AFINN情感得分及95%置信区间",
digits = 3
)| 年份 | 已评分推文数 | 平均情感得分 | 标准误 | 95%置信区间下限 | 95%置信区间上限 |
|---|---|---|---|---|---|
| 2017 | 192 | 0.328 | 0.159 | 0.017 | 0.640 |
| 2018 | 252 | 0.595 | 0.152 | 0.297 | 0.894 |
| 2019 | 278 | 0.799 | 0.163 | 0.479 | 1.118 |
| 2020 | 282 | 1.050 | 0.151 | 0.754 | 1.345 |
| 2021 | 271 | 1.100 | 0.177 | 0.753 | 1.446 |
# 折线加置信带,展示2017至2021年平均AFINN情感趋势
ggplot(sentiment_by_year, aes(x = year, y = mean_sent)) +
  geom_ribbon(
    aes(ymin = ci_low, ymax = ci_high),
    alpha = 0.2, fill = "steelblue"
  ) +
  geom_line(color = "steelblue", linewidth = 1) +
  geom_point(color = "steelblue", size = 3) +
  geom_hline(yintercept = 0, linetype = "dotted", color = "red") +
  scale_x_continuous(breaks = 2017:2021) +
  labs(
    title = "各年平均AFINN情感得分(2017—2021年)",
    x = "年份",
    y = "平均AFINN情感得分"
  ) +
  theme_minimal() +
  theme(
    plot.title = element_text(hjust = 0.5)
  )
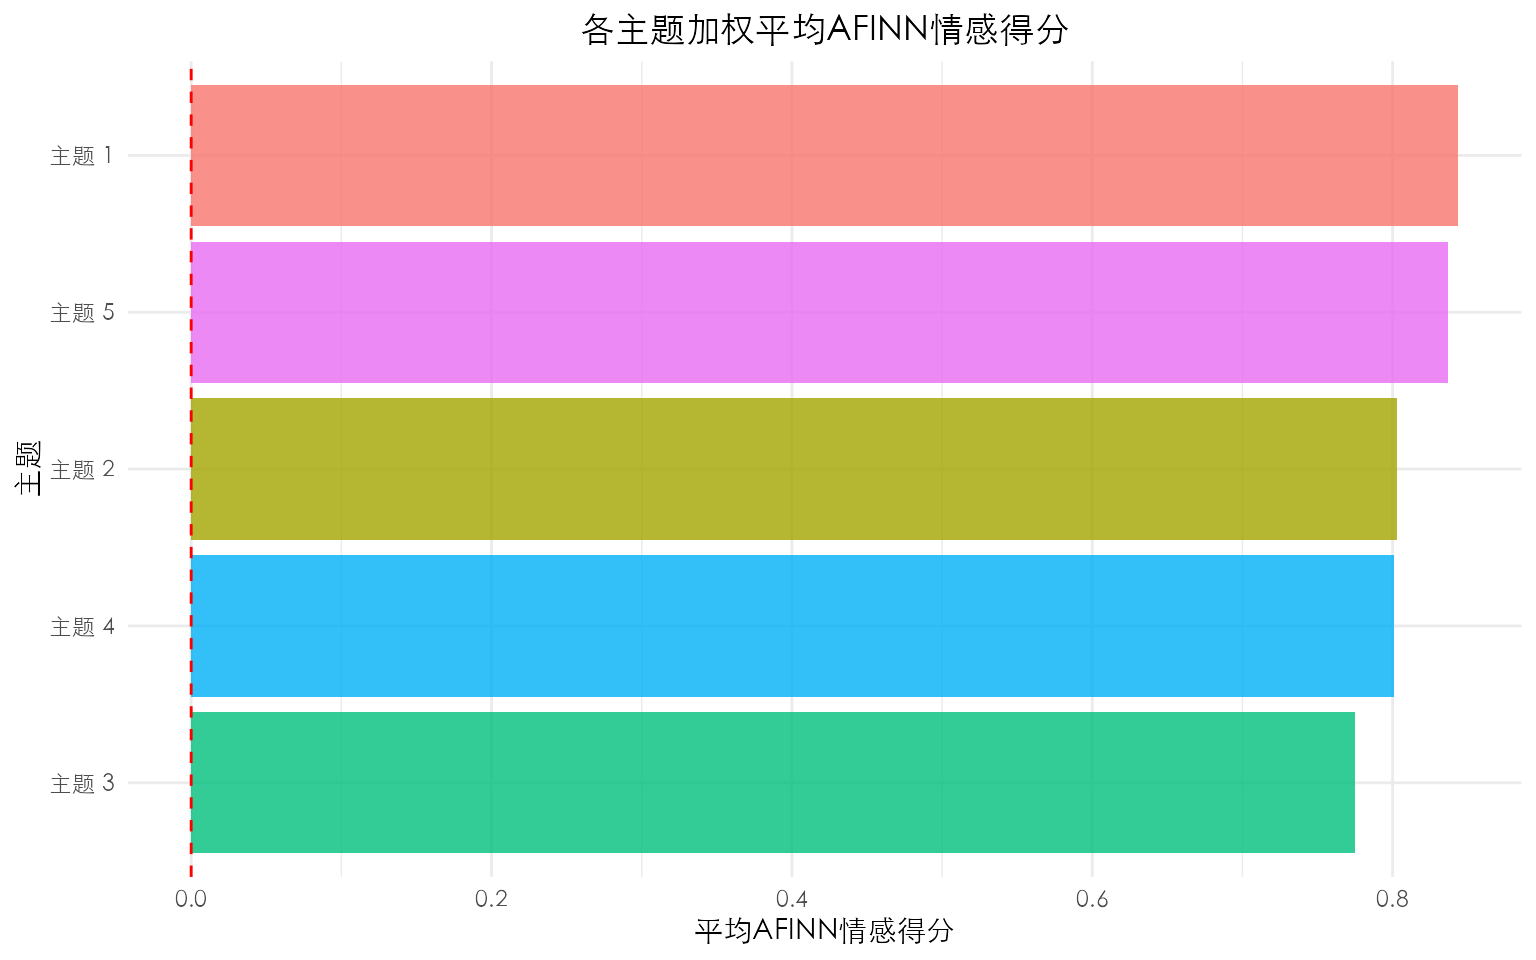
为考察话语主题是否与不同情感倾向相关联,使用gamma加权得分计算了各主题的平均AFINN情感值,即每条推文对某主题平均情感的贡献与其在该主题中的成员概率成正比。图 8 呈现了这些加权平均值。五个主题的情感得分非常相近,范围从0.79(主题5,AI生态流行词)到0.84(主题4,商业与创新)。以主题成员概率为权重、以情感为因变量的加权线性回归模型显示,相对于主题1,其他任何主题均无统计显著差异(所有 p > .80)。这一结果表明,在本语料库中,情感倾向在主题簇之间并无实质性差异;情感随时间的变化比随主题的变化更为一致。
# 计算各主题的加权情感得分
meta_theta_df <- meta_theta_df |>
  filter(!is.na(sentiment_afinn)) |>
  mutate(
    wt_sent_t1 = sentiment_afinn * topic_1,
    wt_sent_t2 = sentiment_afinn * topic_2,
    wt_sent_t3 = sentiment_afinn * topic_3,
    wt_sent_t4 = sentiment_afinn * topic_4,
    wt_sent_t5 = sentiment_afinn * topic_5
  )

topic_sent_avg <- tibble(
  topic = 1:5,
  total_weighted = c(
    sum(meta_theta_df$wt_sent_t1), sum(meta_theta_df$wt_sent_t2),
    sum(meta_theta_df$wt_sent_t3), sum(meta_theta_df$wt_sent_t4),
    sum(meta_theta_df$wt_sent_t5)
  ),
  gamma_mass = c(
    sum(meta_theta_df$topic_1), sum(meta_theta_df$topic_2),
    sum(meta_theta_df$topic_3), sum(meta_theta_df$topic_4),
    sum(meta_theta_df$topic_5)
  )
) |>
  mutate(
    avg_sentiment = total_weighted / gamma_mass,
    topic_label   = paste("主题", topic)
)# 各主题gamma加权平均AFINN情感得分的水平条形图
ggplot(
topic_sent_avg,
aes(
x = reorder(topic_label, avg_sentiment),
y = avg_sentiment,
fill = topic_label
)
) +
geom_col(alpha = 0.8) +
geom_hline(yintercept = 0, linetype = "dashed", color = "red") +
coord_flip() +
labs(
title = "各主题加权平均AFINN情感得分",
x = "主题",
y = "平均AFINN情感得分"
) +
theme_minimal() +
theme(
legend.position = "none",
plot.title = element_text(hjust = 0.5)
)
# 加权回归:情感 ~ 主题(验证差异不显著)
sentiment_topic_long <- meta_theta_df |>
  select(tweet_index, sentiment_afinn, starts_with("topic_")) |>
  pivot_longer(
    cols         = starts_with("topic_"),
    names_to     = "topic",
    values_to    = "gamma",
    names_prefix = "topic_"
  ) |>
  mutate(topic = factor(topic, levels = as.character(1:5)))

weighted_model <- lm(
  sentiment_afinn ~ topic,
  data = sentiment_topic_long, weights = gamma
)
summary(weighted_model)
Call:
lm(formula = sentiment_afinn ~ topic, data = sentiment_topic_long,
    weights = gamma)

Weighted Residuals:
    Min      1Q  Median      3Q     Max
-9.6154 -0.8085  0.0898  0.5569  5.6288

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)  0.843559   0.072602  11.619   <2e-16 ***
topic2      -0.040555   0.103362  -0.392    0.695
topic3      -0.068844   0.103068  -0.668    0.504
topic4      -0.042529   0.102899  -0.413    0.679
topic5      -0.006947   0.102690  -0.068    0.946
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.163 on 6350 degrees of freedom
Multiple R-squared:  9.466e-05, Adjusted R-squared:  -0.0005352
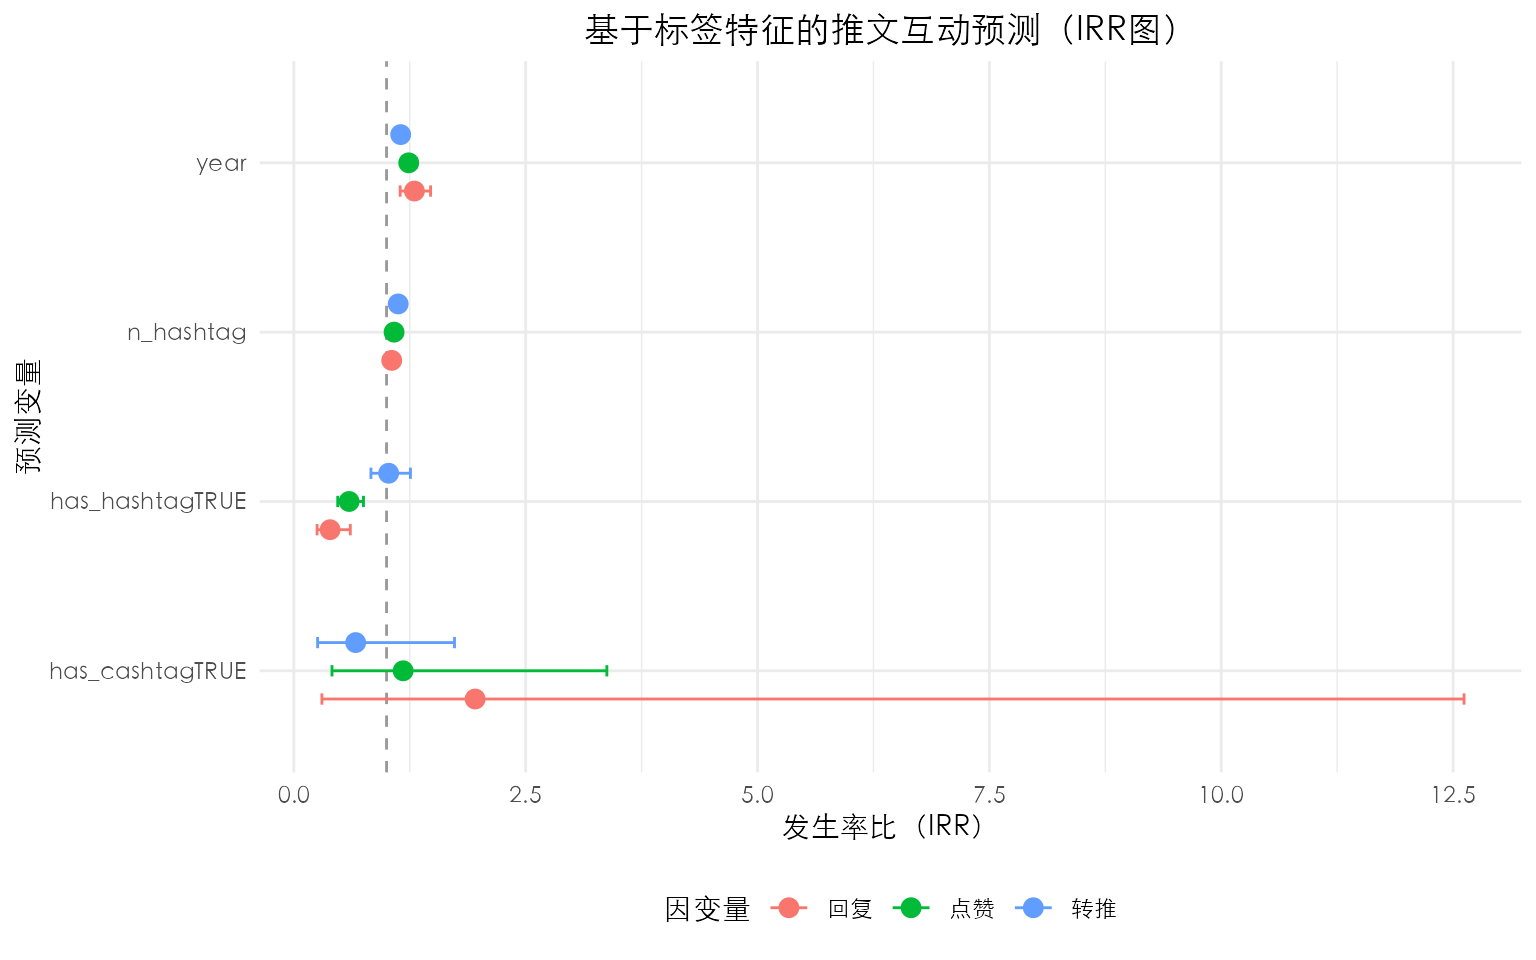
F-statistic: 0.1503 on 4 and 6350 DF, p-value: 0.9629为考察内容包装是否与互动相关(研究问题2),首先按标签存在与否比较了平均互动指标(表 11),然后拟合了三个负二项GLM,分别以话题标签存在与否、话题标签数量、现金标签存在与否和年份为预测因素,预测点赞、回复和转推数(表 12、图 9)。
描述性结果显示,包含话题标签的推文平均点赞数略高(3.11 vs. 2.89),平均转推数则明显更高(2.86 vs. 1.23),但平均回复数略低(0.12 vs. 0.19)。含现金标签的推文在三项指标上均有较高均值,但含现金标签的推文数量过少(n = 22),不足以支持可靠比较。
# 按话题标签和现金标签的存在与否计算平均互动指标
tag_engagement_summary <- tag_features |>
  summarise(
    likes_no_hashtag    = round(mean(likes_count[!has_hashtag]), 2),
    likes_hashtag       = round(mean(likes_count[has_hashtag]), 2),
    retweets_no_hashtag = round(mean(retweets_count[!has_hashtag]), 2),
    retweets_hashtag    = round(mean(retweets_count[has_hashtag]), 2),
    replies_no_hashtag  = round(mean(replies_count[!has_hashtag]), 2),
    replies_hashtag     = round(mean(replies_count[has_hashtag]), 2),
    likes_no_cashtag    = round(mean(likes_count[!has_cashtag]), 2),
    likes_cashtag       = round(mean(likes_count[has_cashtag]), 2),
    retweets_no_cashtag = round(mean(retweets_count[!has_cashtag]), 2),
    retweets_cashtag    = round(mean(retweets_count[has_cashtag]), 2),
    replies_no_cashtag  = round(mean(replies_count[!has_cashtag]), 2),
    replies_cashtag     = round(mean(replies_count[has_cashtag]), 2)
  )

knitr::kable(
  tibble(
    条件           = c("无话题标签", "有话题标签", "无现金标签", "有现金标签"),
    `平均点赞数`   = c(tag_engagement_summary$likes_no_hashtag,
                      tag_engagement_summary$likes_hashtag,
                      tag_engagement_summary$likes_no_cashtag,
                      tag_engagement_summary$likes_cashtag),
    `平均回复数`   = c(tag_engagement_summary$replies_no_hashtag,
                      tag_engagement_summary$replies_hashtag,
                      tag_engagement_summary$replies_no_cashtag,
                      tag_engagement_summary$replies_cashtag),
    `平均转推数`   = c(tag_engagement_summary$retweets_no_hashtag,
                      tag_engagement_summary$retweets_hashtag,
                      tag_engagement_summary$retweets_no_cashtag,
                      tag_engagement_summary$retweets_cashtag)
  ),
  align = c('l', 'c', 'c', 'c'),
  caption = "按标签存在与否划分的平均互动指标"
)| 条件 | 平均点赞数 | 平均回复数 | 平均转推数 |
|---|---|---|---|
| 无话题标签 | 2.89 | 0.19 | 1.23 |
| 有话题标签 | 3.11 | 0.12 | 2.86 |
| 无现金标签 | 3.04 | 0.14 | 2.35 |
| 有现金标签 | 4.05 | 0.23 | 2.41 |
表 12 和 图 9 展示了基于标签特征的负二项模型中指数化回归系数(发生率比,IRR)。每条推文的话题标签数量对三项互动结果均为正向预测因素:点赞(IRR = 1.08,p < .001)、回复(IRR = 1.06,p = .021)和转推(IRR = 1.13,p < .001)。相比之下,在模型中加入话题标签数量后,单纯拥有话题标签对点赞(IRR = 0.60,p < .001)和回复(IRR = 0.39,p < .001)均为负向预测因素,对转推则不显著。这一模式反映了组合效应:仅含一两个话题标签的推文无法从话题标签网络提供的可发现性中获益,而含有大量话题标签的推文则往往在各项指标上吸引更多互动。现金标签的存在与任何互动结果均无显著关联。
# 使用标签特征为各互动指标拟合负二项GLM
tag_glm_likes <- glm.nb(
  likes_count ~ has_hashtag + has_cashtag + n_hashtag + year,
  data = tag_features
)
tag_glm_replies <- glm.nb(
  replies_count ~ has_hashtag + has_cashtag + n_hashtag + year,
  data = tag_features
)
tag_glm_retweets <- glm.nb(
  retweets_count ~ has_hashtag + has_cashtag + n_hashtag + year,
  data = tag_features
)

tag_models <- list(
  点赞 = tag_glm_likes,
  回复 = tag_glm_replies,
  转推 = tag_glm_retweets
)

tag_coef_all <- bind_rows(lapply(names(tag_models), function(nm) {
  tidy(tag_models[[nm]], exponentiate = TRUE) |>
    filter(term != "(Intercept)") |>
    mutate(
      # Wald 置信区间(对数率尺度上的 delta 方法)
      # 比 profile-likelihood confint() 更快
      conf.low  = estimate * exp(-1.96 * std.error),
      conf.high = estimate * exp( 1.96 * std.error),
      outcome   = nm
    )
}))# 提取并格式化标签GLM中的指数化系数(IRR)
knitr::kable(
tag_coef_all |>
select(outcome, term, estimate, conf.low, conf.high, p.value) |>
mutate(
term = recode(term,
"has_hashtagTRUE" = "有话题标签",
"has_cashtagTRUE" = "有现金标签",
"n_hashtag" = "话题标签数量",
"year" = "年份"
),
outcome = factor(outcome, levels = c("点赞", "回复", "转推"))
) |>
rename(
因变量 = outcome,
预测变量 = term,
IRR = estimate,
`95%置信区间下限` = conf.low,
`95%置信区间上限` = conf.high,
`p值` = p.value
),
caption = "负二项GLM:标签特征对用户互动的预测(IRR)",
align = c('l', 'l', 'c', 'c', 'c', 'c'),
digits = 3
)| 因变量 | 预测变量 | IRR | 95%置信区间下限 | 95%置信区间上限 | p值 |
|---|---|---|---|---|---|
| 点赞 | 有话题标签 | 0.596 | 0.474 | 0.751 | 0.000 |
| 点赞 | 有现金标签 | 1.179 | 0.412 | 3.375 | 0.759 |
| 点赞 | 话题标签数量 | 1.081 | 1.055 | 1.108 | 0.000 |
| 点赞 | 年份 | 1.239 | 1.161 | 1.322 | 0.000 |
| 回复 | 有话题标签 | 0.391 | 0.251 | 0.609 | 0.000 |
| 回复 | 有现金标签 | 1.955 | 0.303 | 12.618 | 0.481 |
| 回复 | 话题标签数量 | 1.056 | 1.008 | 1.106 | 0.021 |
| 回复 | 年份 | 1.300 | 1.147 | 1.475 | 0.000 |
| 转推 | 有话题标签 | 1.023 | 0.832 | 1.258 | 0.832 |
| 转推 | 有现金标签 | 0.667 | 0.257 | 1.733 | 0.406 |
| 转推 | 话题标签数量 | 1.125 | 1.102 | 1.150 | 0.000 |
| 转推 | 年份 | 1.152 | 1.088 | 1.220 | 0.000 |
# 标签特征互动预测因素的IRR点图及95%置信区间
ggplot(tag_coef_all, aes(x = estimate, y = term, color = outcome)) +
  geom_vline(xintercept = 1, linetype = "dashed", color = "gray60") +
  geom_point(size = 3, position = position_dodge(0.5)) +
  geom_errorbarh(
    aes(xmin = conf.low, xmax = conf.high),
    height = 0.2, position = position_dodge(0.5)
  ) +
  labs(
    title = "基于标签特征的推文互动预测(IRR图)",
    x = "发生率比(IRR)", y = "预测变量", color = "因变量"
  ) +
  theme_minimal() +
  theme(
    legend.position = "bottom",
    plot.title = element_text(hjust = 0.5)
  )
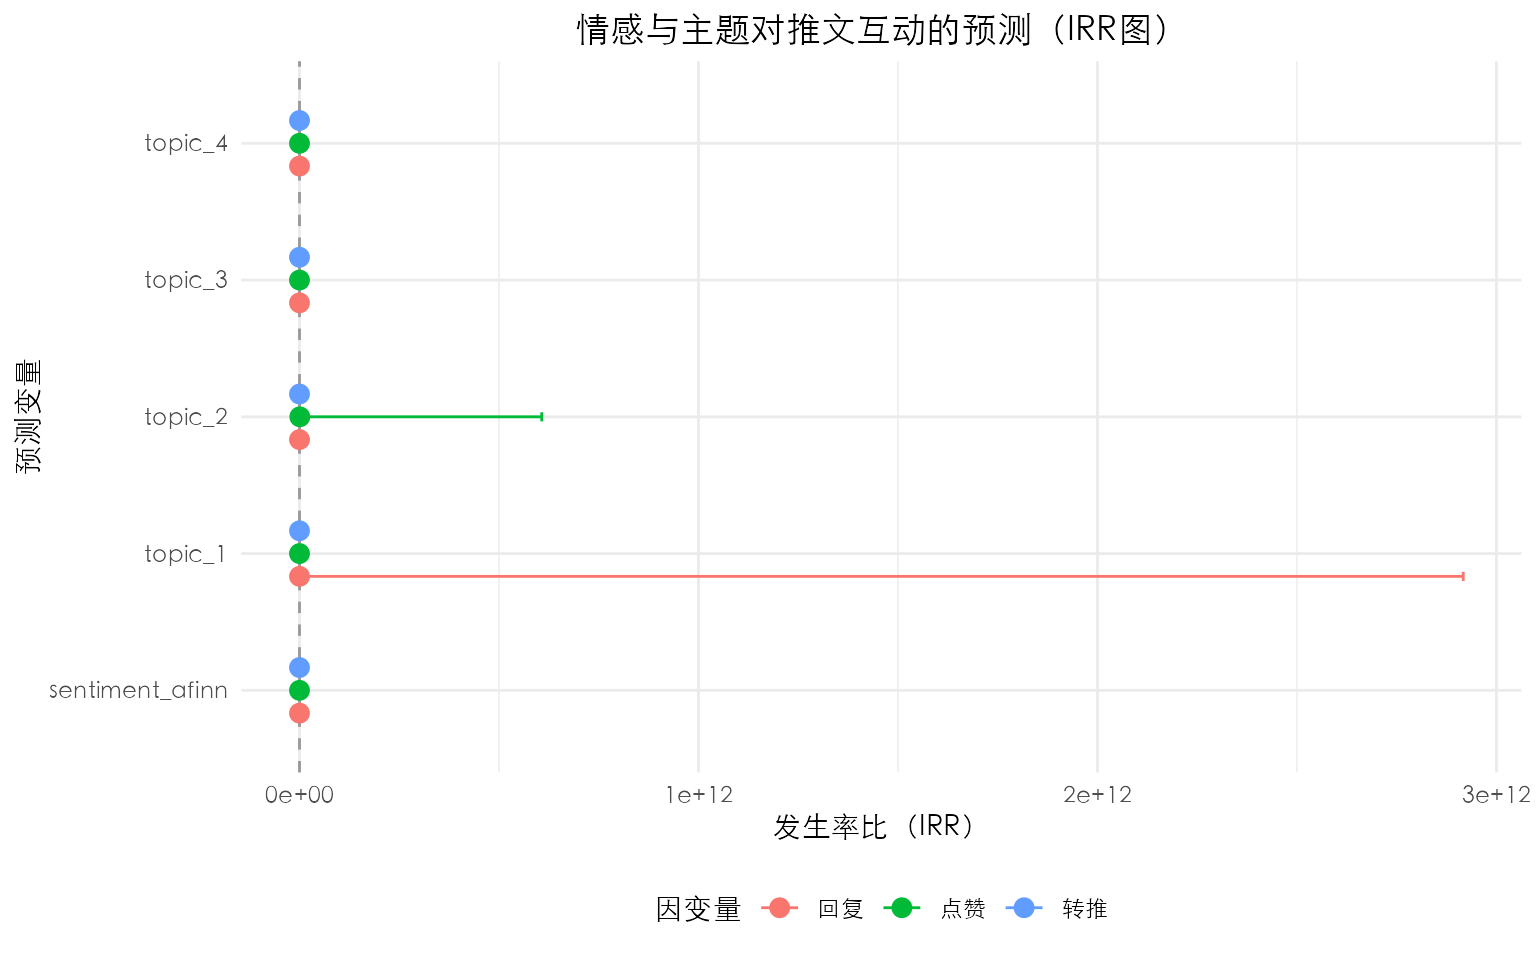
为直接检验话语特征与互动之间的关联,拟合了三个负二项GLM,分别以AFINN情感得分、LDA主题概率(主题1至4,主题5通过组合约束隐式作为基准)和年份固定效应为预测因素,预测点赞、回复和转推数(表 13、图 10)。
AFINN情感对任何互动结果均无统计显著的预测作用。点赞的IRR为0.99(p = .676),回复为0.92(p = .081),转推为0.98(p = .383)。这一发现表明,在控制了主题组合和年份后,更积极或更消极的情感倾向本身并不能可靠地增加或减少互动。
相比之下,年份是互动的一致且显著预测因素。相对于2017年,2018年的推文预期点赞数(IRR = 4.00)和回复数(IRR = 8.23)大幅增加;2020年和2021年的点赞数和回复数也显著更高。相对于2017年,2018年(IRR = 2.13)和2021年(IRR = 2.12)的转推数显著更高。这些显著的年份效应表明,2017年后Twitter上AI内容的受众规模大幅增长,无论内容的情感倾向如何,整体互动量均有所提升。
主题效应在部分结果中存在,但需审慎解读,原因在于LDA主题概率具有组合性——增加某一主题的概率必然减少其他主题的概率,这导致主题预测因素之间存在近似多重共线性,进而产生膨胀或不稳定的系数估计。最合理的解读是:商业创新框架(主题4)可能与更多对话性回复相关,而科技市场内容(主题2)可能较少获得被动放大,但这些结论需要更稳健的模型规格才能确信表述。
# 将年份转为因子,使 GLM 将其视为分类固定效应
glm_data <- meta_theta_df |>
mutate(year = factor(year(date_utc)))# 负二项GLM:AFINN情感 + LDA主题概率 + 年份预测点赞数
glm_likes <- glm.nb(
likes_count ~ sentiment_afinn + topic_1 + topic_2 + topic_3 + topic_4 + year,
data = glm_data
)
cat("=== 模型:likes_count ===\n")
summary(glm_likes)=== 模型:likes_count ===
Call:
glm.nb(formula = likes_count ~ sentiment_afinn + topic_1 + topic_2 +
topic_3 + topic_4 + year, data = glm_data, init.theta = 0.1753681108,
link = log)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -4.03022 2.06681 -1.950 0.051180 .
sentiment_afinn 0.01122 0.02750 0.408 0.683354
topic_1 7.00273 3.40404 2.057 0.039669 *
topic_2 20.51559 3.37578 6.077 1.22e-09 ***
topic_3 0.97862 3.64066 0.269 0.788082
topic_4 -7.01853 3.61877 -1.939 0.052443 .
year2018 1.23738 0.24369 5.078 3.82e-07 ***
year2019 0.79655 0.24130 3.301 0.000963 ***
year2020 1.08923 0.24018 4.535 5.76e-06 ***
year2021 1.85646 0.24253 7.655 1.94e-14 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for Negative Binomial(0.1709) family taken to be 1)
Null deviance: 1067.2 on 1270 degrees of freedom
Residual deviance: 1040.5 on 1261 degrees of freedom
AIC: 4683.8
Number of Fisher Scoring iterations: 25
Theta: 0.17537
Std. Err.: 0.00926
Warning while fitting theta: alternation limit reached
2 x log-likelihood: -4661.79500 # 相同模型结构预测回复数
glm_replies <- glm.nb(
replies_count ~ sentiment_afinn + topic_1 + topic_2 + topic_3 + topic_4 + year,
data = glm_data
)
cat("=== 模型:replies_count ===\n")
summary(glm_replies)=== 模型:replies_count ===
Call:
glm.nb(formula = replies_count ~ sentiment_afinn + topic_1 +
topic_2 + topic_3 + topic_4 + year, data = glm_data, init.theta = 0.1012493424,
link = log)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -4.62931 3.45547 -1.340 0.180341
sentiment_afinn -0.10863 0.04545 -2.390 0.016845 *
topic_1 17.98263 5.46880 3.288 0.001008 **
topic_2 2.85307 5.53684 0.515 0.606352
topic_3 -13.98182 6.23073 -2.244 0.024832 *
topic_4 -0.54360 6.05105 -0.090 0.928418
year2018 2.00539 0.50254 3.991 6.59e-05 ***
year2019 0.94486 0.52320 1.806 0.070929 .
year2020 1.66313 0.50513 3.293 0.000993 ***
year2021 2.07555 0.50109 4.142 3.44e-05 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for Negative Binomial(0.1012) family taken to be 1)
Null deviance: 423.43 on 1270 degrees of freedom
Residual deviance: 344.67 on 1261 degrees of freedom
AIC: 1054.4
Number of Fisher Scoring iterations: 1
Theta: 0.1012
Std. Err.: 0.0152
2 x log-likelihood: -1032.3900 # 相同模型结构预测转推数
glm_retweets <- glm.nb(
retweets_count ~ sentiment_afinn + topic_1 + topic_2 + topic_3 + topic_4 + year,
data = glm_data
)
cat("=== 模型:retweets_count ===\n")
summary(glm_retweets)=== 模型:retweets_count ===
Call:
glm.nb(formula = retweets_count ~ sentiment_afinn + topic_1 +
topic_2 + topic_3 + topic_4 + year, data = glm_data, init.theta = 0.2623757604,
link = log)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -3.71255 1.76175 -2.107 0.035091 *
sentiment_afinn -0.03267 0.02310 -1.414 0.157233
topic_1 8.58860 2.88372 2.978 0.002898 **
topic_2 16.85582 2.82445 5.968 2.4e-09 ***
topic_3 -9.15645 3.05451 -2.998 0.002720 **
topic_4 4.39220 3.06705 1.432 0.152126
year2018 0.55233 0.20127 2.744 0.006067 **
year2019 -0.14420 0.20106 -0.717 0.473249
year2020 0.31611 0.19868 1.591 0.111609
year2021 0.74616 0.19952 3.740 0.000184 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for Negative Binomial(0.2624) family taken to be 1)
Null deviance: 1218.6 on 1270 degrees of freedom
Residual deviance: 1071.3 on 1261 degrees of freedom
AIC: 4313.1
Number of Fisher Scoring iterations: 1
Theta: 0.2624
Std. Err.: 0.0150
2 x log-likelihood: -4291.0870 models_list <- list(点赞 = glm_likes, 回复 = glm_replies, 转推 = glm_retweets)
coef_all <- bind_rows(lapply(names(models_list), function(nm) {
tidy(models_list[[nm]], exponentiate = TRUE) |>
# 去除截距和年份固定效应;
# 表格仅显示内容预测因素
filter(!grepl("Intercept|^year", term)) |>
mutate(
conf.low = estimate * exp(-1.96 * std.error),
conf.high = estimate * exp( 1.96 * std.error),
outcome = nm
)
}))
knitr::kable(
coef_all |>
select(outcome, term, estimate, conf.low, conf.high, p.value) |>
mutate(
term = recode(term,
"sentiment_afinn" = "AFINN情感得分",
"topic_1" = "主题1", "topic_2" = "主题2",
"topic_3" = "主题3", "topic_4" = "主题4"
)
) |>
rename(
因变量 = outcome, 预测变量 = term, IRR = estimate,
`95%置信区间下限` = conf.low, `95%置信区间上限` = conf.high, `p值` = p.value
),
align = c('l', 'l', 'c', 'c', 'c', 'c'),
caption = "负二项GLM:情感与主题对用户互动的预测(IRR,年份固定效应已排除)",
digits = 3
)| 因变量 | 预测变量 | IRR | 95%置信区间下限 | 95%置信区间上限 | p值 |
|---|---|---|---|---|---|
| 点赞 | AFINN情感得分 | 1.011000e+00 | 0.958 | 1.067000e+00 | 0.683 |
| 点赞 | 主题1 | 1.099627e+03 | 1.392 | 8.685993e+05 | 0.040 |
| 点赞 | 主题2 | 8.124686e+08 | 1087133.402 | 6.071980e+11 | 0.000 |
| 点赞 | 主题3 | 2.661000e+00 | 0.002 | 3.341967e+03 | 0.788 |
| 点赞 | 主题4 | 1.000000e-03 | 0.000 | 1.077000e+00 | 0.052 |
| 回复 | AFINN情感得分 | 8.970000e-01 | 0.821 | 9.810000e-01 | 0.017 |
| 回复 | 主题1 | 6.452939e+07 | 1427.661 | 2.916687e+12 | 0.001 |
| 回复 | 主题2 | 1.734100e+01 | 0.000 | 8.956269e+05 | 0.606 |
| 回复 | 主题3 | 0.000000e+00 | 0.000 | 1.700000e-01 | 0.025 |
| 回复 | 主题4 | 5.810000e-01 | 0.000 | 8.216263e+04 | 0.928 |
| 转推 | AFINN情感得分 | 9.680000e-01 | 0.925 | 1.013000e+00 | 0.157 |
| 转推 | 主题1 | 5.370114e+03 | 18.850 | 1.529887e+06 | 0.003 |
| 转推 | 主题2 | 2.091166e+07 | 82446.484 | 5.304018e+09 | 0.000 |
| 转推 | 主题3 | 0.000000e+00 | 0.000 | 4.200000e-02 | 0.003 |
| 转推 | 主题4 | 8.081800e+01 | 0.198 | 3.297828e+04 | 0.152 |
# 情感与主题预测因素的IRR点图(年份固定效应已排除)
ggplot(coef_all, aes(x = estimate, y = term, color = outcome)) +
  geom_vline(xintercept = 1, linetype = "dashed", color = "gray60") +
  geom_point(size = 3, position = position_dodge(0.5)) +
  geom_errorbarh(
    aes(xmin = conf.low, xmax = conf.high),
    height = 0.2, position = position_dodge(0.5)
  ) +
  labs(
    title = "情感与主题对推文互动的预测(IRR图)",
    x = "发生率比(IRR)", y = "预测变量", color = "因变量"
  ) +
  theme_minimal() +
  theme(
    legend.position = "bottom",
    plot.title = element_text(hjust = 0.5)
  )
综合来看,研究结果对两个研究问题提供了部分支持,同时揭示了2017至2021年间Twitter上AI话语演变及其与受众互动关联的重要细节。
就研究问题1而言,LDA主题建模结果表明,研究期间Twitter上的AI话语并未经历剧烈的主题转变。相反,语料库呈现出围绕五个反复出现的主题簇所构建的相对稳定结构:机器人技术与自动化、技术与市场、数据科学与安全、商业与创新,以及AI应用生态词汇。各年主题平均概率均接近0.20,几乎保持不变,表明这是一种多元但持续均衡的对话,能够吸收新进展而不被其重组。
这一发现可能令人意外,因为2017至2021年间AI领域出现了重大里程碑,包括自然语言处理的重大突破、AI伦理问题引发的广泛公共讨论,以及生成式AI工具的商业化。一种解释是,基于关键词的抽样策略(“Artificial Intelligence”)可能过度代表了机构性、宣传性和话题标签驱动的内容,这类内容往往围绕一套稳定的行业框架展开,与具体技术发展无关。基于特定事件词汇或日期锚定关键词构建的语料库,或许能揭示更为明显的主题变化。
尽管主题整体稳定,话题标签分析却提供了关于话语演变更为细致的图景。虽然 #artificialintelligence 和 #ai 在每一年均占主导地位,但排名靠后的话题标签随时间推移逐渐转向 #machinelearning、#datascience 和 #deeplearning 等更专业化的词汇,而 #bigdata 和 #iot 等更宽泛的基础设施词汇的相对重要性则有所下降。这一模式表明,Twitter上的AI话语演变不是通过主题的全面替换,而是通过日益增强的专业化来实现的——用户开始将AI讨论归入更精确的技术子领域,而非单纯依赖宽泛的”人工智能”框架。
情感趋势强化并深化了这一图景。平均AFINN情感得分从2017年的0.33稳步上升至2021年的1.11,表明公众AI话语在这五年间变得越来越积极。这与AI主流化的宏观叙事相吻合——技术越来越多地被框架为机遇、经济价值和实际创新的来源,而非抽象、不确定或具有威胁性的技术力量。关键在于,情感在不同主题之间并无实质性差异——最积极的主题(主题4:0.84)与最不积极的主题(主题5:0.79)之间的微小差距并不具有统计显著性。这表明,对AI的乐观情绪是推文发帖时间段的属性,而非其所属主题簇的属性。
就研究问题2而言,最为一致的发现是,用户互动受历史情境的影响比受单条推文的具体情感倾向或主题的影响更为显著。年份在所有三个互动模型中均是稳健的预测因素:相比2017年,2018年的推文预期点赞数(IRR = 4.00)和回复数(IRR = 8.23)大幅提升,2020年和2021年的点赞数和回复数保持较高水平,2021年的转推数也持续较高。这一模式表明,随着AI在此后数年成为更主流的文化与经济议题,Twitter上AI内容的受众规模不断扩大,整体更为活跃。
相比之下,在模型中加入年份和主题组合后,情感不再是互动的显著预测因素。AFINN情感的IRR在三项结果上均接近1.00,未达到统计显著性。对于内容创作者和传播从业者而言,这是一个重要发现:至少在本语料库的背景下,构建更热情或更危言耸听的AI内容,似乎并不能自动转化为更高的受众互动。互动更多地与内容发布的更宏观社会和平台情境相关。
话题标签分析为互动研究提供了更具操作意义的发现。在回归模型中,每条推文的话题标签数量与三项互动指标均呈持续且显著的正相关,而在控制话题标签数量后,单纯存在话题标签(至少有一个话题标签)与点赞数和回复数呈负相关。这一组合模式表明,话题标签密集的推文往往将内容置于多个既有关注流之中,使其更易被发现,也更有可能获得互动。相比之下,仅使用最少量或象征性话题标签并不能可靠地带来这些可发现性收益。这比简单的”使用话题标签”建议更为具体,表明话题标签的密度至关重要。
部分模型中存在主题对互动的效应,但由于LDA主题概率的组合性,解读较为困难——这种组合性在主题预测因素之间产生了近似多重共线性,导致系数估计膨胀或不稳定。初步模式——商业创新框架(主题4)与更多对话性回复相关,科技市场框架(主题2)与较少被动放大相关——在理论上是合理的。面向商业和未来的AI语言可能引发辩论和个人回应,而更抽象的科技市场语言可能较少被分享和放大。然而,这些结论需要更稳健的模型规格方可自信表述。
现金标签数量过少(仅22条推文),不足以支持任何有力的互动结论。其近乎缺席印证了金融行业AI讨论在本语料库中处于边缘位置,即便有少量推文将AI话题与加密货币或股市投机相连接。
若干局限性对上述结论构成制约。第一,本研究使用了从逾893,000条观测的语料库中抽取的3,000条推文样本,微小的年度主题变化可能因统计效力降低而被削弱。第二,数据通过关键词”Artificial Intelligence”收集,可能过度代表机构性、宣传性和专业框架下的内容,而低估非正式、批判性或个人化的AI讨论。第三,基于词典的情感分析无法识别讽刺、混合情感或社交媒体写作中常见的语境依赖性反讽。第四,LDA主题模型对语料库中共有的宽泛词汇较为敏感,这可能解释了为何各年度平均主题如此相似。
未来研究可从以下几个方面弥补上述局限。结构主题模型(STM)将主题流行度显式建模为年份或互动水平等元数据变量的函数,可获得对主题变化及其与互动关系更灵敏的估计。使用更大的年度分层或完整语料库将提供更强的统计效力,以检测AI话语的细微变化。整合句子级或上下文情感模型(如在社交媒体数据上训练的基于Transformer的分类器),与词级词典相比,可更有效地捕捉推文的细微和反讽语气。最后,未来研究可将特定AI里程碑(如2020年GPT-3的发布)作为自然实验,检验特定事件是否在Twitter上AI话语的主题或情感方面引发了可检测的变化。
本研究发现,2017至2021年间,Twitter上的AI话语在未发生底层主题结构根本重组的情况下,变得日益积极,互动也持续增强。证据表明,公众AI话语通过两种主要机制演变:其一是技术专业化的不断深化,用户开始以更精确的应用子领域话题标签标注其AI讨论;其二是乐观情绪的持续增长,随着AI更深度地融入商业和日常技术对话,话语基调日益向好。AI内容的互动更多由公众对AI随时间增长的兴趣驱动,而非由单条推文的具体情感倾向或主题焦点决定。上述发现有助于深化我们对变革性技术如何在公共社交媒体空间中被话语性常态化与采纳这一过程的理解。
筛选过程。 原始数据集经过滤,保留英语原创推文(排除转推),将语料库缩减至较小子集。随后按发帖年份进行等比例分层随机抽样(每年N = 600 × 5年 = 3,000条),以在保证计算效率的同时确保时间平衡。具体代码详见数据 > 观测值节。
UTC转换过程。 原始变量created_at以带有东部时区后缀的字符串形式存储。使用ymd_hms()函数并设置tz = "America/New_York"将其解析为日历时间对象,再通过with_tz()转换为UTC,最终强制转换为Date对象并存储为date_utc。具体代码详见数据 > 变量节。
拆分过程。 数据集中的话题标签和现金标签以Python风格的列表字符串形式存储(如"['ai', 'ml']")。为获取单个词元,使用str_remove_all()去除方括号和引号字符,再使用separate_rows()将逗号分隔的字符串拆分为独立行。具体代码详见数据 > 文本变量 > 话题标签节。
cat("R version:", R.version.string, "\n\n")
pkgs <- c("MASS", "tidyverse", "tidytext", "textdata", "topicmodels",
          "scales", "broom", "textutils", "knitr")
pkg_versions <- data.frame(
  Package = pkgs,
  Version = sapply(pkgs, function(p) as.character(packageVersion(p)))
)
knitr::kable(pkg_versions, row.names = FALSE)
R version: R version 4.5.2 (2025-10-31) | Package | Version |
|---|---|
| MASS | 7.3.65 |
| tidyverse | 2.0.0 |
| tidytext | 0.4.3 |
| textdata | 0.4.5 |
| topicmodels | 0.2.17 |
| scales | 1.4.0 |
| broom | 1.0.12 |
| textutils | 0.4.3 |
| knitr | 1.51 |