环境与版本
python==3.12
pandas==2.2.2
matplotlib==3.9.x
seaborn==0.13.2Pinn Xu
2024年10月27日
“tidy/flat” 的表格数据: 每行为一个 observation (或 instance、record) ,每列为一个 variable (变量,也称 attribute、feature、parameter) 。
通常,multivariate (多变量) 用于描述变量超过两个的数据,即,multivariate plot 通常使用了原 DataFrame 中三个或三个以上的列作为数据。
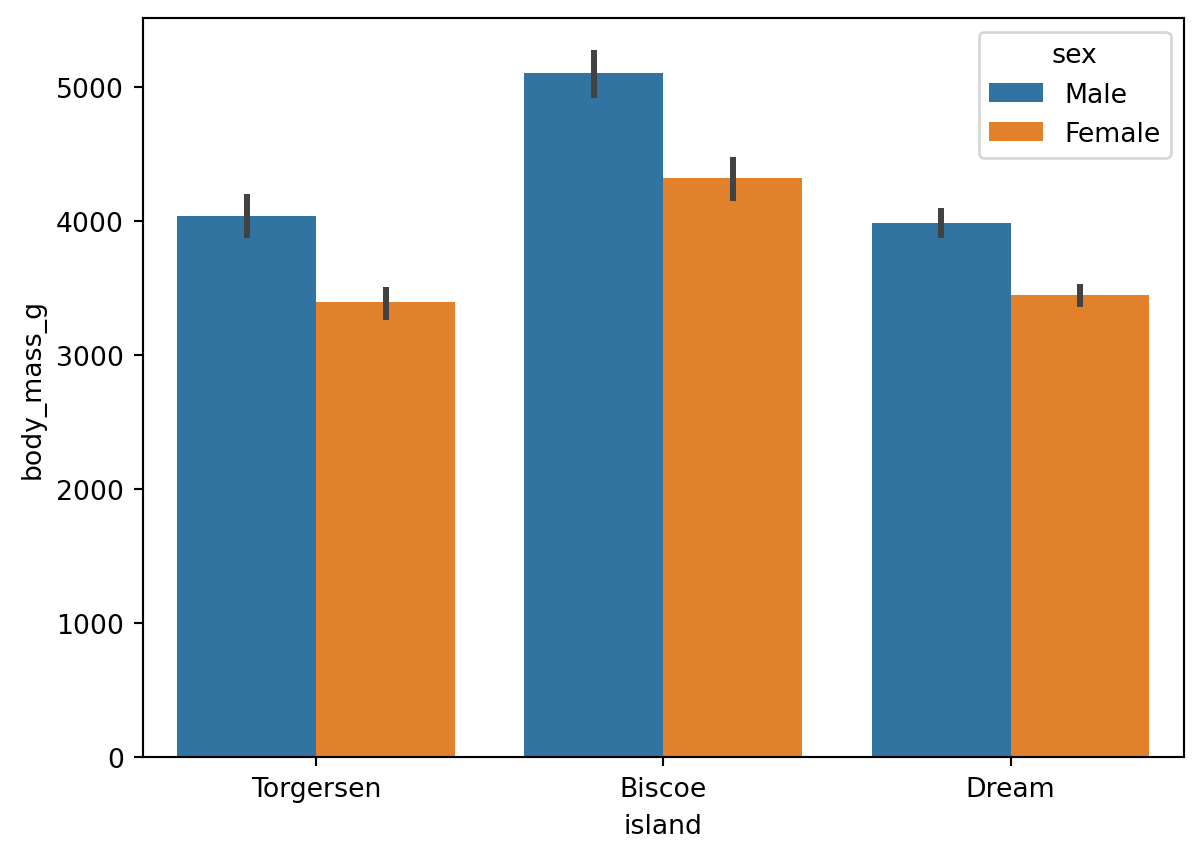
绘制柱状图时,除了 x、y 两个变量之外,还可以设置 hue 参数,从而绘制包含三个变量的柱状图。比如 图 1 中包含了 'island'、'body_mass_g'、'sex' 三个变量。
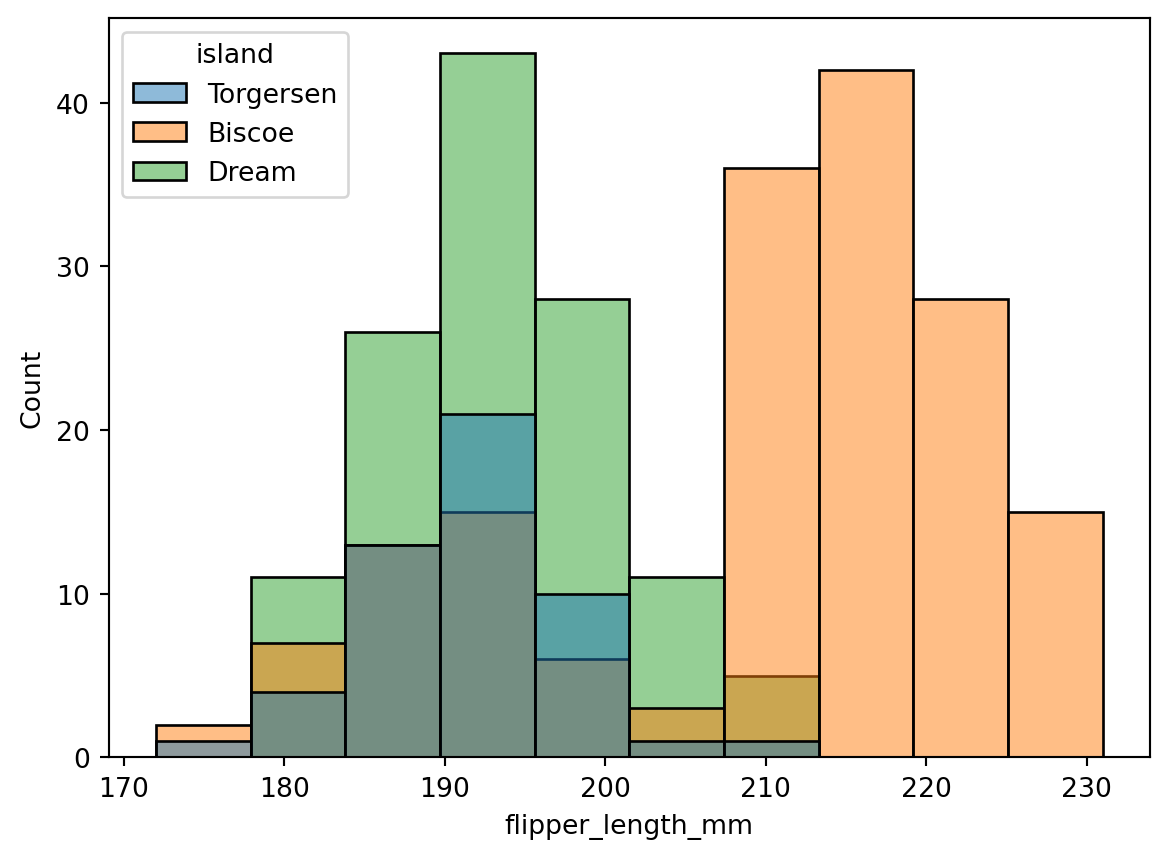
然而,有的图表类型不支持同时设置 x、y 和 hue 三个参数。比如直方图只支持 x 和 hue (见 图 2) x 轴展示鳍长的分布区间,y 轴展示每个区间内的企鹅数量,只涉及两个变量。
分面网格 (facetgrid) 是展示多元变量的常用方法。若干个小图表 (分面,facet) 以网格状排列,组成分面网格 (facetgrid) 。如果既想展示直方图,又想展示两个以上变量,可以使用分面网格。
通过 Seaborn 绘制分面网格的方法如下:
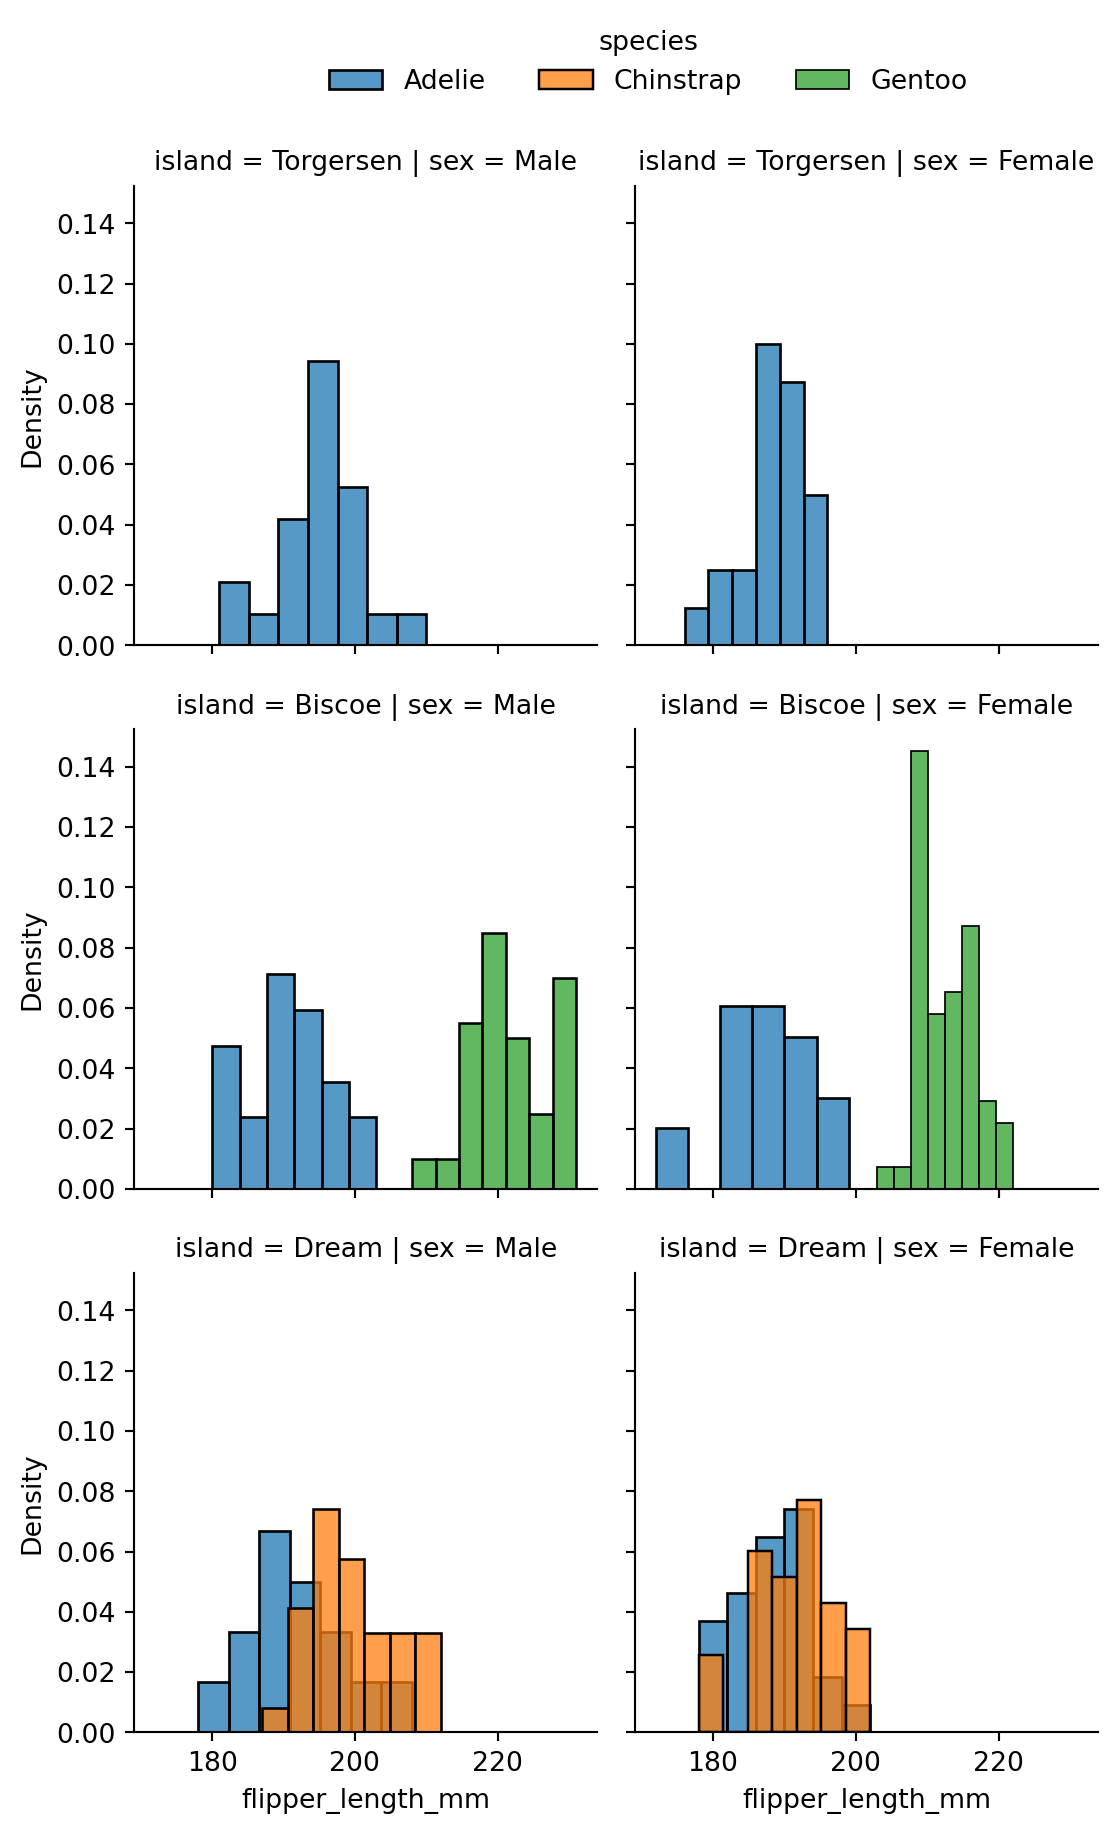
如 图 3,我们创建了一个 3×2 的分面网格,但此时只有网格,还需要通过 .map_dataframe() 方法来指定填充内容。
# 填充完整分面网格
# 第一步:创建分面网格
g = sns.FacetGrid(
data=df,
col='sex',
row='island',
hue='species',
)
# 第二步:填充直方图
g.map_dataframe(
sns.histplot,
x='flipper_length_mm',
stat='density', # 各组 bar 面积之和为 1
common_norm=False, # 每个分面内各颜色分别归一化
)
# 第三步:添加并调整图例
g.add_legend()
sns.move_legend(
g,
loc='lower center',
bbox_to_anchor=(0.5, 1),
ncol=3, # 图例列数
)
plt.show()stat 与 common_norm
stat='density' 用频率密度统计绘图,使直方图内所有 bar 的面积之和为 1。common_norm=False 配合 stat 使用,表示在同一分面中,每种颜色的 bar 面积之和分别为 1,而非所有颜色的 bar 面积总和为 1。
loc 与 bbox_to_anchor
同时设置两个参数,让图例的下边缘中点 (lower center) 位于整个网格图的 (0.5, 1) 位置。如果只设置 loc='lower center',图例将直接定位于整个网格图的中下部。
如 图 4 ,分面网格按岛屿分行、按性别分列、按种类分色,同时展示了四个变量 (鳍长、岛屿、性别、种类) 。通过分行和分列可以额外增加两个离散型变量;通过颜色区分还可再增加一个离散型变量。
注:由于分行和分列的特性,分面网格只能用于额外增加离散型变量。若要对连续型变量分面,可先将其划分区间,保存为新的离散型变量列,再用分面网格进行分行或分列。
刻度范围一致性
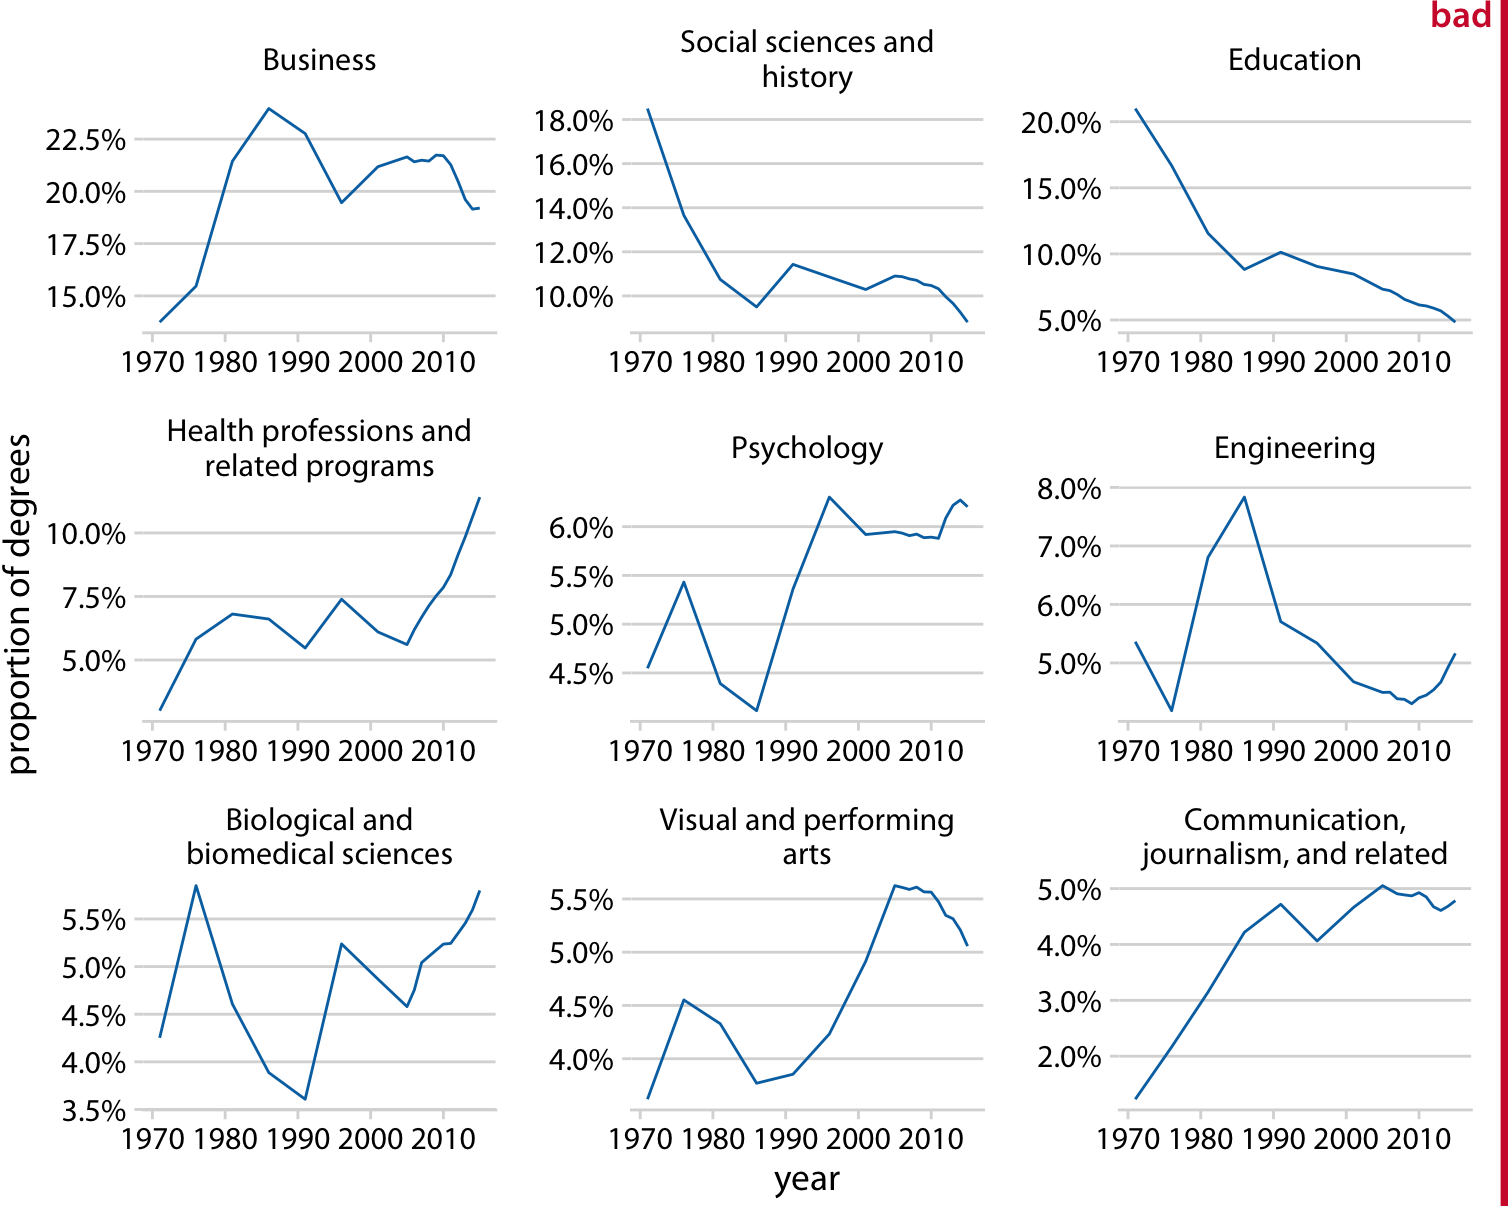
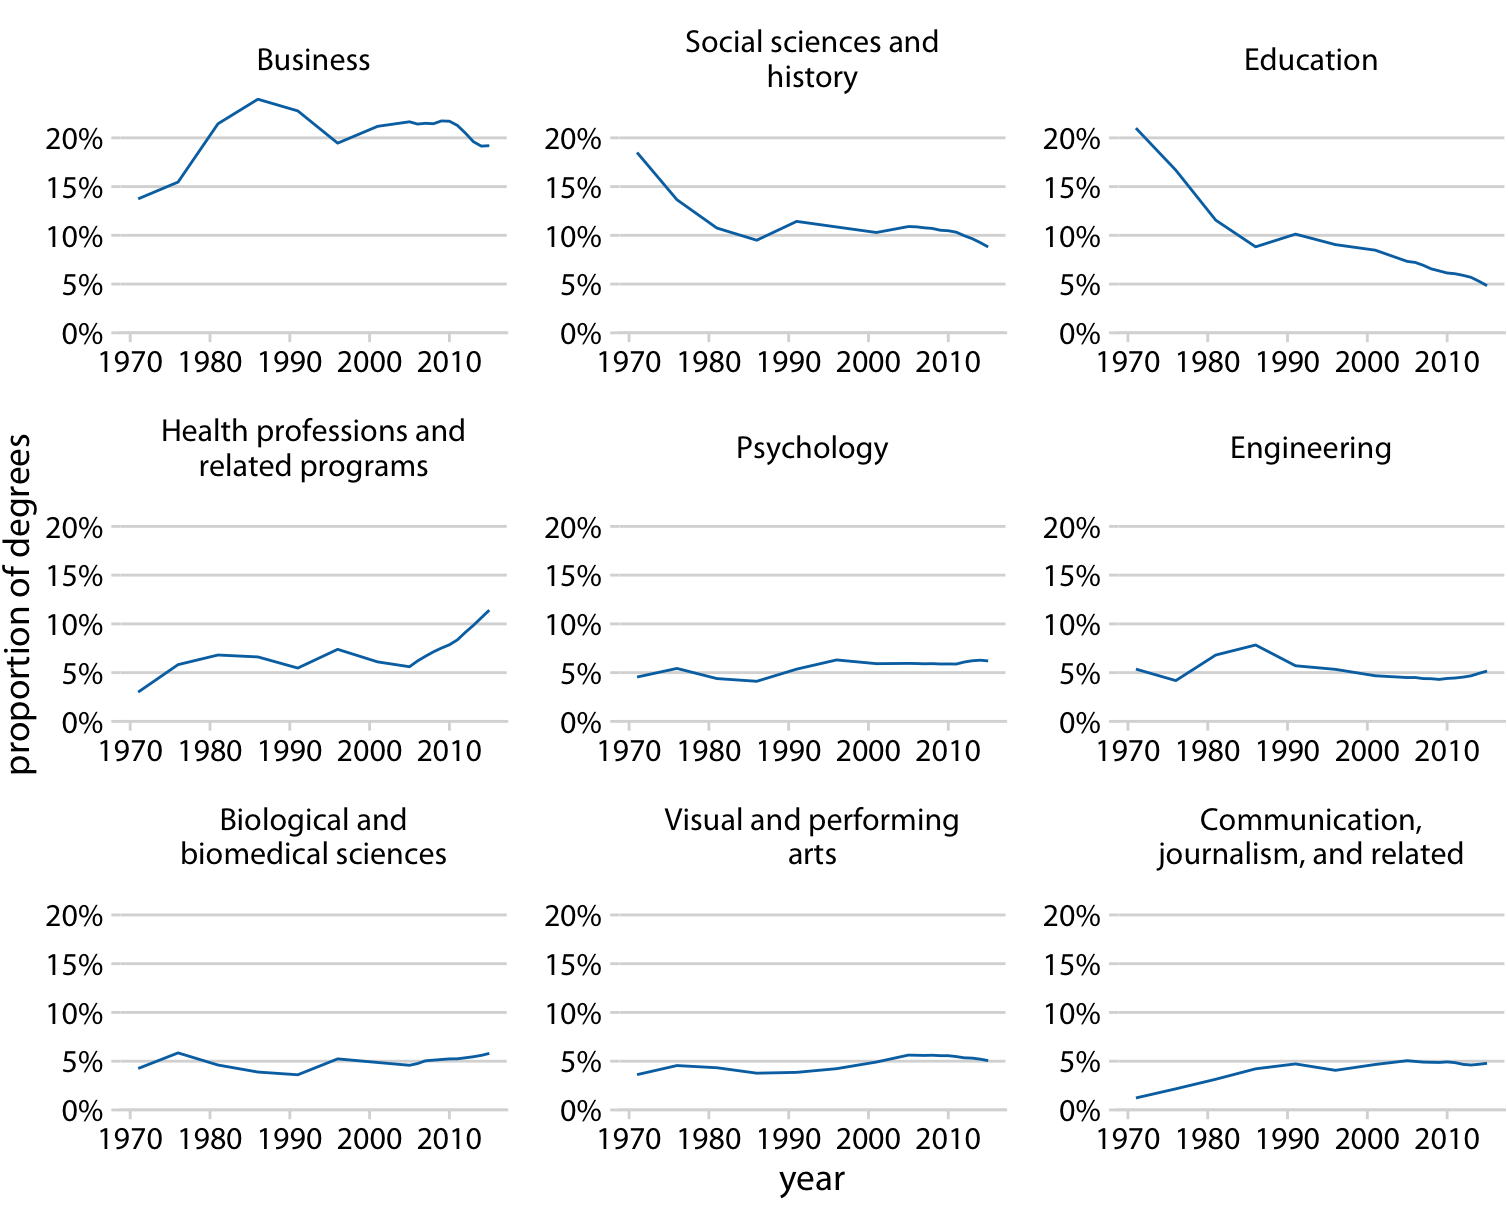
同时展示多个子图时,每个子图的刻度范围应当相同,因为读者往往默认多图的刻度范围一致,不一致会造成误判 (Wilke, 2019, pp. 257-258)。
在画散点图之前,需要注意区分 散点图 (scatter plot) 和 点图(point plot)。
注:点图又称 dot plot (Wilke, 2019, p.43)。以下对散点图与点图的区别的理解均基于 Seaborn 库,在其他语境下可能有所不同。
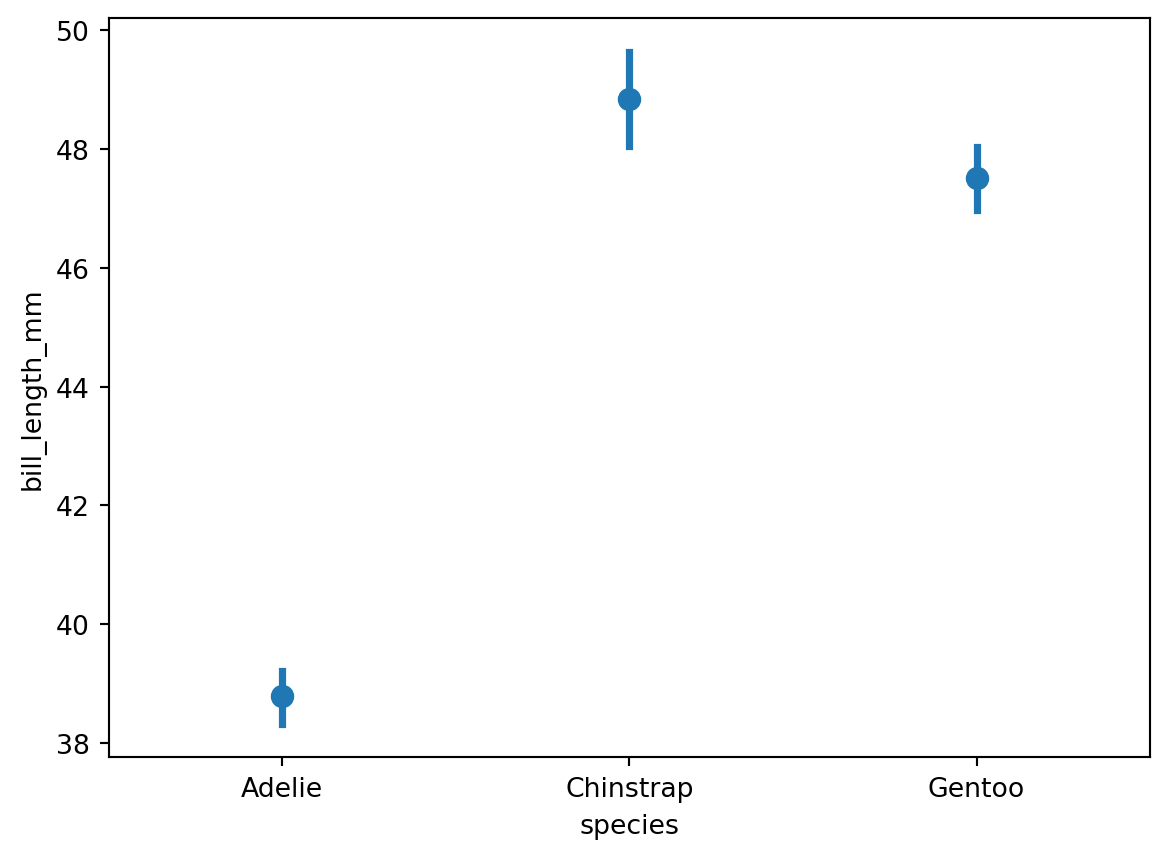
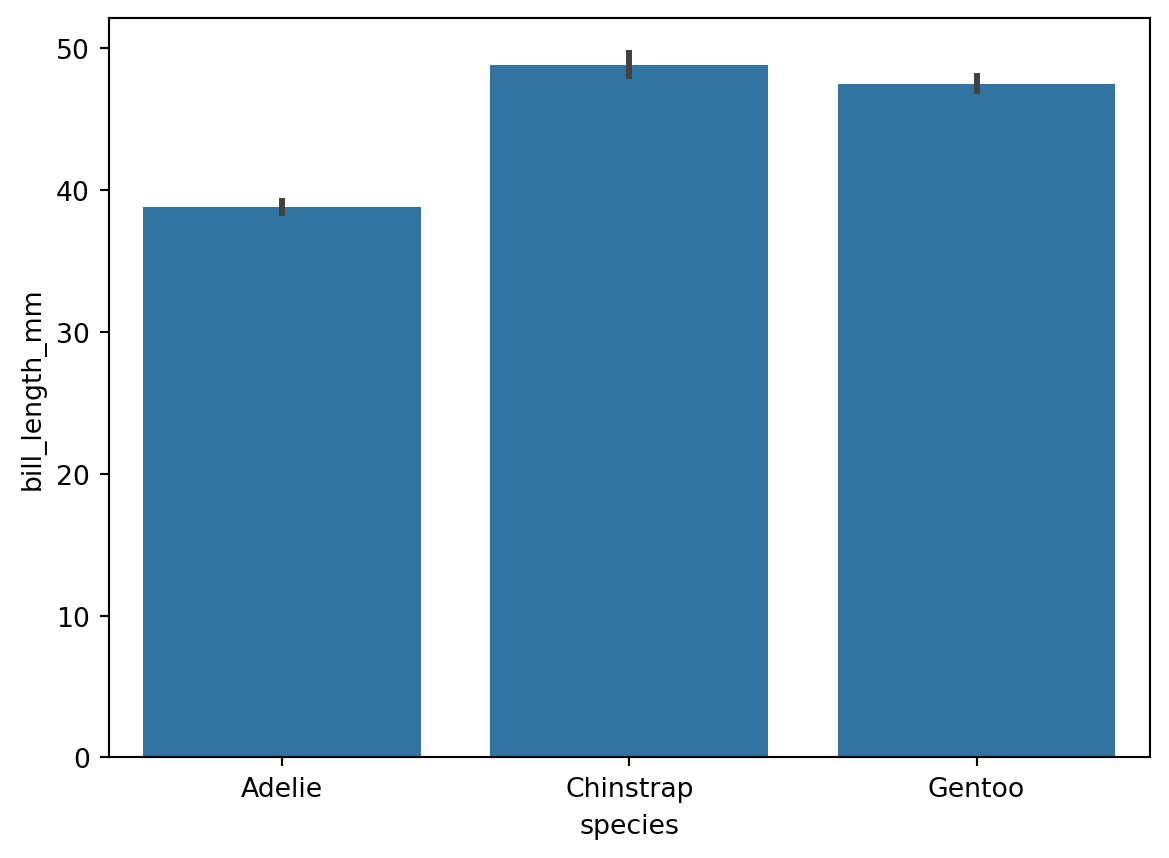
点图 (point plot) 可以起到类似柱状图的作用:点图中每个点所在的竖线相当于柱状图的 bar,点相当于柱状图中每个 bar 的顶边缘中点。像柱状图一样,点图可以用于展示 category-amount 型图表 (见 图 7 和 图 8) :
如 图 7 和 图 8 所示,点图和柱状图都可以表示 类型-数量 (category-amount) 关系。二者区别之一是:柱状图的 数量 (amount) 必须从 0 开始,而点图不需要。点图和柱状图都只展示纵坐标的平均值 (也可设置为其他统计值,如中位数) ,每个横坐标值只能对应一个纵坐标值。
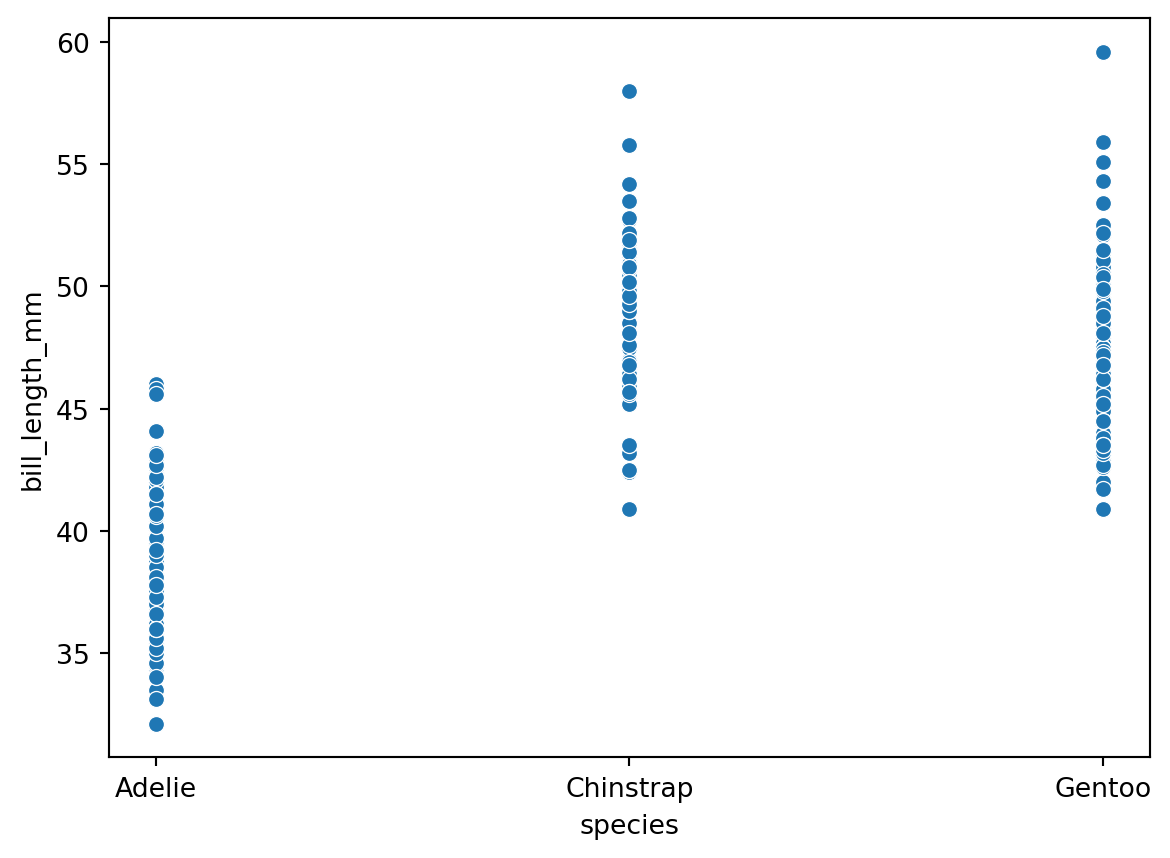
散点图 (scatter plot) 会显示每一个数据点 (见 图 9) :
散点图中每个横坐标可以对应多个纵坐标,而点图中每个横坐标只对应一个纵坐标。
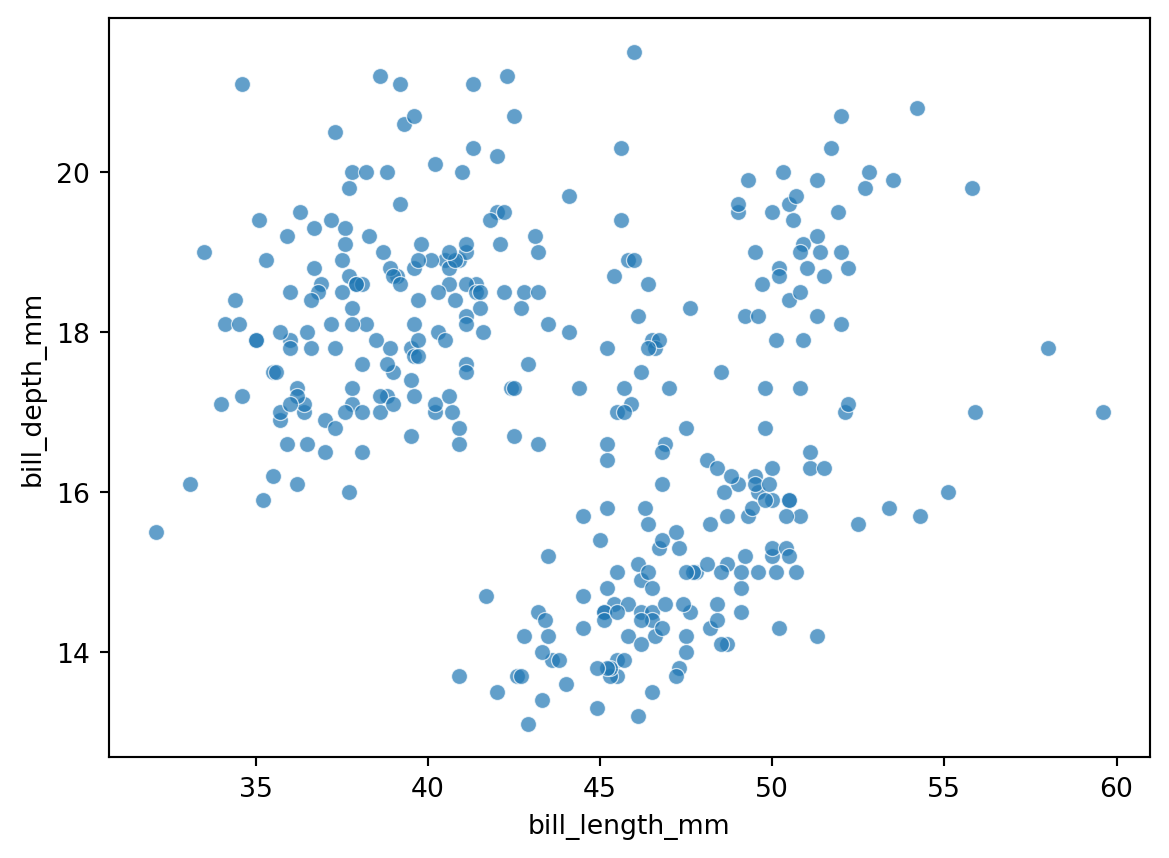
散点图常用于探究两个 (或多个) 变量之间的关系 (relationship) ,查看变量间是否存在关联性 (correlation) ,主要用于探究两种连续数值型数据之间的关系。因此散点图横轴通常为 ratio data,刻度自动显示为连续数值区间 (见 图 10) :
注:设置半透明有助于观察点的堆积,但若已使用渐变颜色区分某变量 (如 图 14) ,则不宜再使用半透明。
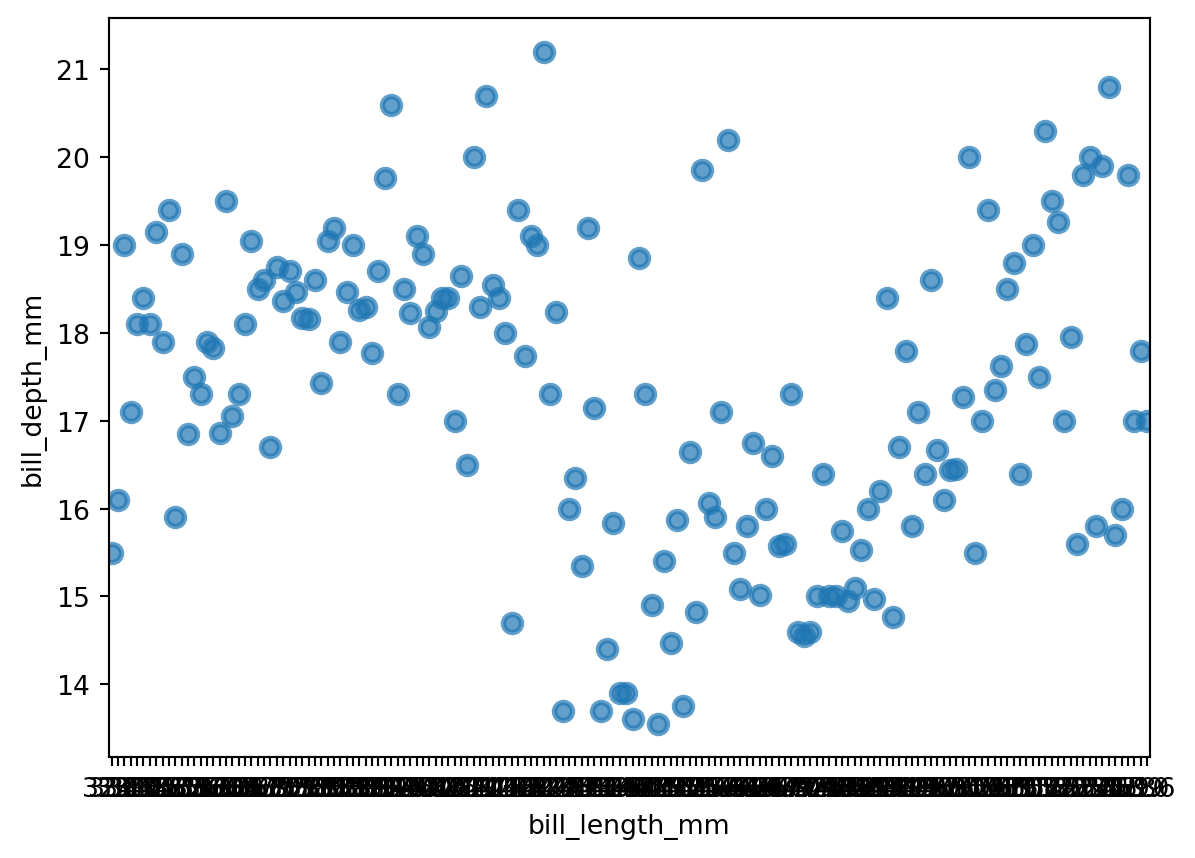
点图 (point plot) 使用 ratio data 作横轴时,每个点会对应一个特定刻度,效果如 图 11 所示:
注:虽然 图 10 和 图 11 点的分布看似相似,但点图中每个横坐标有且仅有一个对应的点,散点图可以对应多个。此外,
sns.pointplot()不支持调整点的大小,sns.scatterplot()支持。
因此,点图不适用于横坐标为连续型数据且刻度过多的情况,更适用于横坐标为离散型数据且刻度不宜过多的场景。散点图 则相反,更适用于 ratio-ratio 数据。
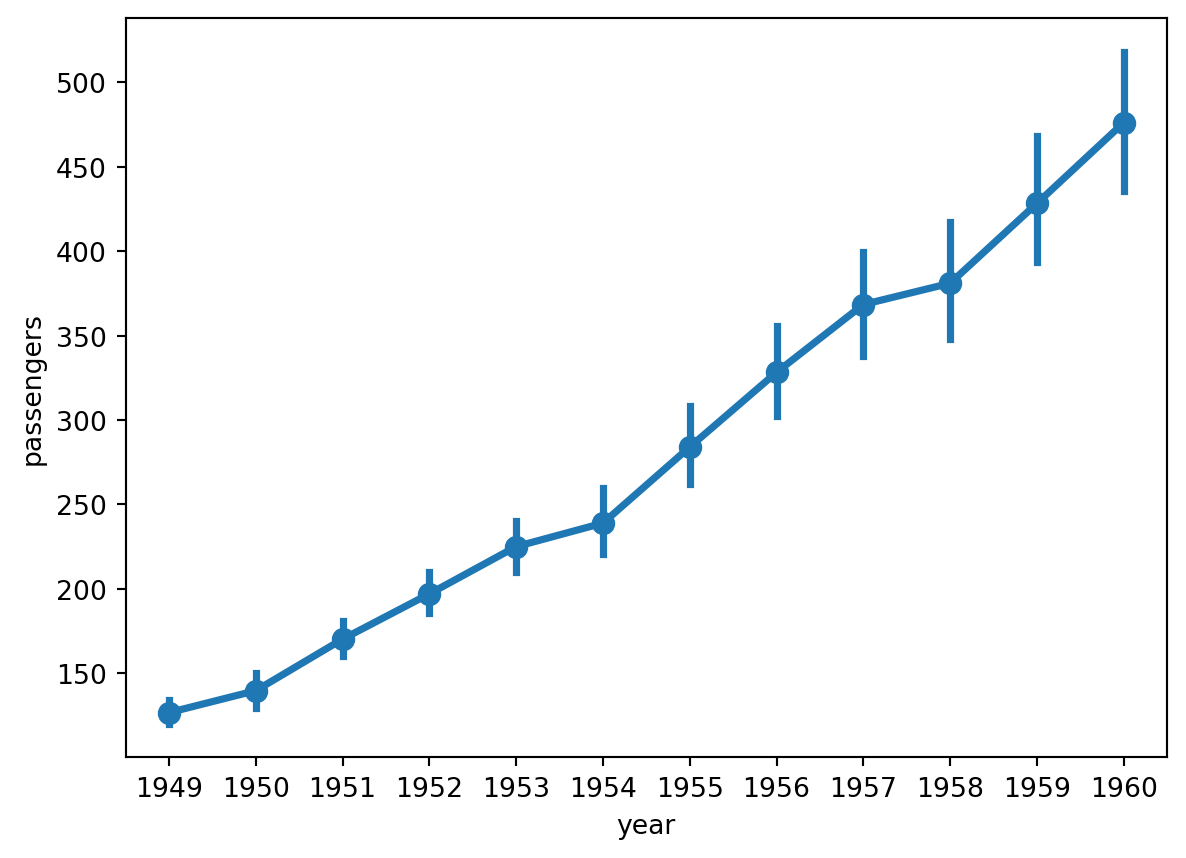
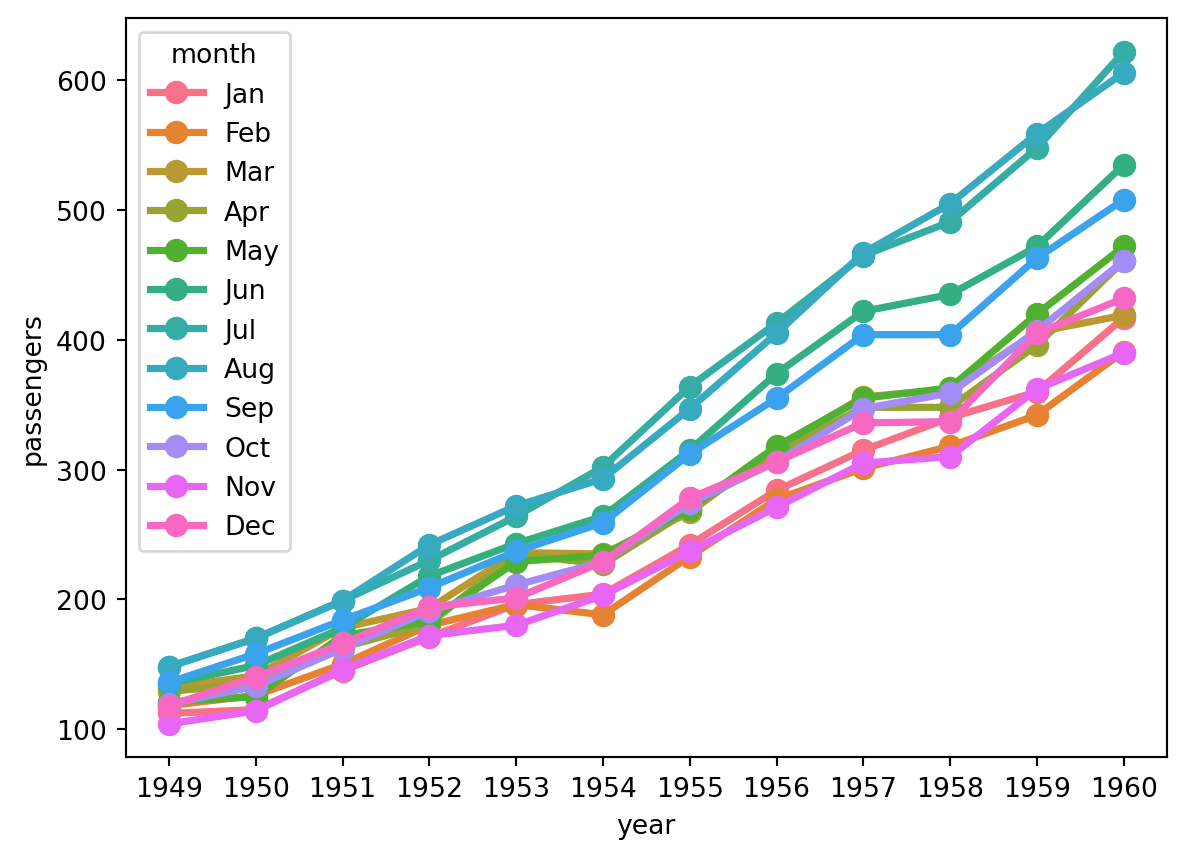
点图的另一个特点是点与点之间可以连线,适用于横轴为 ordinal 或 interval data 的情况。比如 图 12 中年份为 interval data,连线可以表示乘客量随年份的变化趋势;而 图 7 中横坐标为企鹅种类 (nominal data) ,顺序没有意义,因此不画连线。
这种点图变得和折线图非常类似,我们将在 折线图 Line Plot 中继续讨论。
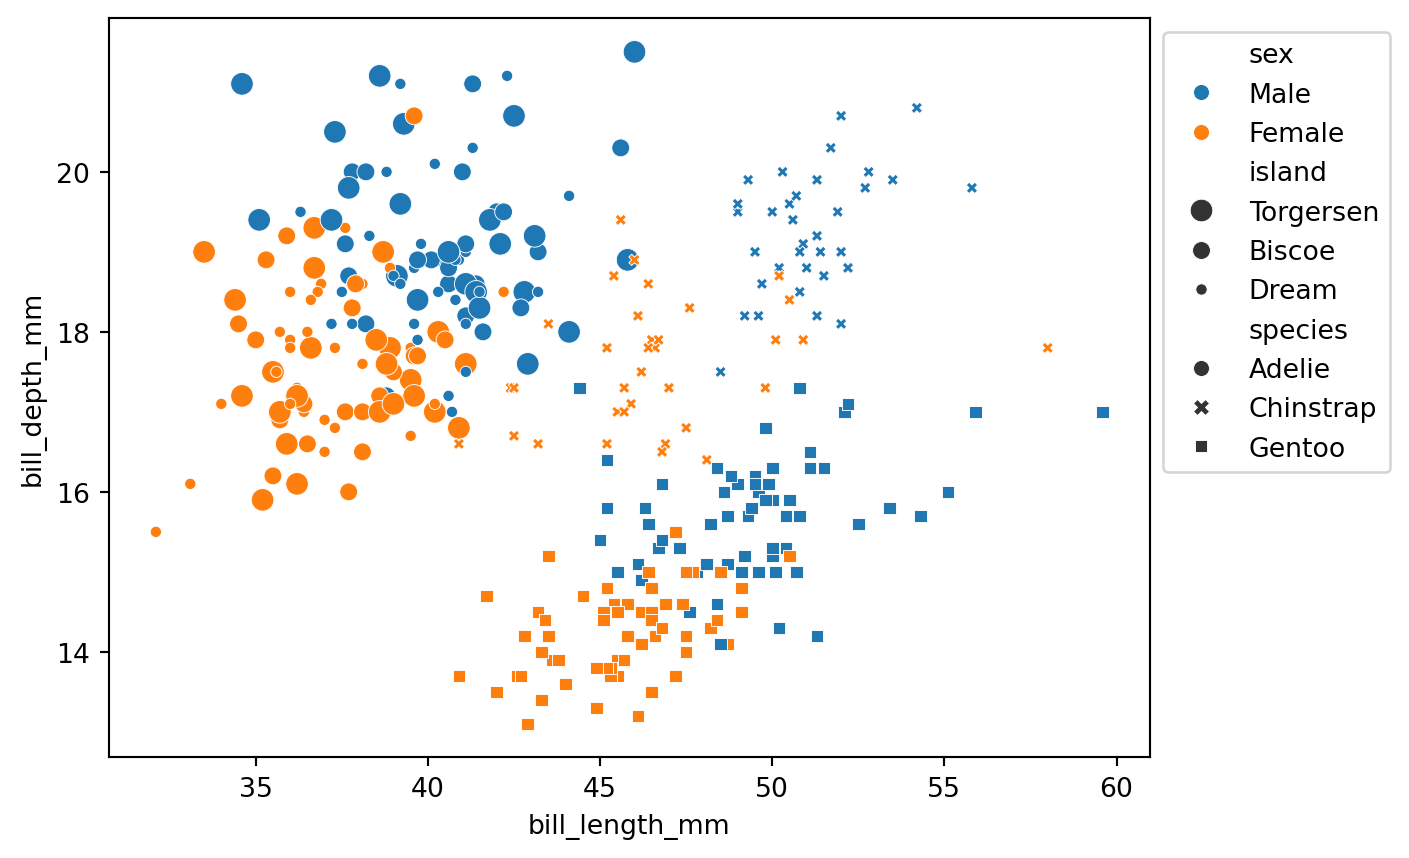
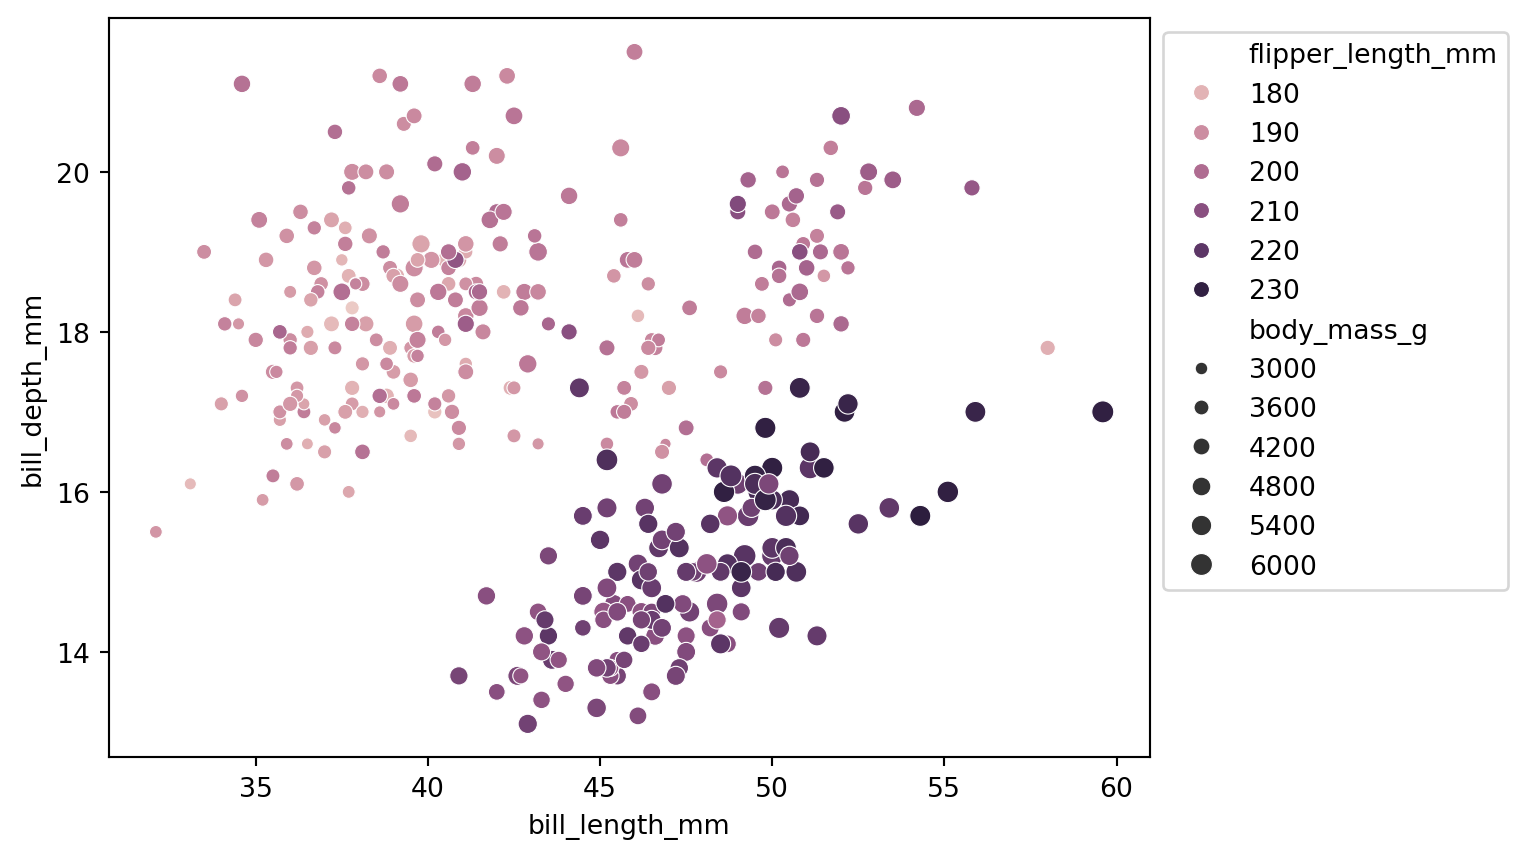
除了 x、y 轴展示的两种连续变量之外,还可以通过设置 hue (点颜色) 、size (点大小) 、style (点形状) 等参数来引入其他变量。hue 和 size 可以应用于连续型或离散型变量;style 只能应用于离散型变量,因为点形状无法连续渐变 (仅限 Seaborn 库) 。
比如 图 13 同时引入了三个离散变量:
图 13 中,除横纵轴的两个连续变量 (喙长、喙深) 外,还设置了三个离散变量 (性别、岛屿、种类) 。再比如 图 14 引入了两个连续变量:
注:虽然
hue和size可以应用于连续型变量,但其图例并非严格连续的。
多变量散点图与分面网格的区别见 表 1:
| 维度 | 多变量散点图 | 分面网格 |
|---|---|---|
| 视图 | 全局,所有点在同一坐标系 | 分格展示,便于子图对比 |
| 图形空间 | 少,只需一张图 | 多,需创建多个子图 |
| 连续变量 | 可直接引入,自动生成图例 | 需手动划分区间保存为新变量 |
| 视觉复杂度 | 信息集中,可能过于拥挤 | 各子图独立,阅读负担较低 |
| 图例依赖 | 需反复对照图例 | 子图标题直接说明 |
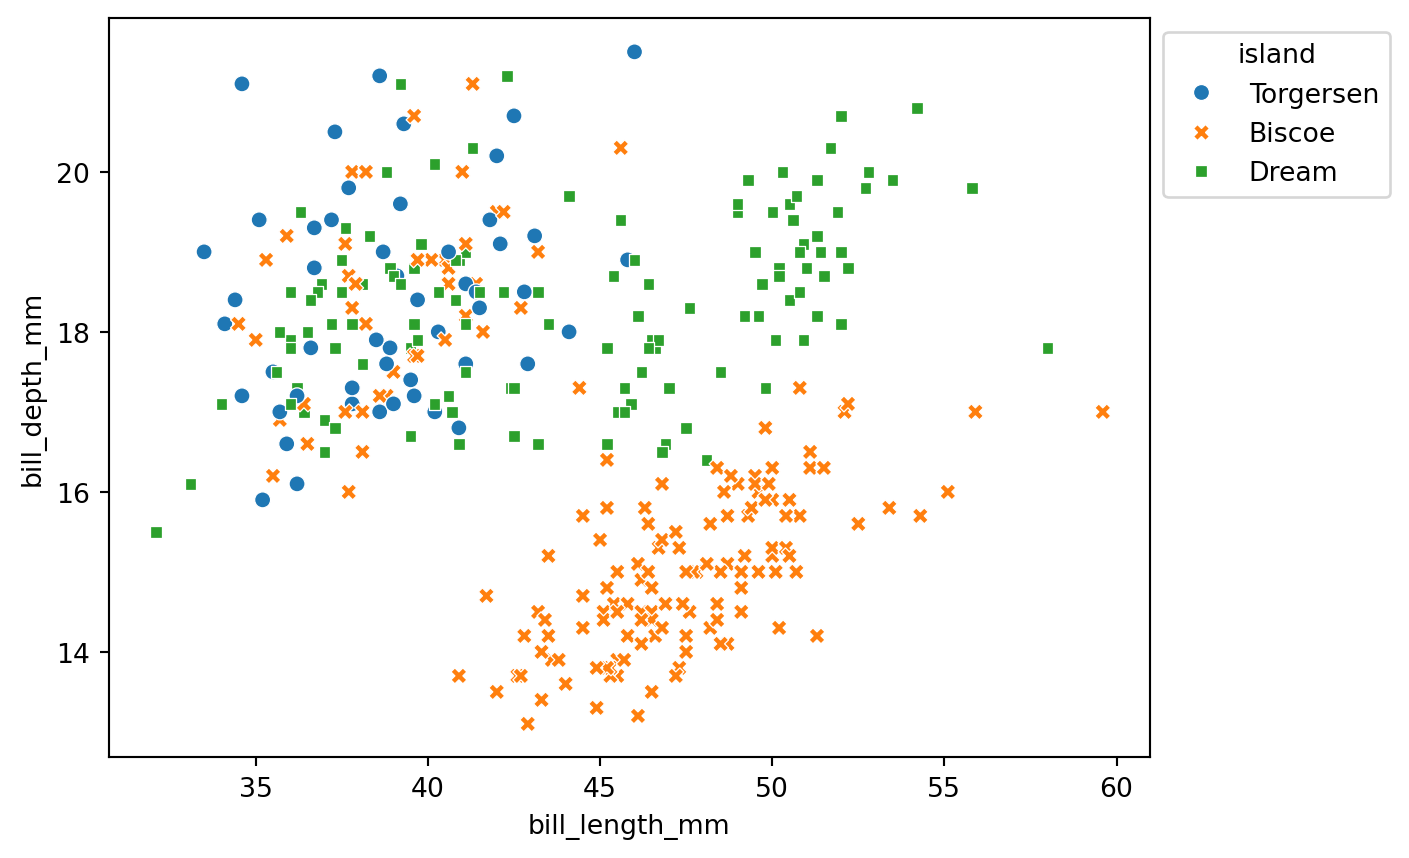
为了让散点图更易辨认,建议 同时使用颜色和形状区分同一变量 (Wilke, 2019, pp.243-247),如 图 15:
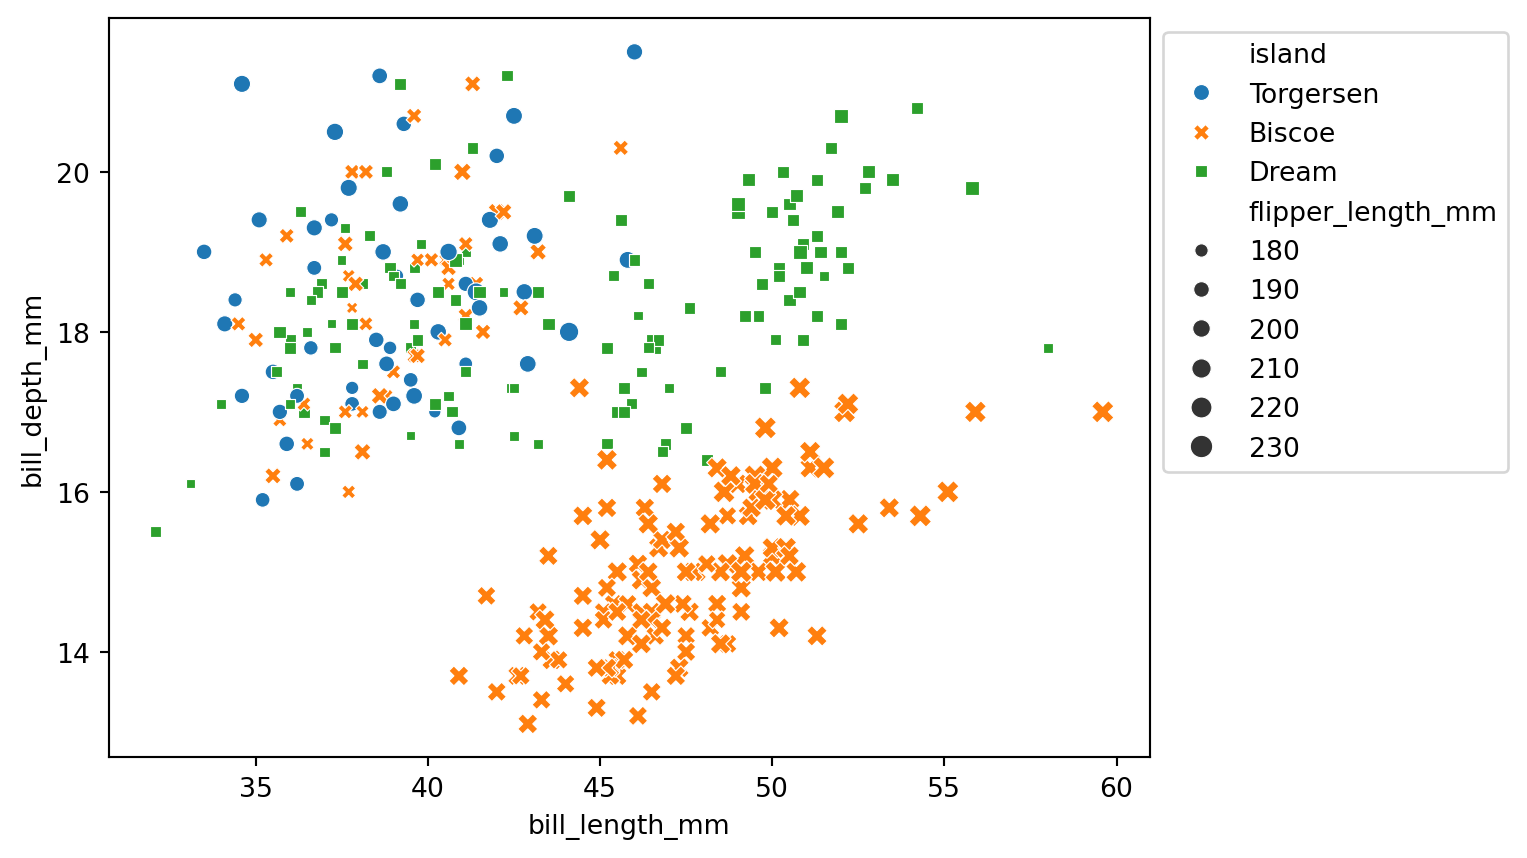
此外,尽量不要在同一图表内同时使用 style 和 size 控制两个不同变量,因为形状改变后大小的区分会变得不够直观 (见 图 16) :
其他注意事项:
这些细节将在 小节 4 中进一步讨论。
对数尺度 (logarithmic scale) 是一个非线性测量尺度,适用于有较大范围差异的数据,如里氏震级、声学音量、光学光强、溶液 pH 值等。为此类数据绘制散点图时,可将坐标轴设置为对数尺度 (默认为线性尺度,如 图 10 中 x 轴刻度 35, 40, 45, 50 是线性增长的数字) ,让原本拥挤的数据点变得较为均匀,更容易观察 (维基百科 - 对数尺度) 。
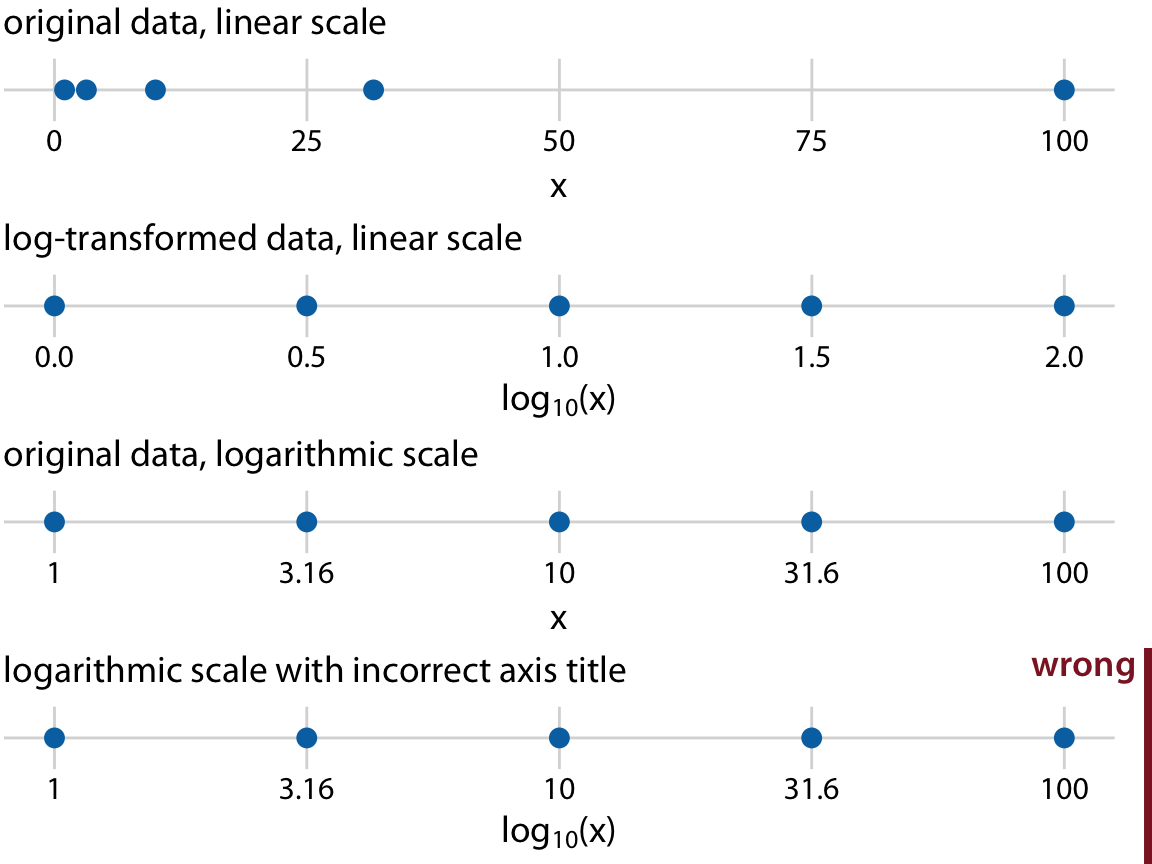
Wilke (2019, p.17) 以 \((1, 3.16, 10, 31.6, 100)\) 为例画了四个数轴 (图 17) ,其中 \(10^{0.5} = \sqrt{10} \approx 3.16\),\(10^{1.5} \approx 31.6\)。
如 图 17,四个数轴含义如下:
对比第一个和第三个数轴:对于同一组数据,线性尺度中分布不均匀的点,在对数尺度中变得均匀。这样调整有助于观察分布不均匀的数据,尤其是呈指数型增长趋势的数据。
需要注意的是,改用对数尺度只改变了轴刻度的展示方式,并没有改变数据点的值。因此,对于仅改用刻度尺度、不改动原数据的图,不可以将轴标题写作 \(\log_{10}(x)\) (见第四个数轴) 。
对数尺度适用的情况及其优缺点:
适用情况
优点
缺点
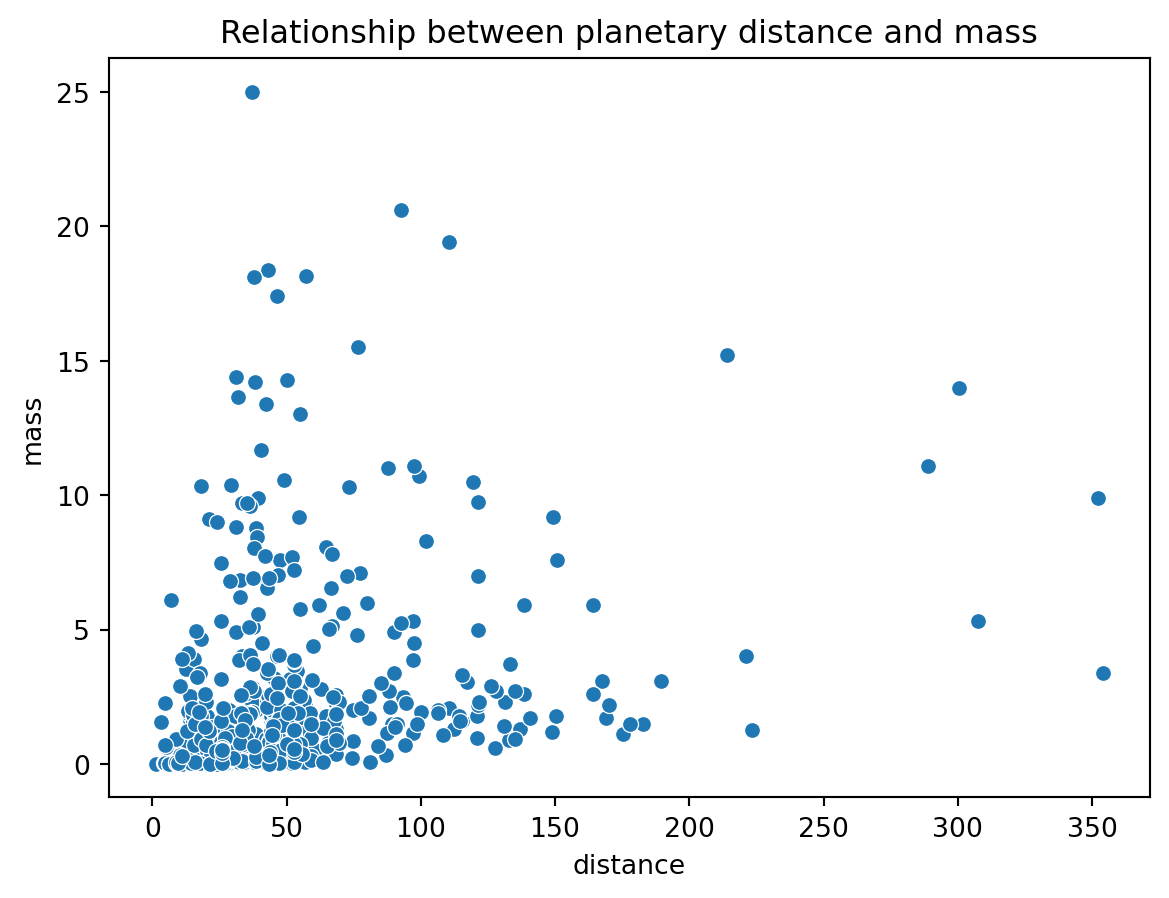
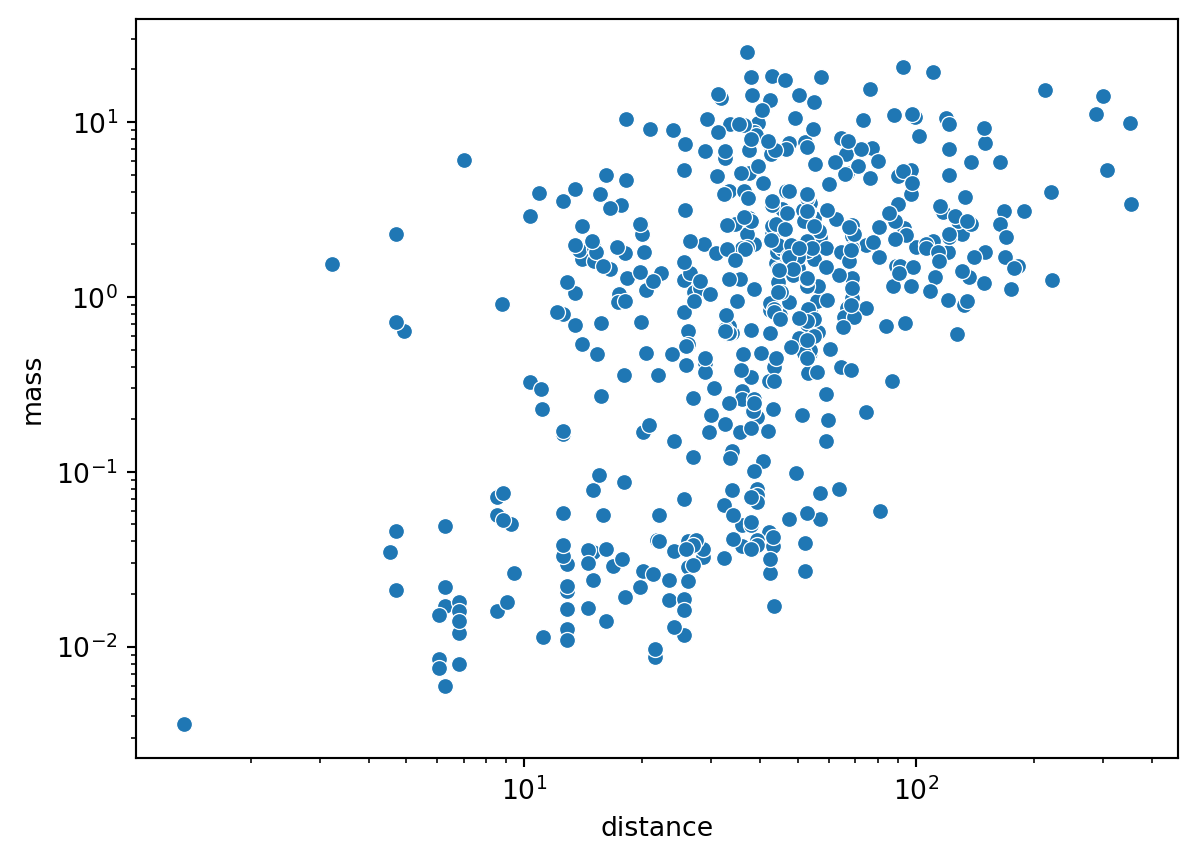
例如,图 18 中数据范围差异较大且左边过于集中——可以改用对数尺度 (图 19) 。
注:图 19 中,刻度 \((10^0, 10^1, 10^2, ...)\) 是等距的对数尺度刻度。每两个大刻度间的小刻度代表等差的实际数值,如从 \(10^0\) 到 \(10^1\) 之间分别为 \(2, 3, ..., 9\),从 \(10^1\) 到 \(10^2\) 之间分别为 \(20, 30, ..., 90\),以此类推。
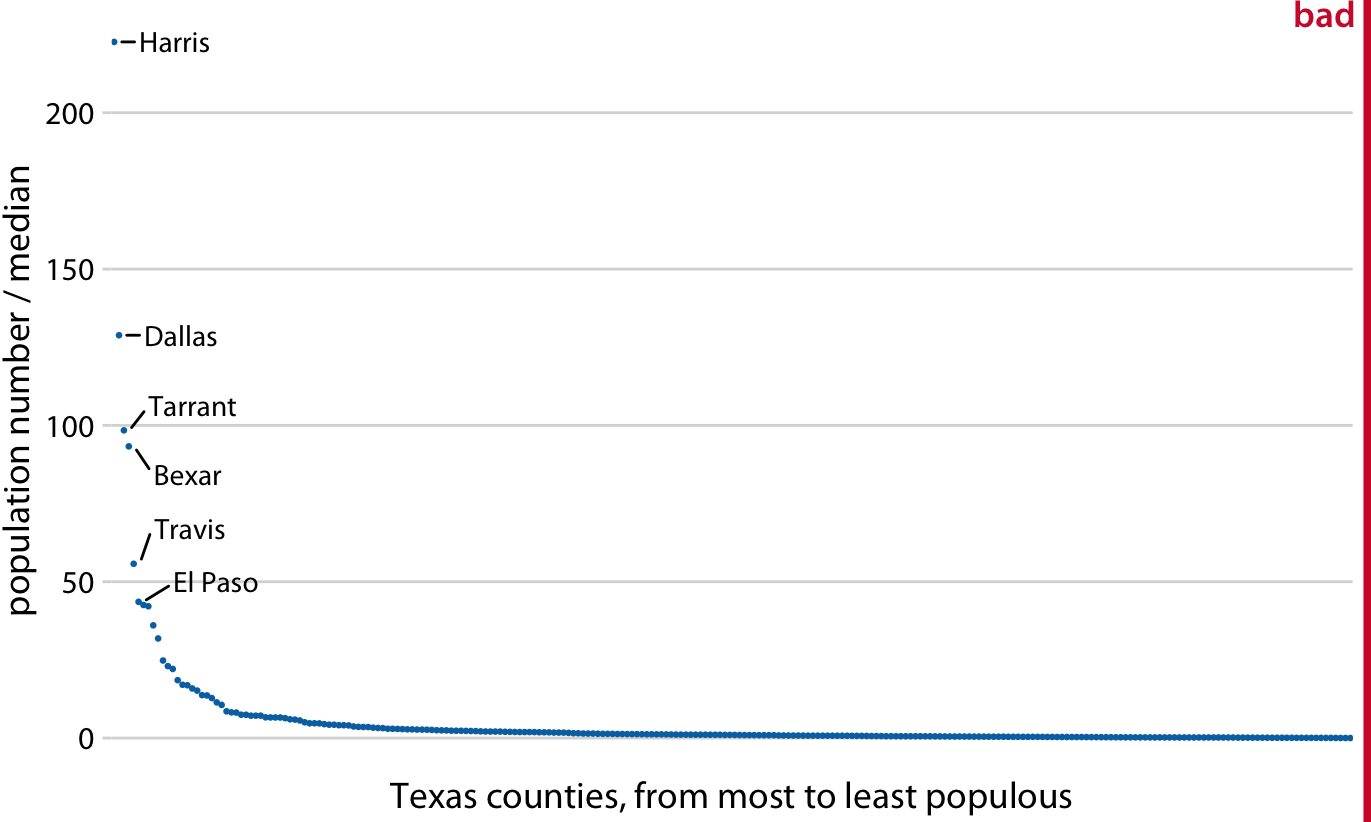
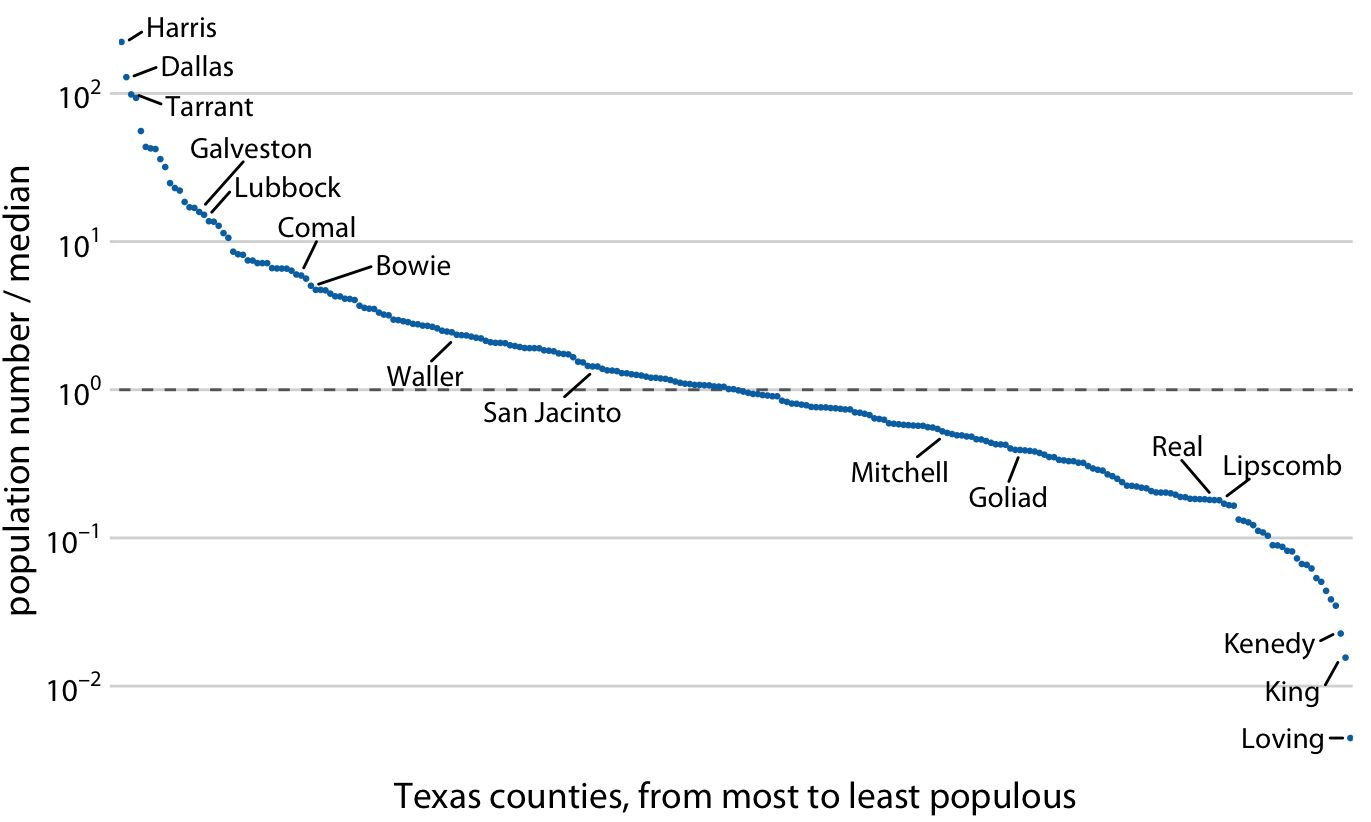
由于对数尺度无 0 值 (以 1 即底数的 0 次方为原点) ,对数尺度适合用于展示比例数据。如 Wilke (2019, pp.18-20) 将德克萨斯州各县人口除以人口中位数作为纵轴,用对数尺度 (图 20) 展示了各县人口在中位数附近的分布 (比值为 1 时说明该县人口恰好为中位数) 。
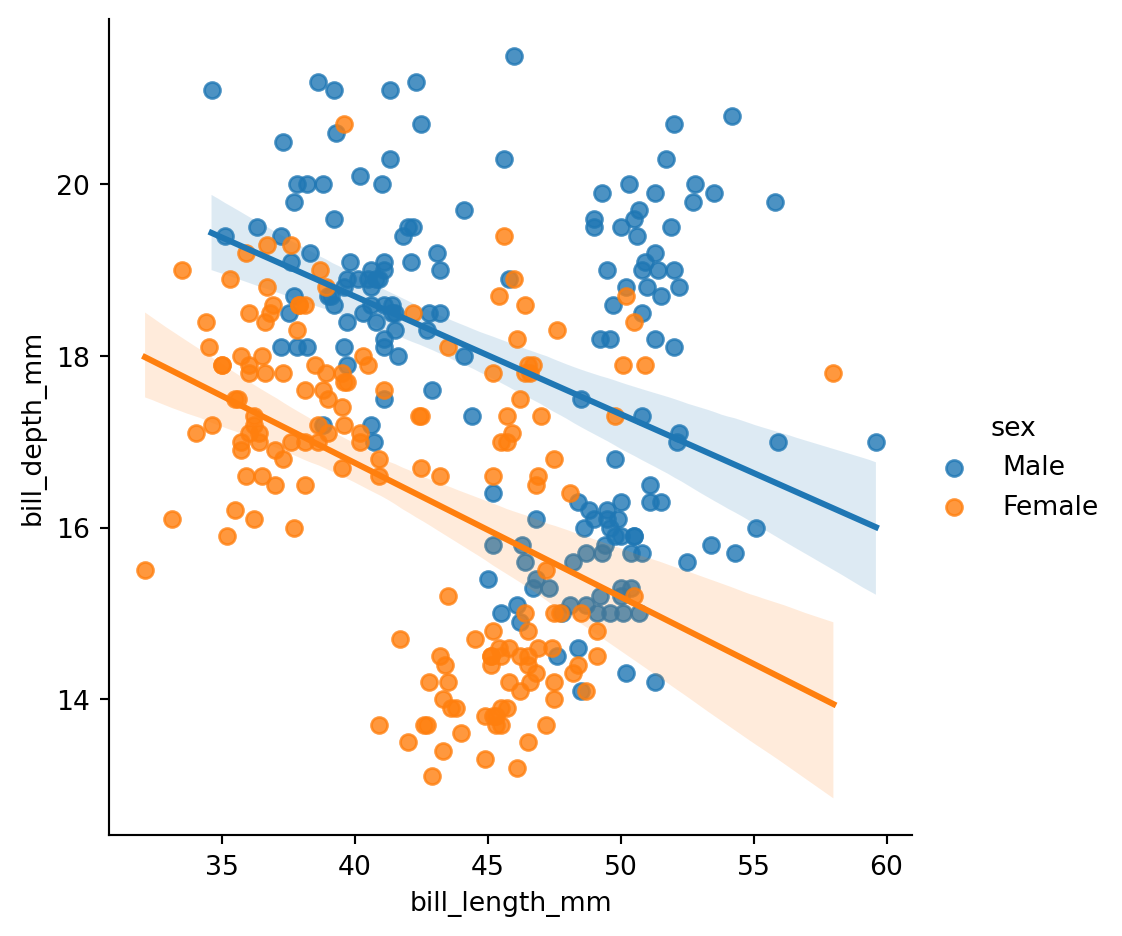
回归图 (regression plot) 将散点图拟合成一条线,用于展示两个变量之间的关系。最常见的是 线性拟合 (linear fitting) ,即将散点图拟合成线性回归线。置信区间用于显示回归线 (作为估计值) 的不确定性:置信水平 95% 时,真实值有 95% 的可能落在该区间内。如 图 22 ,直线是线性回归线,阴影部分是置信区间。
sns.lmplot() (linear model plot) 默认使用 95% 置信区间来衡量回归线的不确定性。
注:
hue参数仅适用于离散型数据。
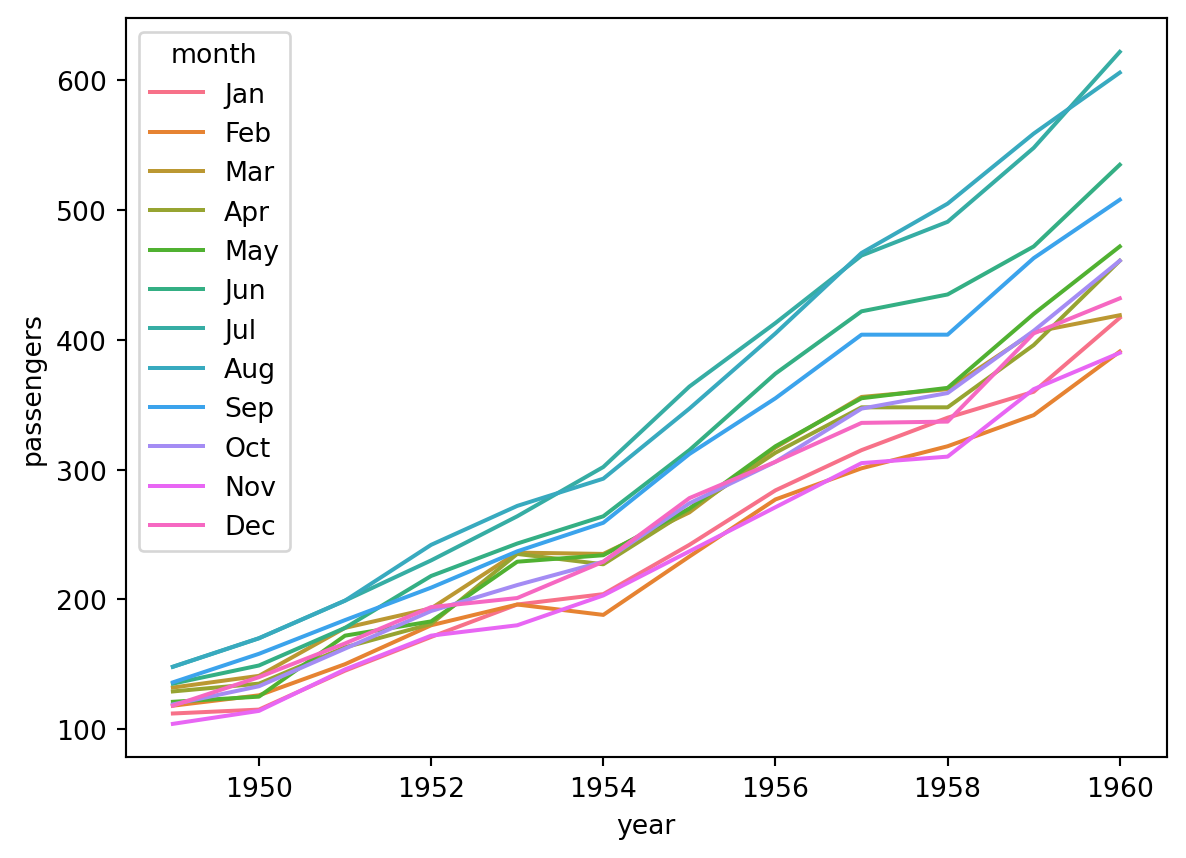
散点图 (scatter plot) 中数据点独立存在,通常用于探索 两个变量 之间的相关性或分布,数据点之间无先后关系。折线图 (line plot) 中数据点通过线段连接,强调数据的连续性或变化趋势,通常用于时间序列数据,展示 一个变量 随时间的变化,数据点之间存在先后关系。
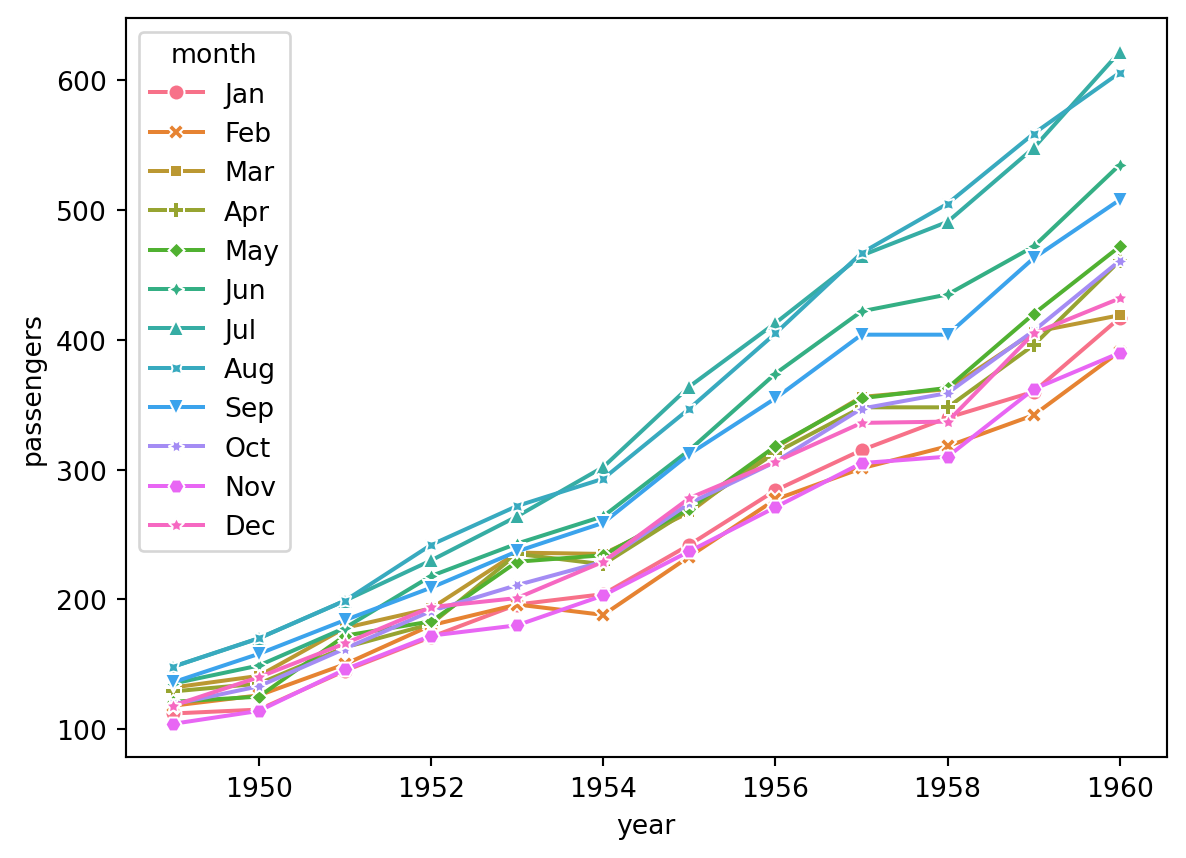
如 图 23 ,展示了某航空公司每月乘客量随年份增长的变化:
也可以通过设置 markers=True 和 dashes=False 展示折点 (图 24) :
当折点很多时,不建议在折线图中展示折点,过多的折点会阻碍阅读;清晰的线条更能彰显变化趋势 (Wilke, 2019, pp. 135-137)。
也可以用点图达到类似效果 (见 图 25) ,但 sns.pointplot() 不可用不同点形状区分变量,也不可去除点,因此要观察变量随时间的变化趋势,最好选择 sns.lineplot()。
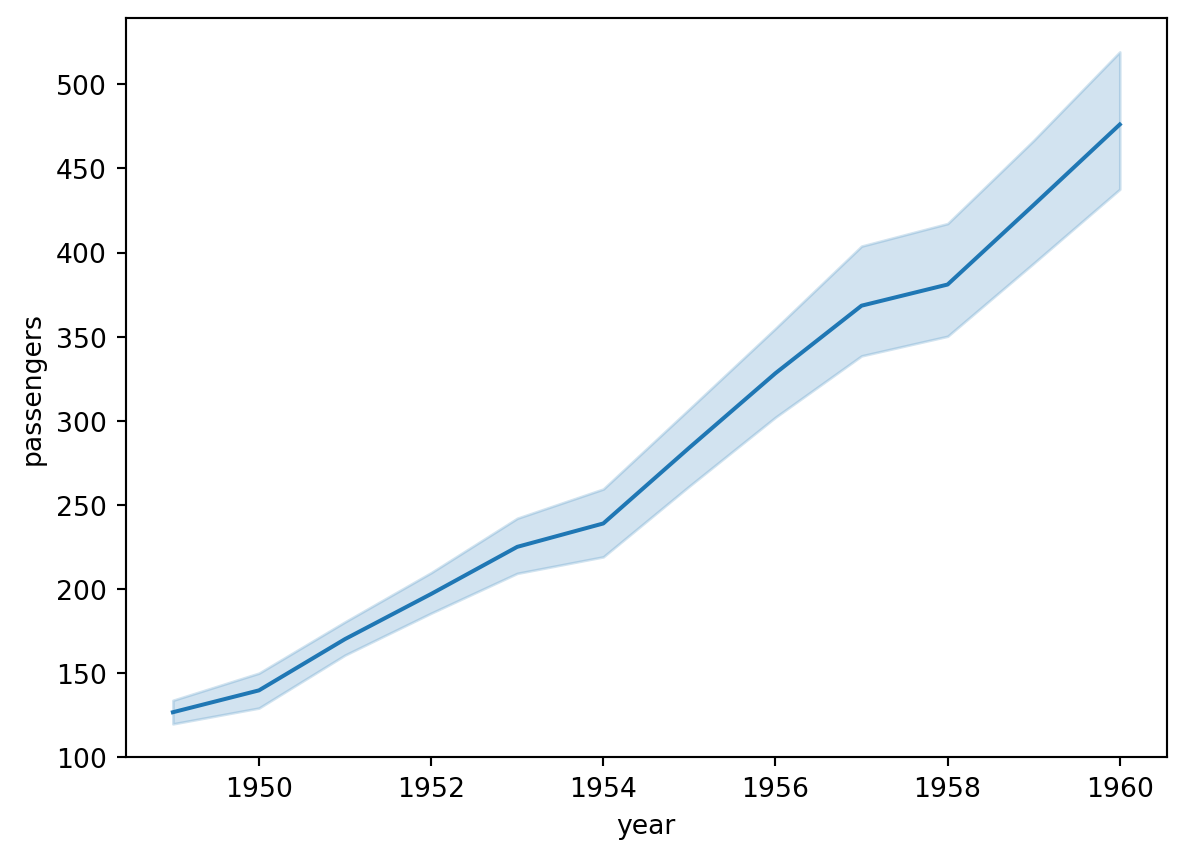
当 y 轴变量在每个时间点上有多个值,且未对其进行颜色区分时,sns.lineplot() 会自动生成平均值折线和误差区间 (默认 95% 置信水平) ,见 图 26:
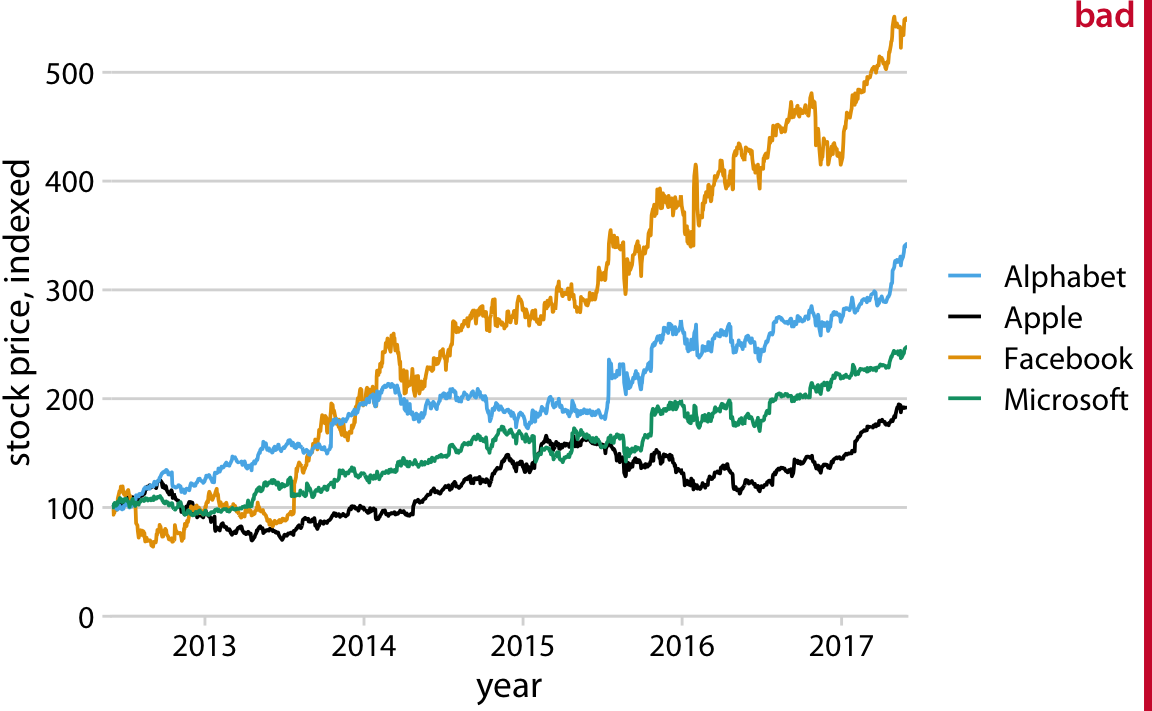
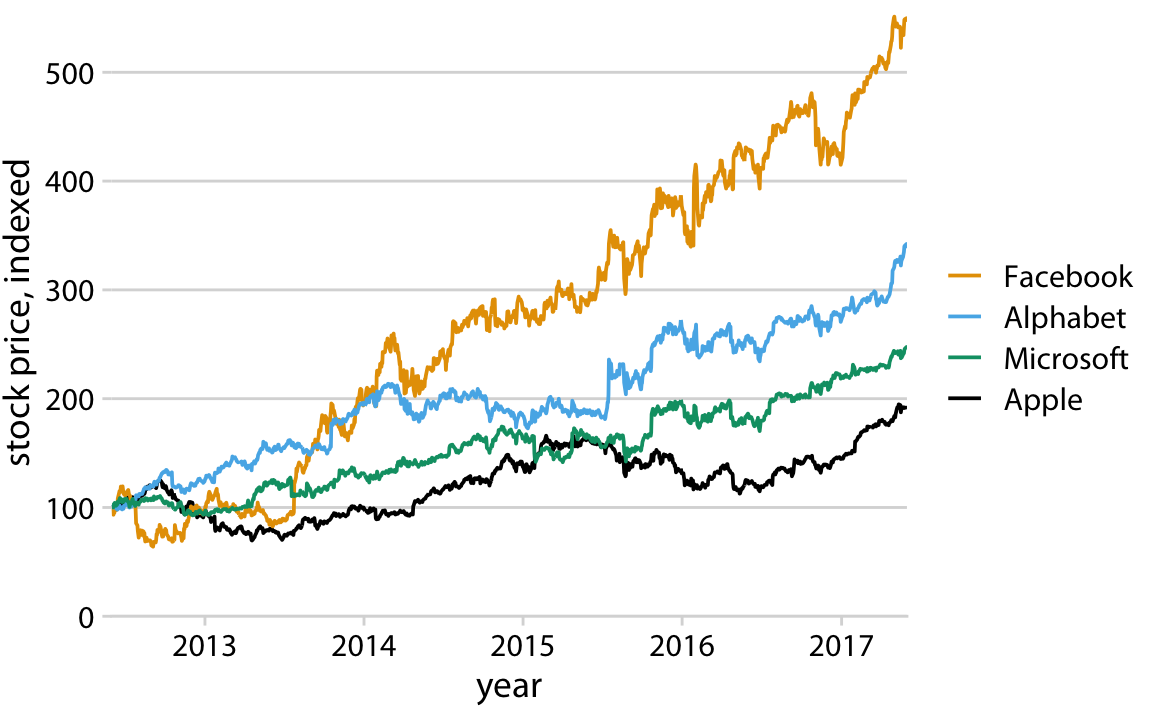
在折线图中使用颜色区分线条时,需要注意:
图 27 中图例和线条颜色顺序不一致,会增加阅读困难,Wilke (2019, p.248) 提供了反面案例:
相反,图 28 中图例和线条颜色顺序相符,Wilke (2019, p.249) 提供了改良后的图表:
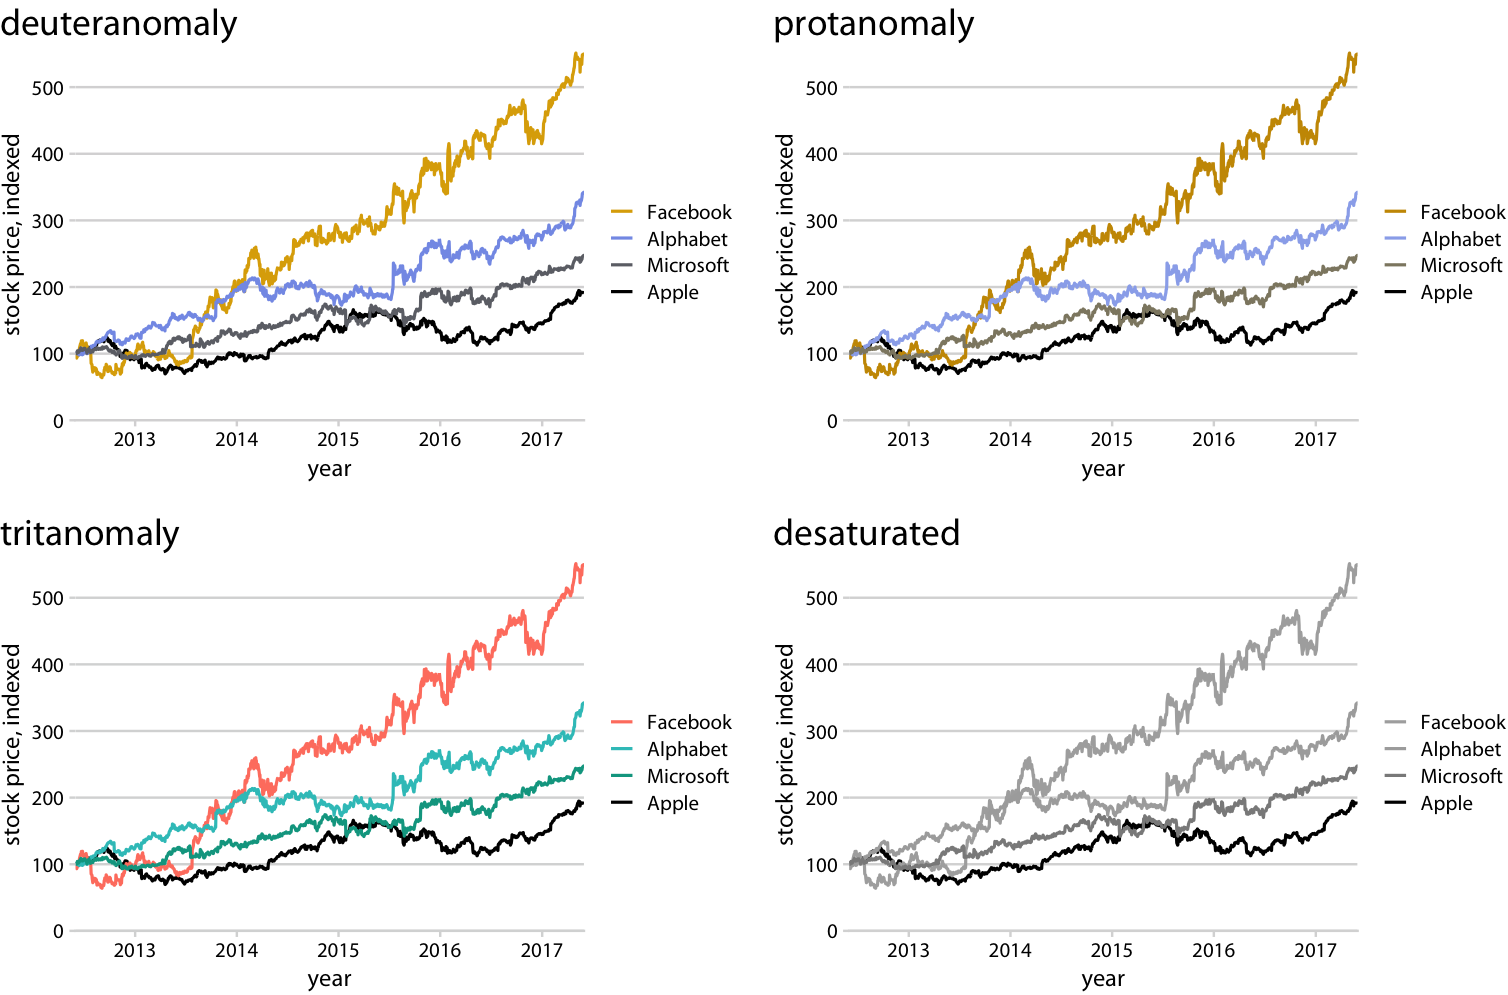
Wilke (2019, p.250) 还展示了 图 28 在不同色觉缺陷模拟下及去除饱和度后的效果 (图 29) :
由 图 29 可见,图 28 的配色对三种色觉缺陷患者均可区分,去除饱和度后也能通过明度区分。因此图例与线条颜色顺序匹配尤为重要。
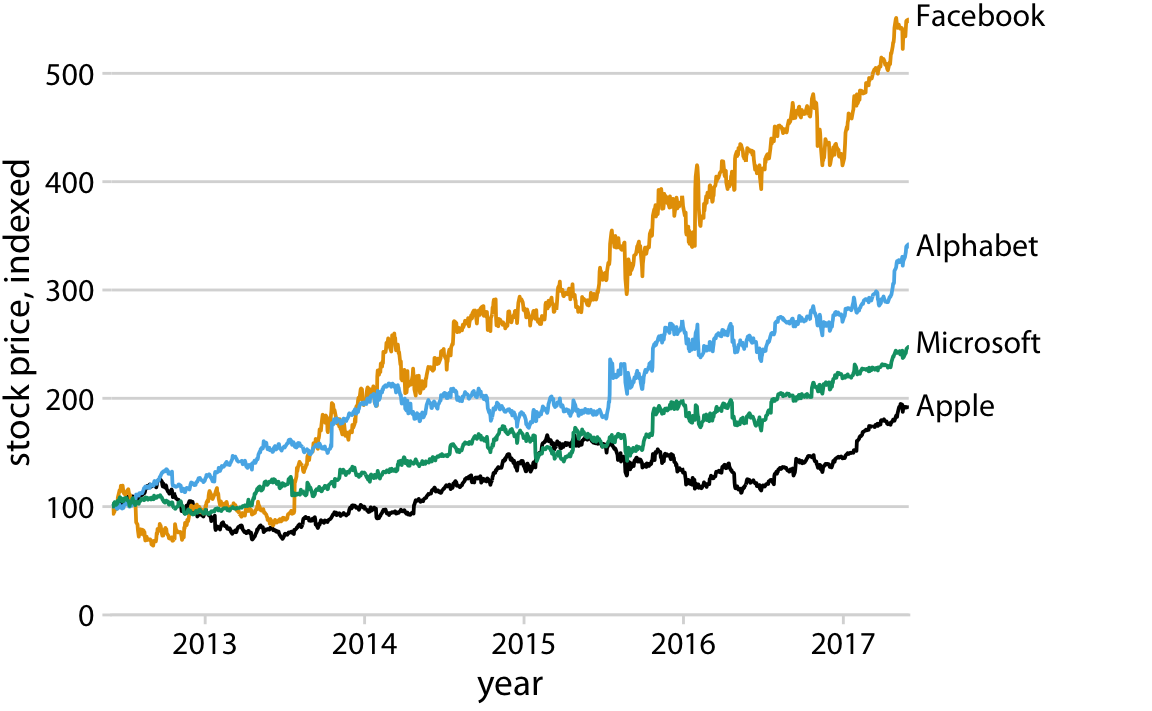
此外,Wilke (2019, p.251) 还建议去除图例,直接在折线旁标注文字 (图 30) ,可节省读者对照图例的工作量,让图表更易读。但这种做法通过 Seaborn 实现较困难,本课程中使用 图 28 中符合颜色顺序的图例即可。
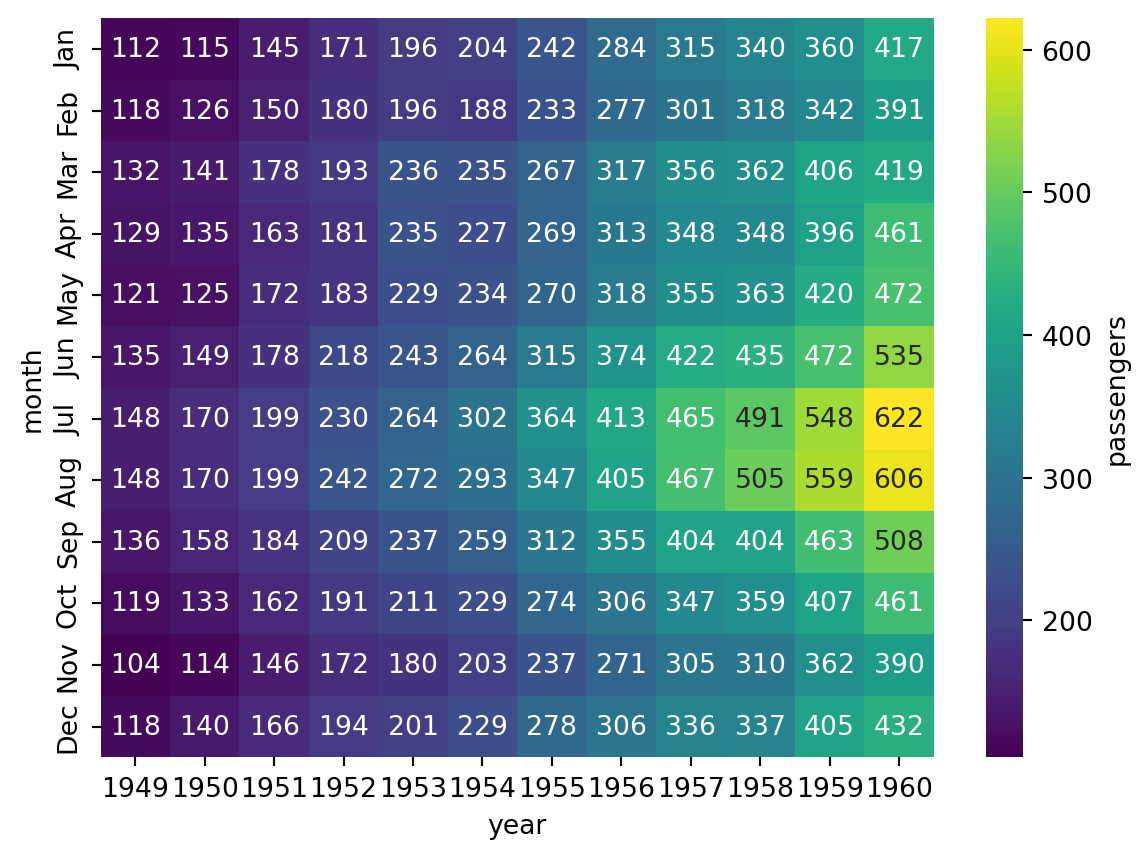
在绘制热力图之前,需要先为原数据创建 pivot table (数据透视表,又称枢轴表) 。数据透视表将原表格中的两个变量以矩阵形式展现:列名是一个变量,行名是另一个变量。
pivot 操作将原表某列中的所有数据种类转变为新的列名 (column label) 或行名/索引 (index) 。如 表 3 将 表 2 中 'year' 列的所有数据种类 (1949~1960) 变为新列名,将 'month' 列的数据种类变为新行名。
pivot 操作和 melt 操作相反:pivot 将”长表格”变为”宽表格”,melt 将”宽表格”变为”长表格” (melt 将原列名变为数据值,让表格行数增多) 。
| year | month | passengers | |
|---|---|---|---|
| 0 | 1949 | Jan | 112 |
| 1 | 1949 | Feb | 118 |
| 2 | 1949 | Mar | 132 |
| 3 | 1949 | Apr | 129 |
| 4 | 1949 | May | 121 |
| year | 1949 | 1950 | 1951 | 1952 | 1953 | 1954 | 1955 | 1956 | 1957 | 1958 | 1959 | 1960 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| month | ||||||||||||
| Jan | 112.0 | 115.0 | 145.0 | 171.0 | 196.0 | 204.0 | 242.0 | 284.0 | 315.0 | 340.0 | 360.0 | 417.0 |
| Feb | 118.0 | 126.0 | 150.0 | 180.0 | 196.0 | 188.0 | 233.0 | 277.0 | 301.0 | 318.0 | 342.0 | 391.0 |
| Mar | 132.0 | 141.0 | 178.0 | 193.0 | 236.0 | 235.0 | 267.0 | 317.0 | 356.0 | 362.0 | 406.0 | 419.0 |
| Apr | 129.0 | 135.0 | 163.0 | 181.0 | 235.0 | 227.0 | 269.0 | 313.0 | 348.0 | 348.0 | 396.0 | 461.0 |
| May | 121.0 | 125.0 | 172.0 | 183.0 | 229.0 | 234.0 | 270.0 | 318.0 | 355.0 | 363.0 | 420.0 | 472.0 |
| Jun | 135.0 | 149.0 | 178.0 | 218.0 | 243.0 | 264.0 | 315.0 | 374.0 | 422.0 | 435.0 | 472.0 | 535.0 |
| Jul | 148.0 | 170.0 | 199.0 | 230.0 | 264.0 | 302.0 | 364.0 | 413.0 | 465.0 | 491.0 | 548.0 | 622.0 |
| Aug | 148.0 | 170.0 | 199.0 | 242.0 | 272.0 | 293.0 | 347.0 | 405.0 | 467.0 | 505.0 | 559.0 | 606.0 |
| Sep | 136.0 | 158.0 | 184.0 | 209.0 | 237.0 | 259.0 | 312.0 | 355.0 | 404.0 | 404.0 | 463.0 | 508.0 |
| Oct | 119.0 | 133.0 | 162.0 | 191.0 | 211.0 | 229.0 | 274.0 | 306.0 | 347.0 | 359.0 | 407.0 | 461.0 |
| Nov | 104.0 | 114.0 | 146.0 | 172.0 | 180.0 | 203.0 | 237.0 | 271.0 | 305.0 | 310.0 | 362.0 | 390.0 |
| Dec | 118.0 | 140.0 | 166.0 | 194.0 | 201.0 | 229.0 | 278.0 | 306.0 | 336.0 | 337.0 | 405.0 | 432.0 |
关于 aggfunc 参数。 pd.pivot_table() 的 aggfunc (aggregation function) 默认为 'mean',即当一个单元格对应多行原数据时,默认取平均值。
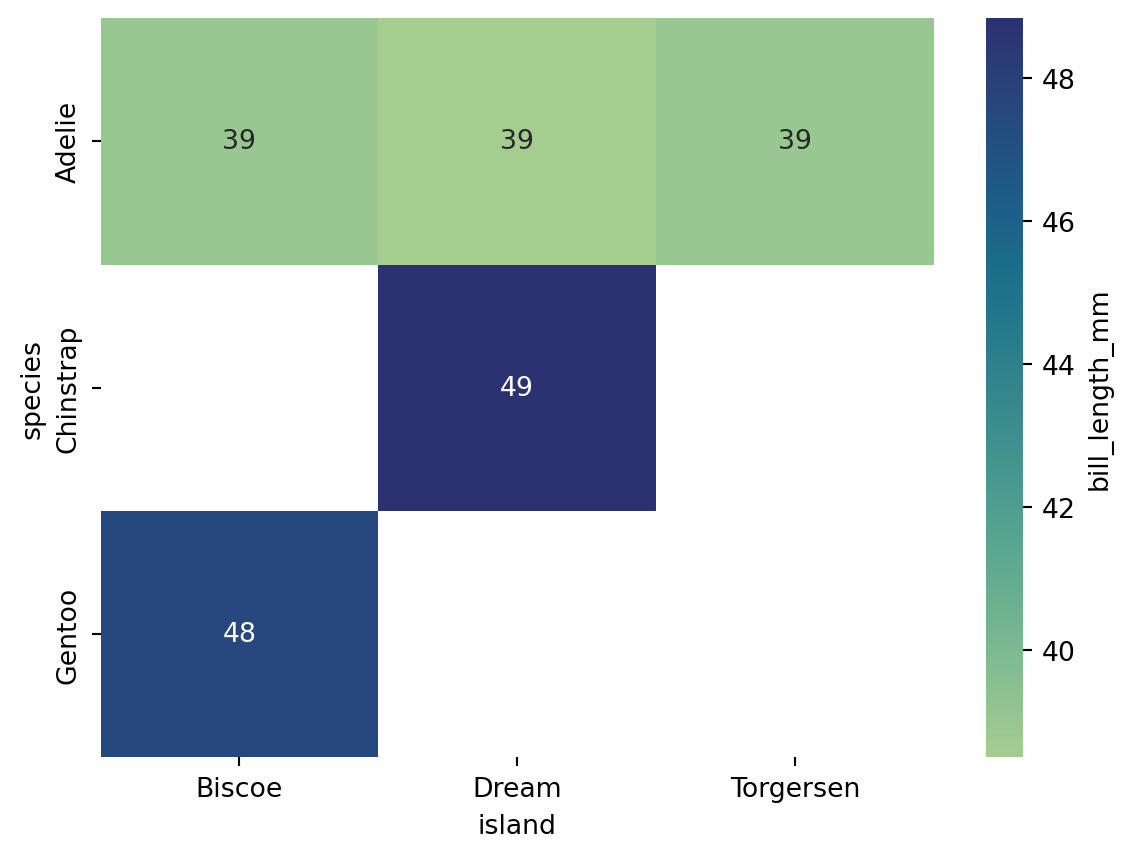
表 2 中特定 year 和 month 下 passenger 只有一个值,不需要求平均值。而如 表 4 所示的企鹅数据表,同一种类、同一岛屿的企鹅不止一只,在数据透视表 (表 5) 中只对应一个单元格,因此默认求平均值。
| species | island | bill_length_mm | bill_depth_mm | flipper_length_mm | body_mass_g | sex | |
|---|---|---|---|---|---|---|---|
| 0 | Adelie | Torgersen | 39.1 | 18.7 | 181.0 | 3750.0 | Male |
| 1 | Adelie | Torgersen | 39.5 | 17.4 | 186.0 | 3800.0 | Female |
| 2 | Adelie | Torgersen | 40.3 | 18.0 | 195.0 | 3250.0 | Female |
| 3 | Adelie | Torgersen | NaN | NaN | NaN | NaN | NaN |
| 4 | Adelie | Torgersen | 36.7 | 19.3 | 193.0 | 3450.0 | Female |
.heatmap 直接使用矩阵形式的表格画图,而非通过 x/y 参数指定特定列。cbar_kws (colorbar keyword arguments) 用于设置色彩条的标签。
还可以通过设置 cmap 和 annot 等参数进一步修改热力图 (图 32) :
cmap 可以使用 Seaborn 或 Matplotlib 中预制的 color palette 或 colormap 名称,如 'crest'、'flare'、'viridis'、'pink' 等。
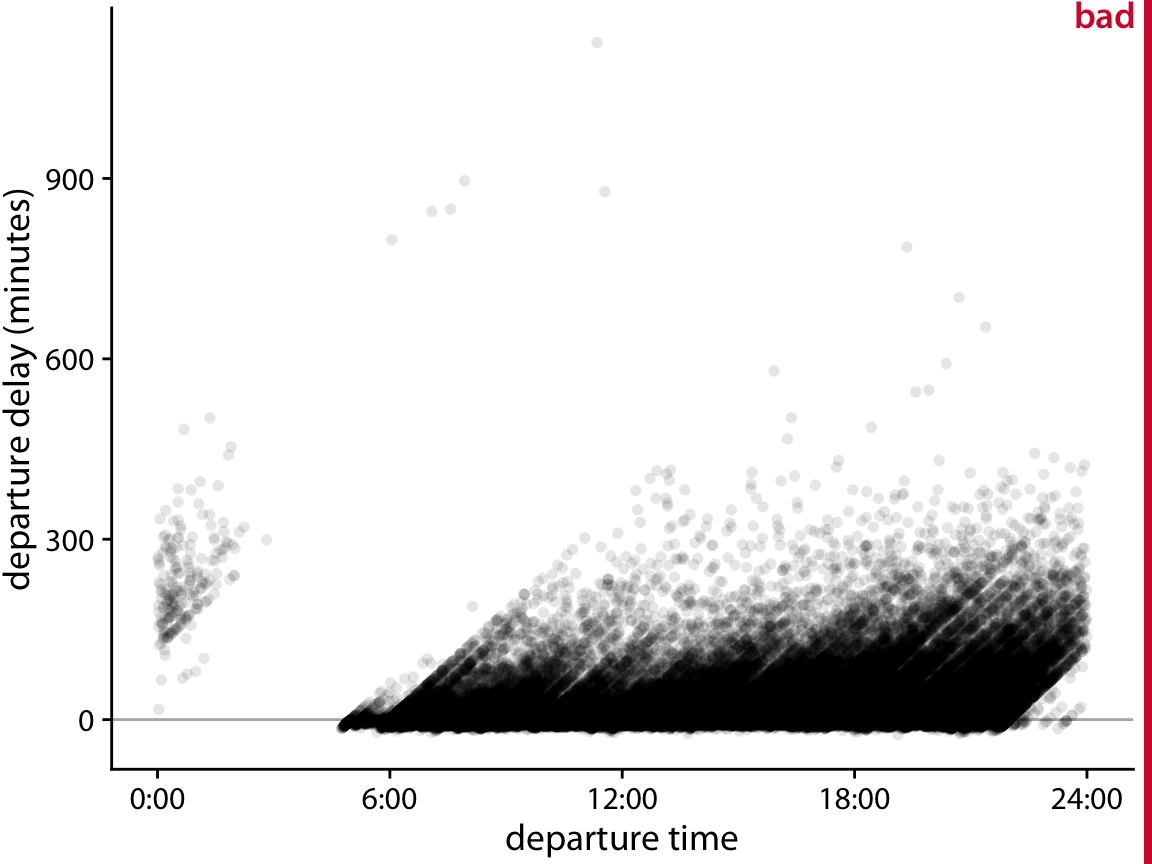
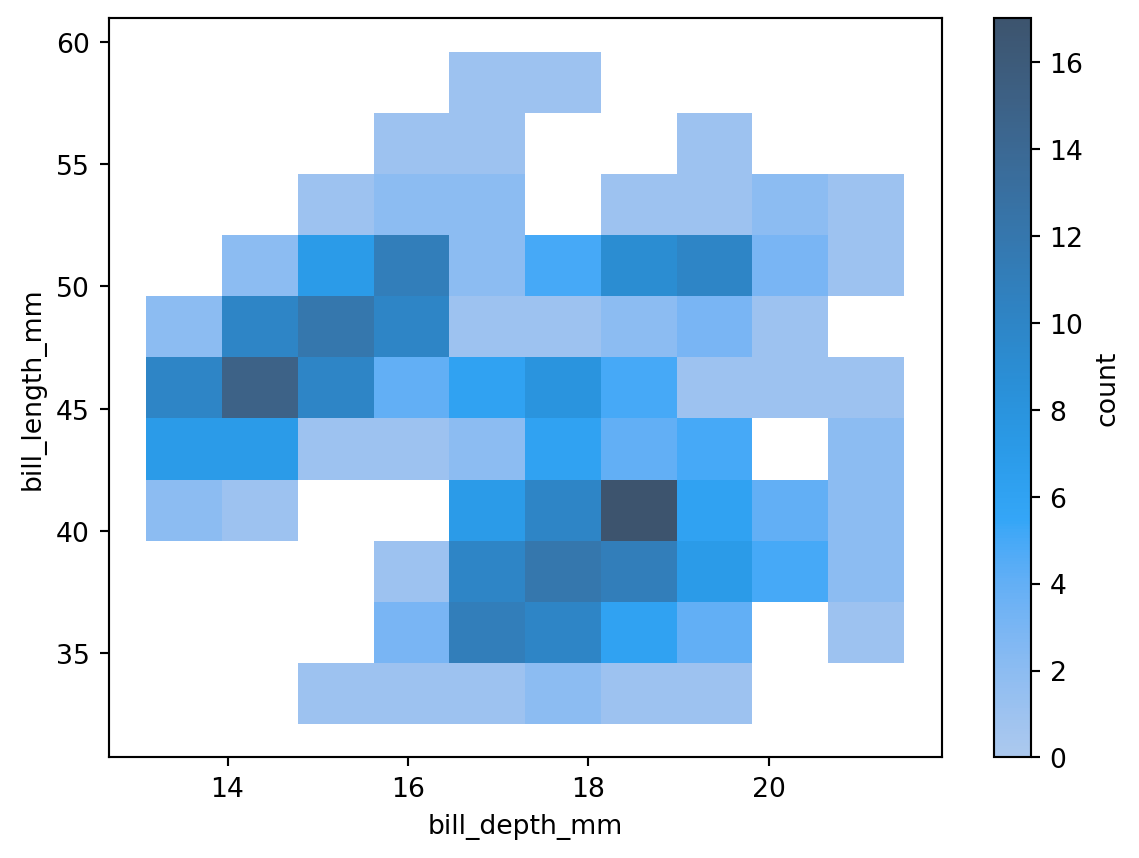
根据 Wilke (2019, pp. 222-225),含半透明点的散点图可展示数据在两个变量控制下的分布,但当数据点过多、过密时,散点图难以展示整体分布 (见 图 34: 点密度高的区域显示为均匀深色斑点,密度低的区域几乎不可见) 。
此时可改用 二维直方图 (2D histogram) :将 x-y 平面细分为小矩形 (分箱,bin) ,计算落入每个分箱的数据量,并按数据量对矩形着色 (见 图 35) :
表 6 展示了热力图和二维直方图的区别:
| 特性 | 热力图 (Heatmap) | 二维直方图 (2D Histogram) |
|---|---|---|
| 输入数据 | 预处理的矩阵 (通常来自 Pivot Table) | 原始数据 |
| 横纵轴 | 通常表示两个离散变量 | 通常表示两个连续变量 |
| 变量个数 | 三个:横纵轴和颜色 | 两个:横纵轴 |
| 颜色含义 | 单元格中的数值大小 | 分箱 (bin) 中的数据点数量 |
| 排布方式 | 行列数固定,颜色对应值固定 | 根据分箱数量可改变形状 |
| 主要用途 | 展示矩阵中的数值模式 | 展示两个变量的联合分布密度 |
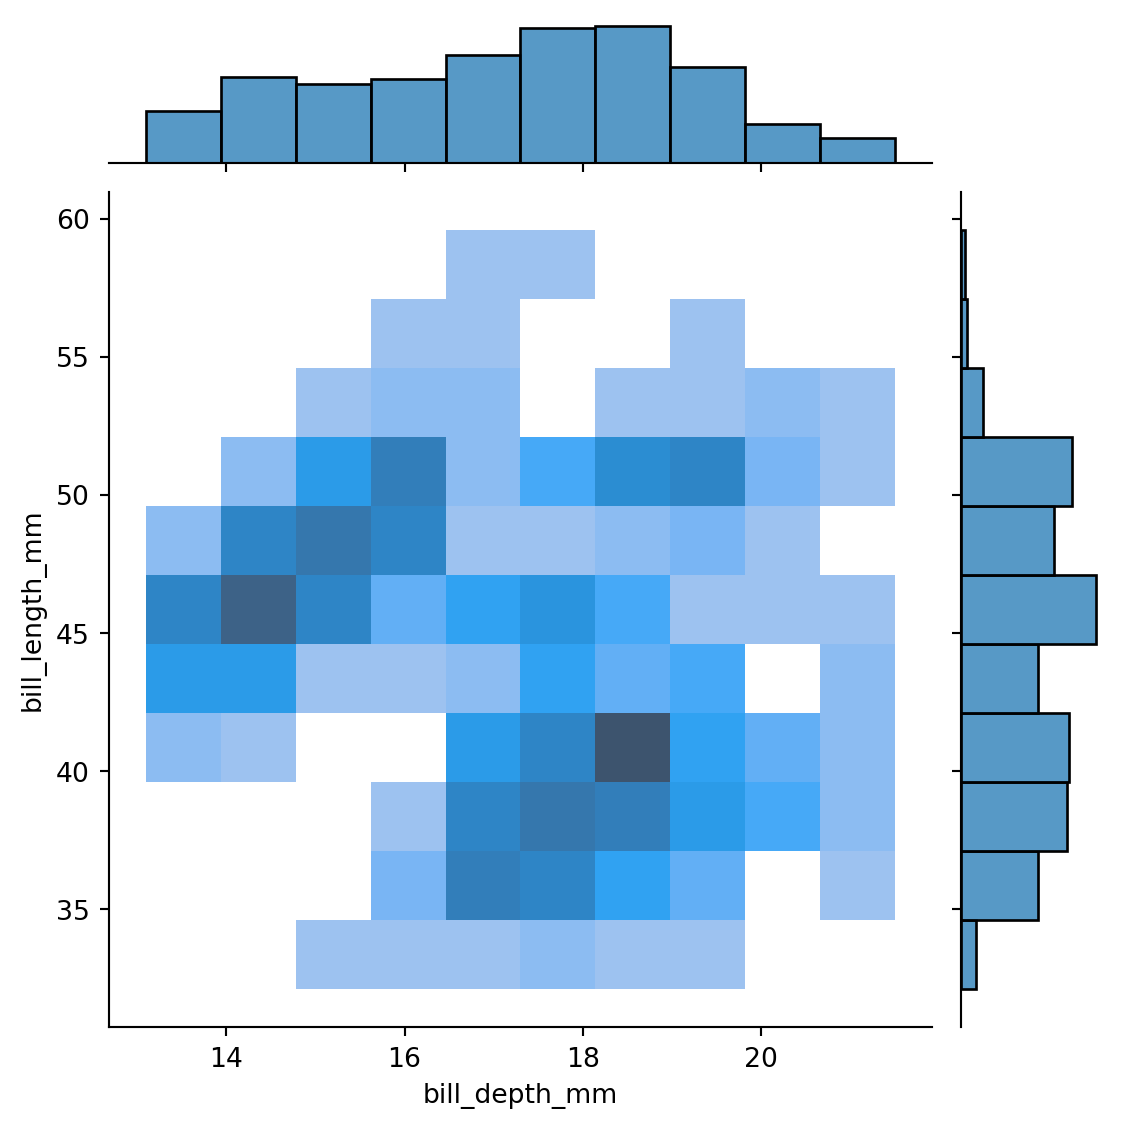
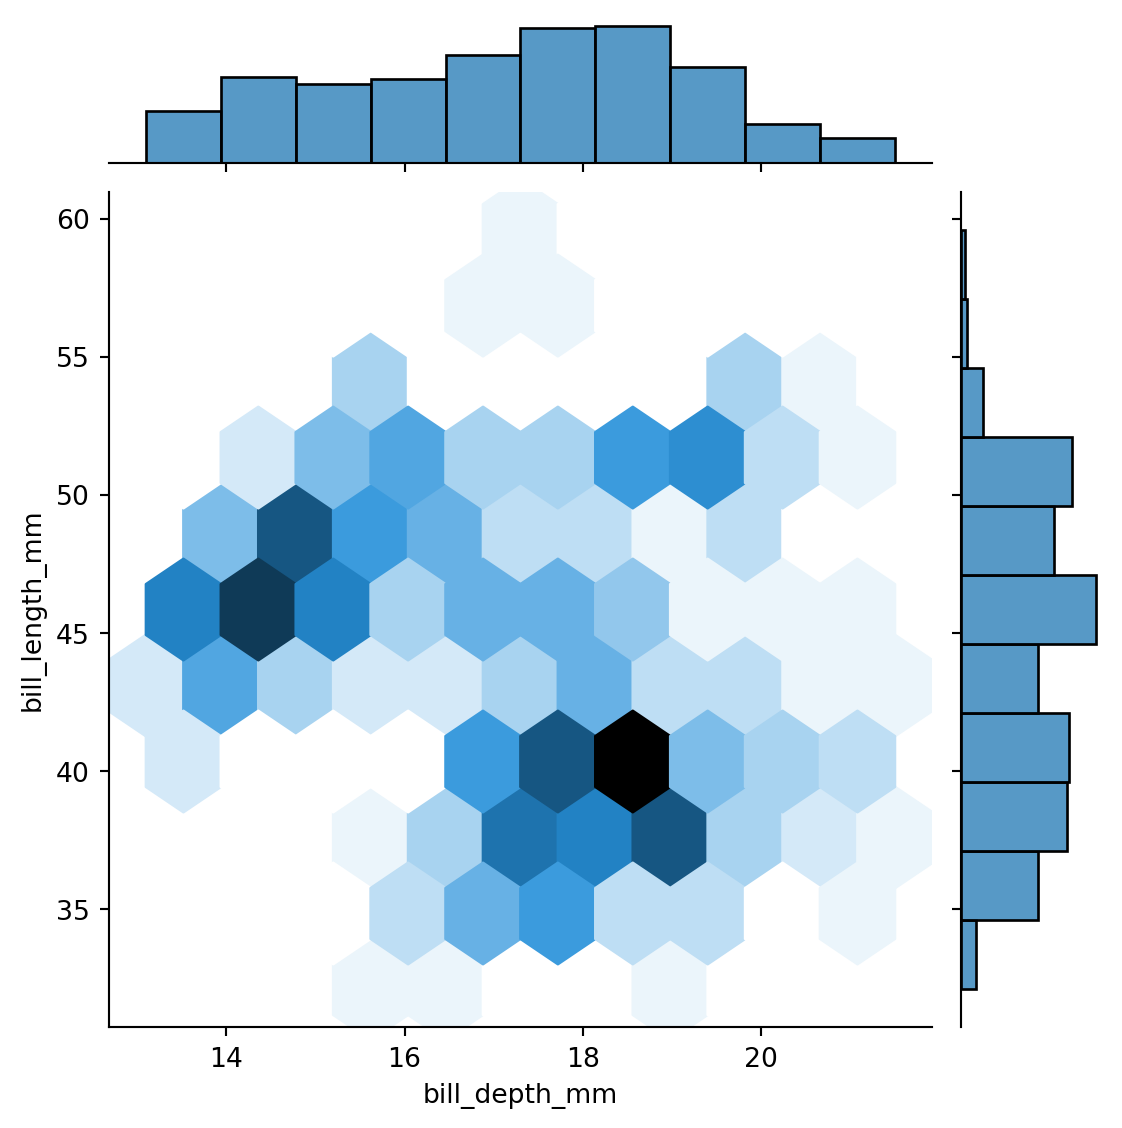
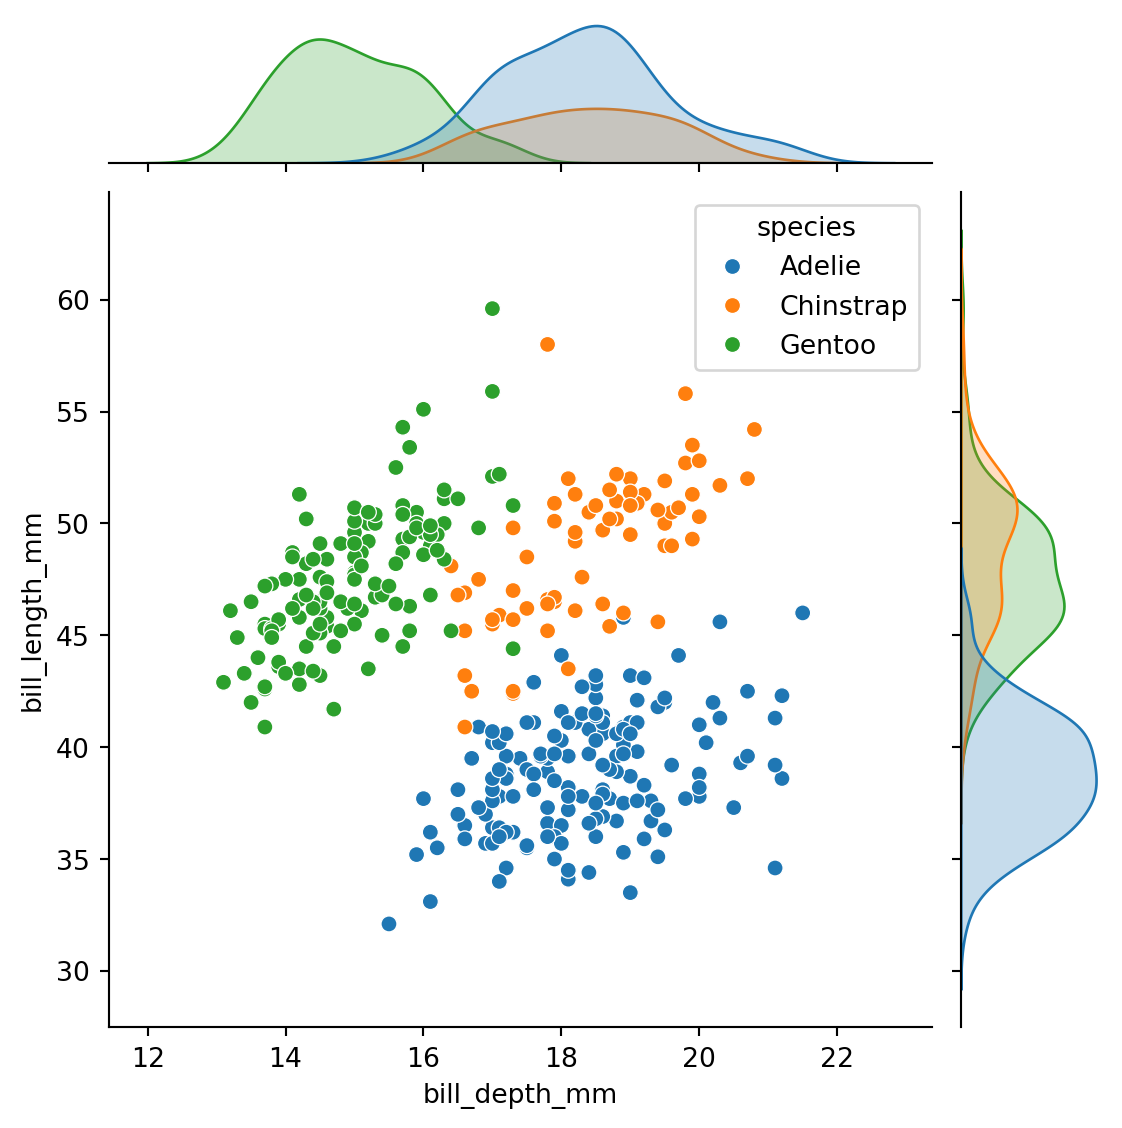
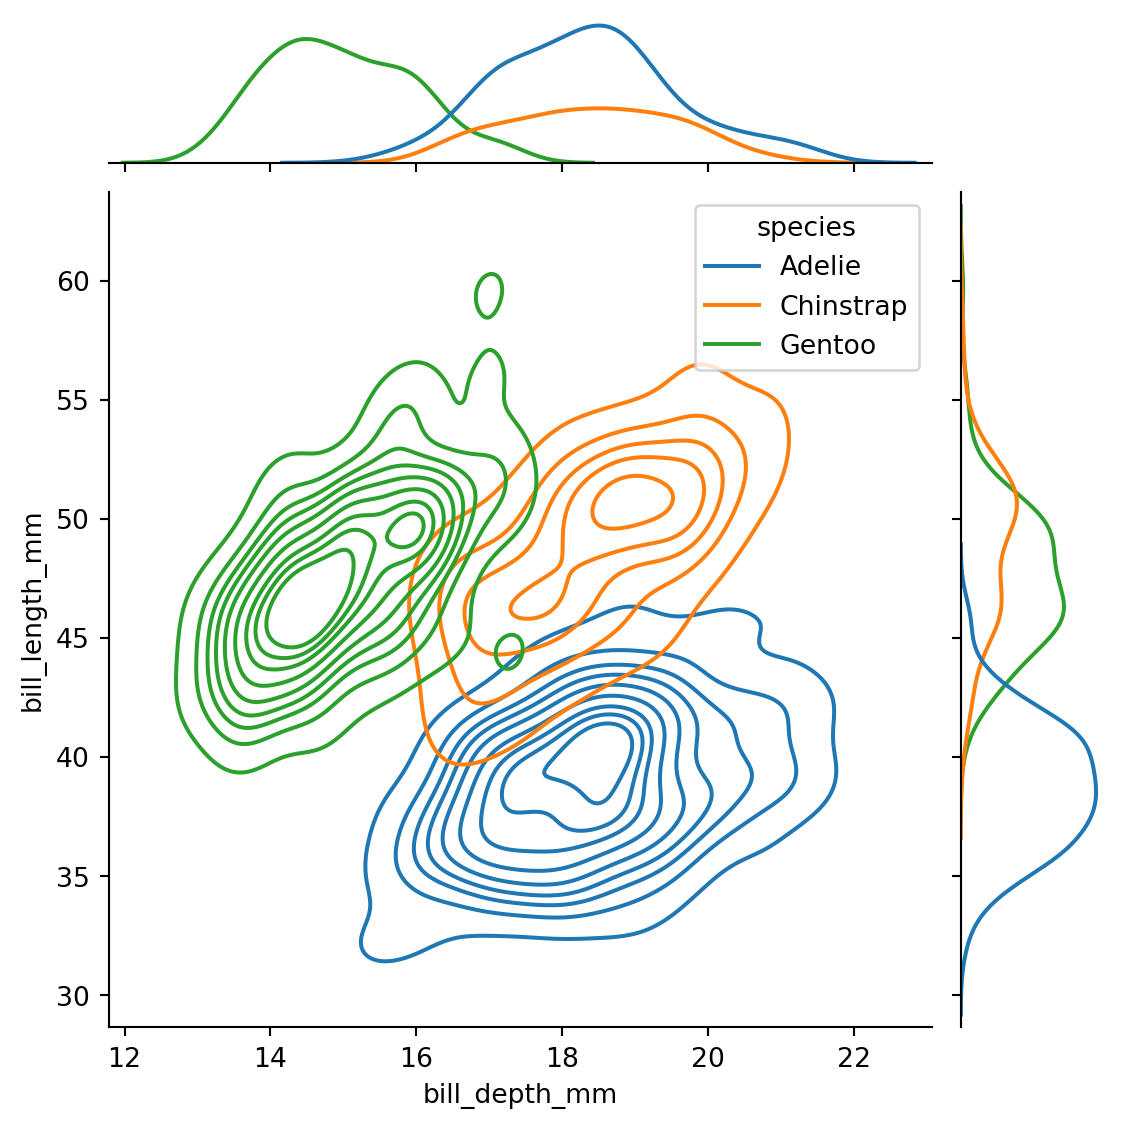
利用 sns.jointplot() 可以同时展示两个变量的二元分布图和各自的一元分布图。
如 图 36,可以在展示二维直方图 (同 图 35) 的同时,展示两个变量各自的一维直方图:
还可以通过 kind='hex' 让中间的格子呈六边形 (图 37) :
还可以用颜色区分变量 (图 38) :
还可以通过 kind='kde' (kernel density estimation) 生成光滑化的分布曲线 (见 图 39) 。 但光滑化后的曲线并非真实数据,尤其在数据点很少时可能误导读者,因此本课程中不建议使用。
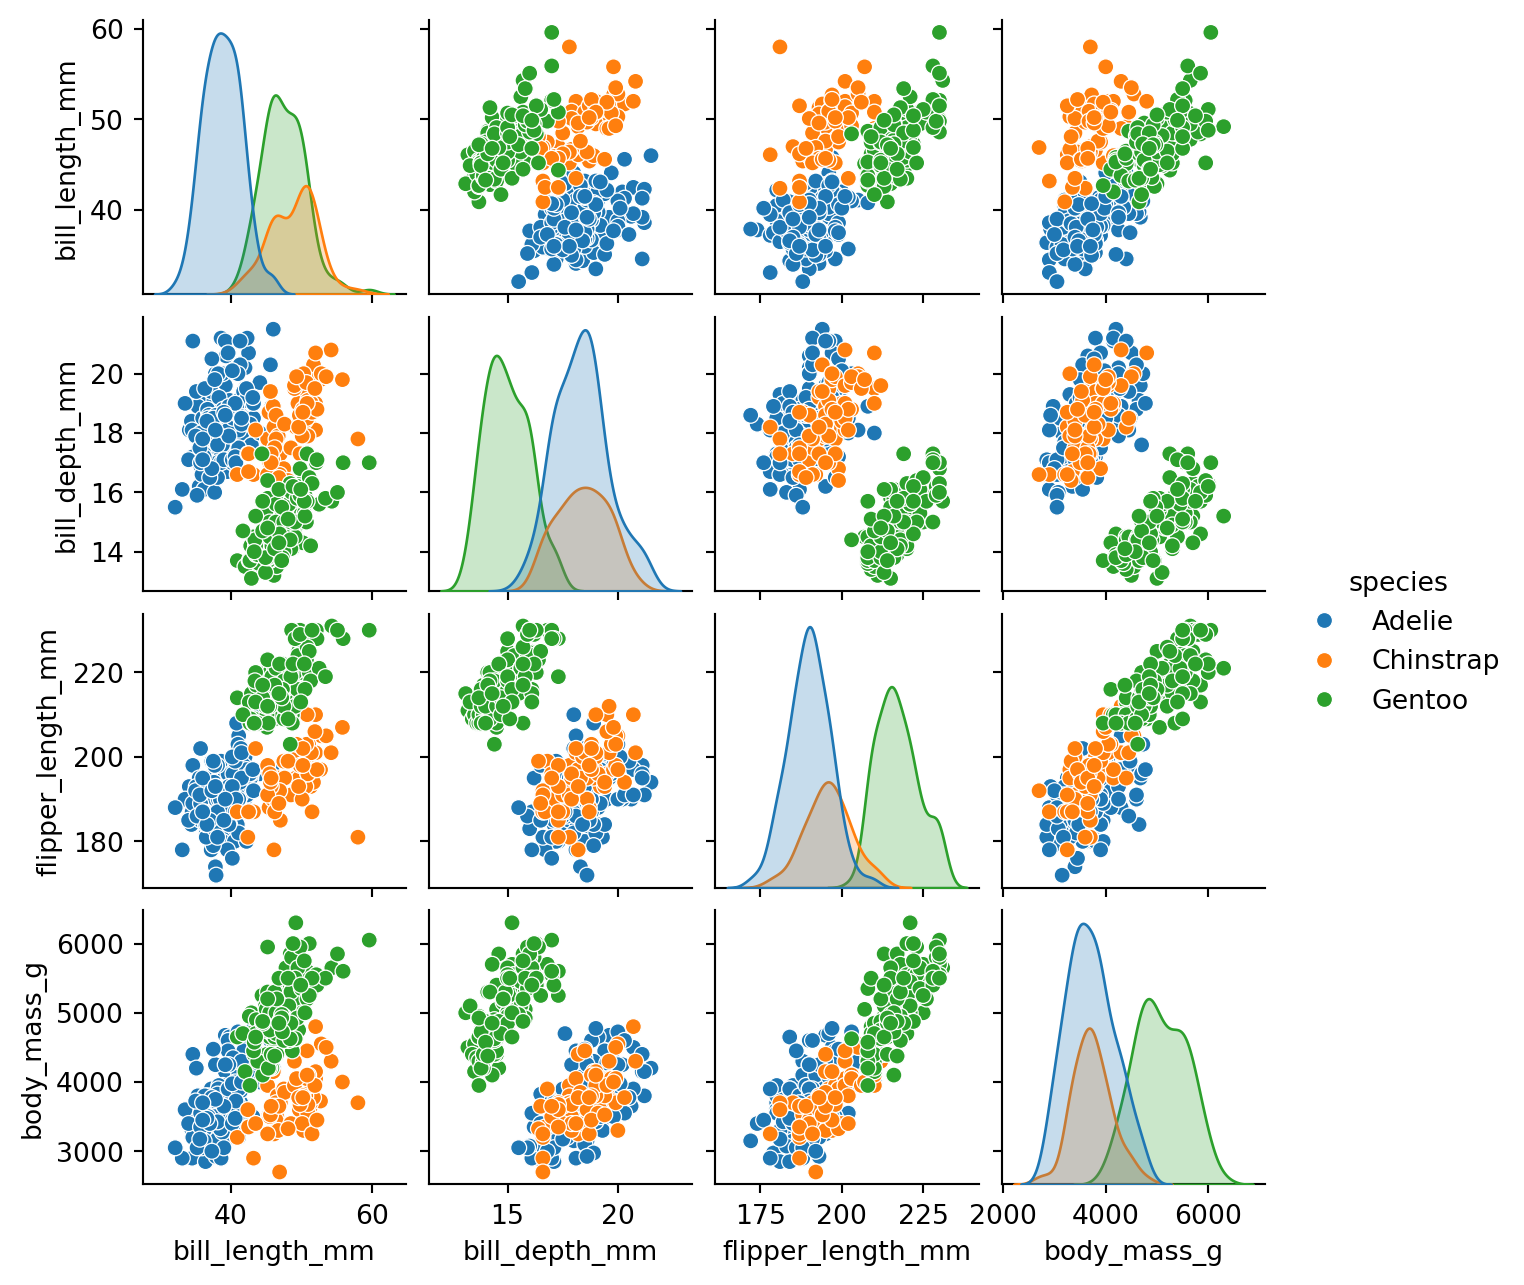
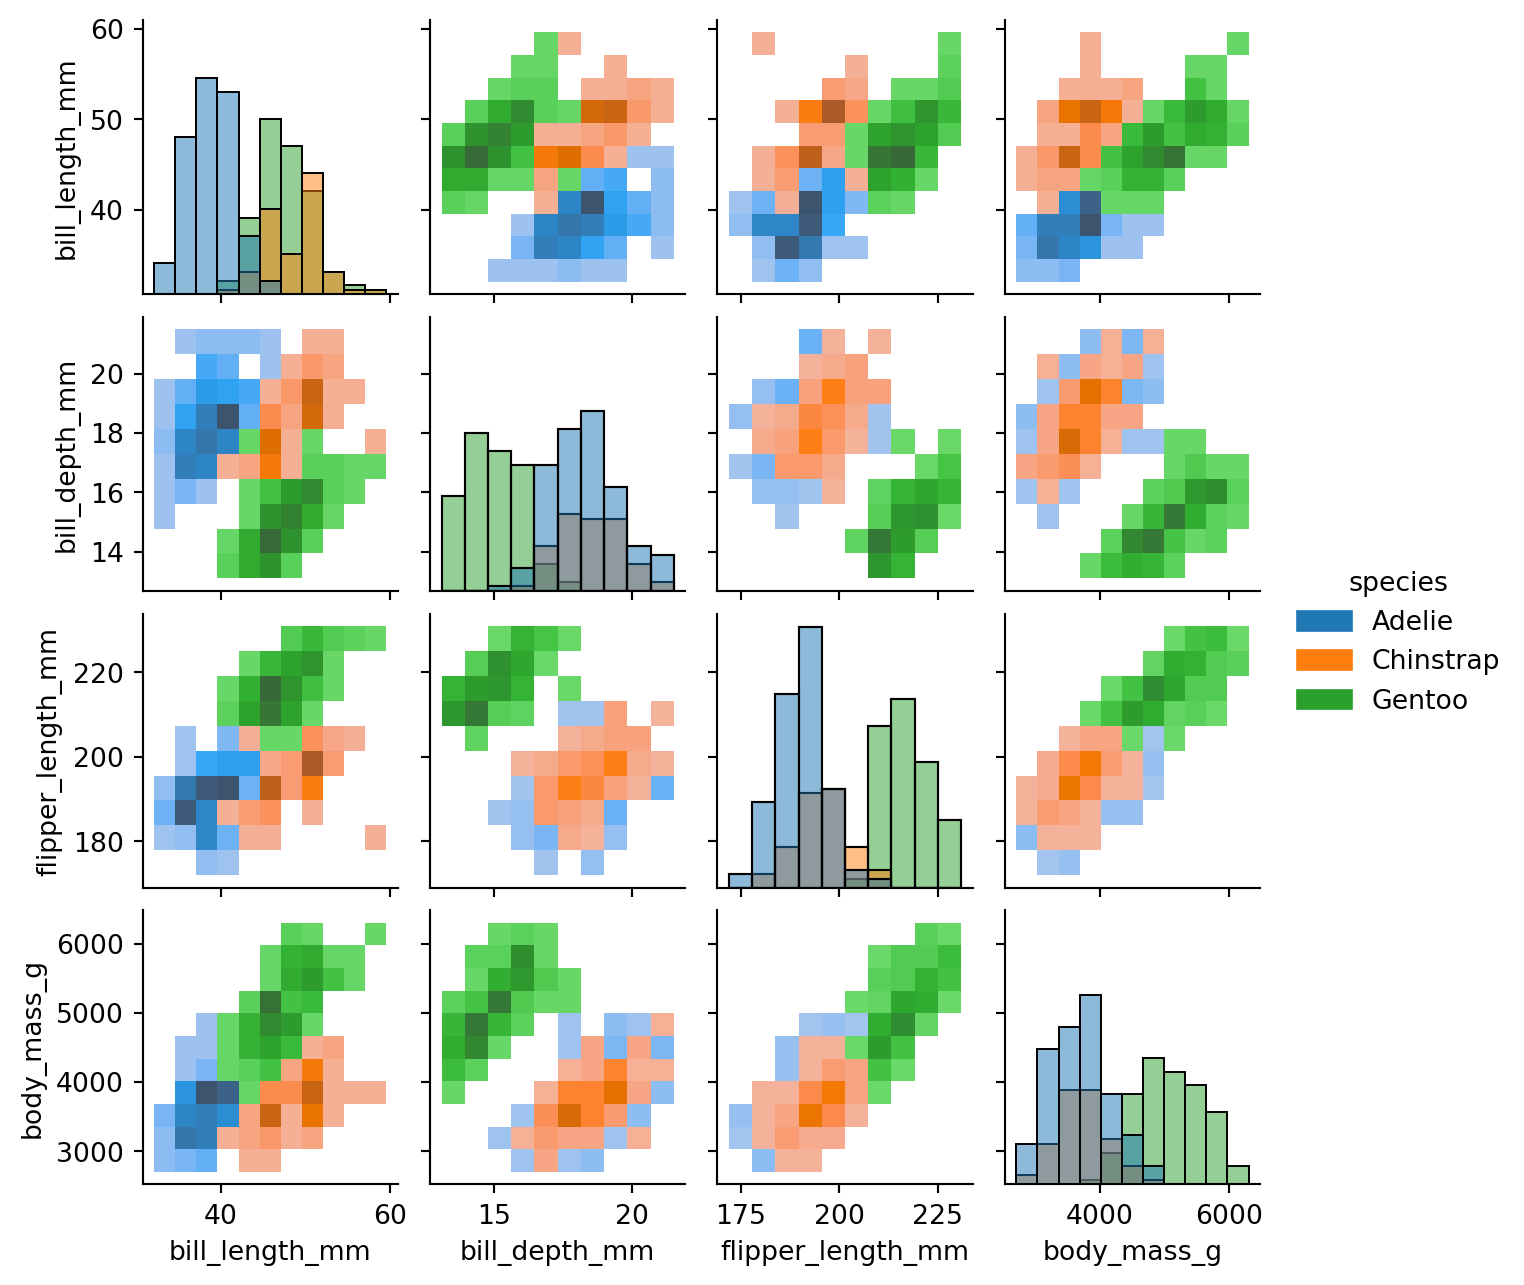
使用 sns.pairplot() 可以轻松画出原数据表中多个变量 (即多列) 各自两两配对的分布图,形成图表阵 (图 40) :
图 40 中,原 DataFrame 中的四个 ratio 变量被自动识别并画图:对角线的图是各变量各自的一元分布图,其余每个子图是基于一对变量绘制的二元分布图。
还可以通过设置 diag_kind 和 kind 来修改对角线图表和其他二元图表的格式 (图 41) :
---
title: '多变量图表'
author: 'Pinn Xu'
date: '2024-10-27'
categories: ["Python", "Seaborn", "可视化", "多变量", "热图"]
description: '使用 Seaborn 绘制多变量可视化图表:散点图、折线图、热力图、双变量图、分面网格图等。'
code-fold: false
number-sections: true
image: ../../../src/img/ttl/multi/cover.png
order: 3
aliases:
- ../multivariate-plots/
---
```{python}
#| eval: false
#| code-fold: true
#| code-summary: "环境与版本"
python==3.12
pandas==2.2.2
matplotlib==3.9.x
seaborn==0.13.2
```
# 多变量数据
**"tidy/flat" 的表格数据:** 每行为一个 **observation** (或 instance、record) ,每列为一个 **variable** (变量,也称 attribute、feature、parameter) 。
通常,**multivariate** (多变量) 用于描述变量超过两个的数据,即,multivariate plot 通常使用了原 DataFrame 中三个或三个以上的列作为数据。
绘制柱状图时,除了 x、y 两个变量之外,还可以设置 `hue` 参数,从而绘制包含三个变量的柱状图。比如 @fig-bar-variables 中包含了 `'island'`、`'body_mass_g'`、`'sex'` 三个变量。
```{python}
# 导入库
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
```
```{python}
# 从 Seaborn 加载示例数据集
df = sns.load_dataset('penguins')
```
```{python}
#| label: fig-bar-variables
#| fig-cap: "包含三个变量的柱状图"
sns.barplot(df, x='island', y='body_mass_g', hue='sex')
plt.show()
```
然而,有的图表类型不支持同时设置 `x`、`y` 和 `hue` 三个参数。比如直方图只支持 `x` 和 `hue` (见 @fig-histogram-variables) x 轴展示鳍长的分布区间,y 轴展示每个区间内的企鹅数量,只涉及两个变量。
```{python}
#| label: fig-histogram-variables
#| fig-cap: "包含两个变量的直方图"
sns.histplot(data=df, x='flipper_length_mm', hue='island')
plt.show()
```
# 分面网格
分面网格 (facetgrid) 是展示多元变量的常用方法。若干个小图表 (分面,facet) 以网格状排列,组成分面网格 (facetgrid) 。如果既想展示直方图,又想展示两个以上变量,可以使用分面网格。
通过 Seaborn 绘制分面网格的方法如下:
```{python}
#| label: fig-empty-facetgrid
#| fig-cap: "空的 3×2 分面网格"
# 创建空的分面网格
g = sns.FacetGrid(
data=df,
col='sex', # 'sex' 有多少种,就生成多少列
row='island', # 'island' 有三个值,生成三行
)
plt.show()
```
如 @fig-empty-facetgrid,我们创建了一个 3×2 的分面网格,但此时只有网格,还需要通过 `.map_dataframe()` 方法来指定填充内容。
```{python}
#| label: fig-filled-facetgrid
#| fig-cap: "填充后的分面网格"
# 填充完整分面网格
# 第一步:创建分面网格
g = sns.FacetGrid(
data=df,
col='sex',
row='island',
hue='species',
)
# 第二步:填充直方图
g.map_dataframe(
sns.histplot,
x='flipper_length_mm',
stat='density', # 各组 bar 面积之和为 1
common_norm=False, # 每个分面内各颜色分别归一化
)
# 第三步:添加并调整图例
g.add_legend()
sns.move_legend(
g,
loc='lower center',
bbox_to_anchor=(0.5, 1),
ncol=3, # 图例列数
)
plt.show()
```
**stat 与 common_norm**
`stat='density'` 用频率密度统计绘图,使直方图内所有 bar 的面积之和为 1。`common_norm=False` 配合 `stat` 使用,表示在同一分面中,每种颜色的 bar 面积之和分别为 1,而非所有颜色的 bar 面积总和为 1。
**loc 与 bbox_to_anchor**
同时设置两个参数,让图例的下边缘中点 (lower center) 位于整个网格图的 (0.5, 1) 位置。如果只设置 `loc='lower center'`,图例将直接定位于整个网格图的中下部。
如 @fig-filled-facetgrid ,分面网格按岛屿分行、按性别分列、按种类分色,同时展示了四个变量 (鳍长、岛屿、性别、种类) 。通过分行和分列可以额外增加两个离散型变量;通过颜色区分还可再增加一个离散型变量。
> 注:由于分行和分列的特性,分面网格只能用于额外增加离散型变量。若要对连续型变量分面,可先将其划分区间,保存为新的离散型变量列,再用分面网格进行分行或分列。
**刻度范围一致性**
同时展示多个子图时,每个子图的刻度范围应当相同,因为读者往往默认多图的刻度范围一致,不一致会造成误判 [ (Wilke, 2019, pp. 257-258) ](https://clauswilke.com/dataviz/multi-panel-figures.html#small-multiples)。
@fig-ba-degrees-variable-y-lims 中各子图纵坐标刻度范围各不相同,容易让人误判。将其改为 @fig-ba-degrees-fixed-y-lims 这样所有刻度范围都相同,可减少阅读困难。
[{#fig-ba-degrees-variable-y-lims fig-alt="差的多图刻度范围 (Wilke, 2019, p. 258)"}](https://clauswilke.com/dataviz/multi-panel-figures.html#fig:BA-degrees-variable-y-lims)
[{#fig-ba-degrees-fixed-y-lims fig-alt="改良版多图刻度范围 (Wilke, 2019, p. 259)"}](https://clauswilke.com/dataviz/multi-panel-figures.html#fig:BA-degrees-fixed-y-lims)
# 散点图
## 区分散点图和点图
在画散点图之前,需要注意区分 **散点图 (scatter plot)** 和 **点图(point plot)**。
> 注:点图又称 dot plot [(Wilke, 2019, p.43)](https://clauswilke.com/dataviz/directory-of-visualizations.html#directory-uncertainty)。以下对散点图与点图的区别的理解均基于 Seaborn 库,在其他语境下可能有所不同。
**点图 (point plot) ** 可以起到类似柱状图的作用:点图中每个点所在的竖线相当于柱状图的 bar,点相当于柱状图中每个 bar 的顶边缘中点。像柱状图一样,点图可以用于展示 category-amount 型图表 (见 @fig-pointplot-category-amount 和 @fig-barplot-category-amount) :
```{python}
#| label: fig-pointplot-category-amount
#| fig-cap: "点图: 企鹅种类-喙长 (黑线为误差线)"
sns.pointplot(
data=df, x='species', y='bill_length_mm',
linestyles='none', # 点与点之间不连线
)
plt.show()
```
```{python}
#| label: fig-barplot-category-amount
#| fig-cap: "柱状图: 企鹅种类-喙长 (黑线为误差线)"
sns.barplot(data=df, x='species', y='bill_length_mm')
plt.show()
```
如 @fig-pointplot-category-amount 和 @fig-barplot-category-amount 所示,点图和柱状图都可以表示 类型-数量 (category-amount) 关系。二者区别之一是:柱状图的 数量 (amount) 必须从 0 开始,而点图不需要。点图和柱状图都只展示纵坐标的平均值 (也可设置为其他统计值,如中位数) ,每个横坐标值只能对应一个纵坐标值。
**散点图 (scatter plot) ** 会显示每一个数据点 (见 @fig-scatterplot-category-amount) :
```{python}
#| label: fig-scatterplot-category-amount
#| fig-cap: "散点图: 类型-数量 (显示所有数据点,而非平均值)"
sns.scatterplot(data=df, x='species', y='bill_length_mm')
plt.show()
```
散点图中每个横坐标可以对应多个纵坐标,而点图中每个横坐标只对应一个纵坐标。
散点图常用于探究两个 (或多个) 变量之间的关系 (relationship) ,查看变量间是否存在关联性 (correlation) ,主要用于探究两种连续数值型数据之间的关系。因此散点图横轴通常为 ratio data,刻度自动显示为连续数值区间 (见 @fig-scatterplot-ratio-ratio) :
```{python}
#| label: fig-scatterplot-ratio-ratio
#| fig-cap: "散点图: 企鹅喙长-喙深 (ratio-ratio)"
sns.scatterplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
alpha=0.7, # 半透明,便于观察点的堆积
)
plt.show()
```
> 注:设置半透明有助于观察点的堆积,但若已使用渐变颜色区分某变量 (如 @fig-scatter-continuous-variables) ,则不宜再使用半透明。
**点图 (point plot) ** 使用 ratio data 作横轴时,每个点会对应一个特定刻度,效果如 @fig-pointplot-ratio-ratio 所示:
```{python}
#| label: fig-pointplot-ratio-ratio
#| fig-cap: "点图: 使用 ratio 变量作横轴"
sns.pointplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
linestyle='none', errorbar=None, alpha=0.7,
)
plt.show()
```
> 注:虽然 @fig-scatterplot-ratio-ratio 和 @fig-pointplot-ratio-ratio 点的分布看似相似,但点图中每个横坐标有且仅有一个对应的点,散点图可以对应多个。此外,`sns.pointplot()` 不支持调整点的大小,`sns.scatterplot()` 支持。
因此,**点图不适用于横坐标为连续型数据且刻度过多**的情况,更**适用于横坐标为离散型数据**且刻度不宜过多的场景。**散点图** 则相反,更适用于 ratio-ratio 数据。
点图的另一个特点是点与点之间可以连线,适用于横轴为 ordinal 或 interval data 的情况。比如 @fig-pointplot-interval-ratio 中年份为 interval data,连线可以表示乘客量随年份的变化趋势;而 @fig-pointplot-category-amount 中横坐标为企鹅种类 (nominal data) ,顺序没有意义,因此不画连线。
这种点图变得和折线图非常类似,我们将在 [折线图 Line Plot](#sec-line-plot) 中继续讨论。
```{python}
#| label: fig-pointplot-interval-ratio
#| fig-cap: "点图: 年份-乘客数 (interval-ratio)"
flights = sns.load_dataset('flights')
sns.pointplot(data=flights, x='year', y='passengers')
plt.show()
```
## 多变量散点图
除了 x、y 轴展示的两种连续变量之外,还可以通过设置 `hue` (点颜色) 、`size` (点大小) 、`style` (点形状) 等参数来引入其他变量。`hue` 和 `size` 可以应用于连续型或离散型变量;`style` 只能应用于离散型变量,因为点形状无法连续渐变 (仅限 Seaborn 库) 。
比如 @fig-scatter-discrete-variables 同时引入了三个离散变量:
```{python}
#| label: fig-scatter-discrete-variables
#| fig-cap: "增加三个离散变量: hue & size & style"
ax = sns.scatterplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
hue='sex',
size='island',
style='species',
)
sns.move_legend(ax, loc='upper left', bbox_to_anchor=(1, 1))
plt.show()
```
@fig-scatter-discrete-variables 中,除横纵轴的两个连续变量 (喙长、喙深) 外,还设置了三个离散变量 (性别、岛屿、种类) 。再比如 @fig-scatter-continuous-variables 引入了两个连续变量:
```{python}
#| label: fig-scatter-continuous-variables
#| fig-cap: "增加两个连续变量: hue & size (已有渐变色,不宜使用半透明)"
ax = sns.scatterplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
hue='flipper_length_mm',
size='body_mass_g',
)
sns.move_legend(ax, loc='upper left', bbox_to_anchor=(1, 1))
plt.show()
```
> 注:虽然 `hue` 和 `size` 可以应用于连续型变量,但其图例并非严格连续的。
**多变量散点图与分面网格的区别**见 @tbl-scatter-vs-facetgrid:
| 维度 | 多变量散点图 | 分面网格 |
|:---|:---:|:---:|
| 视图 | 全局,所有点在同一坐标系 | 分格展示,便于子图对比 |
| 图形空间 | 少,只需一张图 | 多,需创建多个子图 |
| 连续变量 | 可直接引入,自动生成图例 | 需手动划分区间保存为新变量 |
| 视觉复杂度 | 信息集中,可能过于拥挤 | 各子图独立,阅读负担较低 |
| 图例依赖 | 需反复对照图例 | 子图标题直接说明 |
: 多变量散点图与分面网格的比较 {#tbl-scatter-vs-facetgrid}
为了让散点图更易辨认,建议 **同时使用颜色和形状区分同一变量** [(Wilke, 2019, pp.243-247)](https://clauswilke.com/dataviz/redundant-coding.html#designing-legends-with-redundant-coding),如 @fig-scatter-hue-style-island:
```{python}
#| label: fig-scatter-hue-style-island
#| fig-cap: "hue+style 同时控制同一变量 (岛屿)"
ax = sns.scatterplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
hue='island',
style='island',
)
sns.move_legend(ax, loc='upper left', bbox_to_anchor=(1, 1))
plt.show()
```
此外,**尽量不要在同一图表内同时使用 `style` 和 `size` 控制两个不同变量**,因为形状改变后大小的区分会变得不够直观 (见 @fig-scatter-size-flipper) :
```{python}
#| label: fig-scatter-size-flipper
#| fig-cap: "hue+style 控制岛屿,size 另控制鳍长"
ax = sns.scatterplot(
data=df, x='bill_length_mm', y='bill_depth_mm',
hue='island',
style='island',
size='flipper_length_mm',
)
sns.move_legend(ax, loc='upper left', bbox_to_anchor=(1, 1))
plt.show()
```
**其他注意事项:**
- 使用颜色时应尽量兼顾色觉缺陷读者,选择**在色相和明度上均有明显差异**的颜色。
- 当折点过多时,不宜在折线图中展示点。
这些细节将在 @sec-line-plot 中进一步讨论。
## 对数尺度
**对数尺度 (logarithmic scale) **是一个非线性测量尺度,适用于有较大范围差异的数据,如里氏震级、声学音量、光学光强、溶液 pH 值等。为此类数据绘制散点图时,可将坐标轴设置为对数尺度 (默认为线性尺度,如 @fig-scatterplot-ratio-ratio 中 x 轴刻度 35, 40, 45, 50 是线性增长的数字) ,让原本拥挤的数据点变得较为均匀,更容易观察 ([维基百科 - 对数尺度](https://zh.wikipedia.org/wiki/%E5%B0%8D%E6%95%B8%E5%B0%BA%E5%BA%A6)) 。
[Wilke (2019, p.17)](https://clauswilke.com/dataviz/coordinate-systems-axes.html#nonlinear-axes) 以 $(1, 3.16, 10, 31.6, 100)$ 为例画了四个数轴 (@fig-linear-log-scales) ,其中 $10^{0.5} = \sqrt{10} \approx 3.16$,$10^{1.5} \approx 31.6$。
[{#fig-linear-log-scales fig-alt="四个数轴 (Wilke, 2019, p.17)" width="80%"}](https://clauswilke.com/dataviz/coordinate-systems-axes.html#fig:linear-log-scales)
如 @fig-linear-log-scales,四个数轴含义如下:
- **第一个数轴**使用线性尺度,刻度为 $(0, 25, 50, 75, 100)$,展示原数据 $x$,数据点分布不均匀。
- **第二个数轴**同样使用线性尺度,但对原数据取对数,展示 $\log_{10}(x)$,数据点均匀分布,轴标签为 $\log_{10}(x)$。
- **第三个数轴**使用原数据 $x$,但改用对数尺度,刻度为 $(1, 3.16, 10, 31.6, 100)$ (即 $(10^{0.0}, 10^{0.5}, 10^{1.0}, 10^{1.5}, 10^{2.0})$) ,数据点均匀分布。
- **第四个数轴**同第三个,但轴标签错误地写成了 $\log_{10}(x)$。
对比第一个和第三个数轴:对于同一组数据,线性尺度中分布不均匀的点,在对数尺度中变得均匀。这样调整有助于观察分布不均匀的数据,尤其是呈指数型增长趋势的数据。
需要注意的是,改用对数尺度只改变了轴刻度的展示方式,并没有改变数据点的值。因此,对于仅改用刻度尺度、不改动原数据的图,不可以将轴标题写作 $\log_{10}(x)$ (见第四个数轴) 。
**对数尺度适用的情况及其优缺点**:
**适用情况**
- 数据范围跨度极大(跨多个数量级),例如人口、收入、距离、质量等
- 更关注相对变化(倍数关系),而不是绝对差值
- 数据呈指数增长或指数衰减趋势(在对数尺度下更接近线性关系)
**优点**
- 压缩数据范围:同时展示极大值与极小值,避免大值“压扁”整体结构
- 改善可视化分布:减少数据在某一区间的堆积,使分布更均匀
- 强化倍数比较:相同的轴距离表示相同的“倍数变化”,更符合某些分析需求
- 有助识别指数关系:指数增长/衰减在对数尺度下更容易观察
**缺点**
- 不适用于零值与负值:对数函数定义域为正数
- 可读性较低:对不熟悉对数尺度的读者不够直观
- 可能掩盖绝对差异:压缩高值区间,弱化原始差距的视觉表达
例如,@fig-planets-linear-scale 中数据范围差异较大且左边过于集中——可以改用对数尺度 (@fig-planets-log-scale) 。
```{python}
#| label: fig-planets-linear-scale
#| fig-cap: "散点图: 行星距离-质量,线性尺度"
planets = sns.load_dataset('planets')
g = sns.scatterplot(data=planets, x='distance', y='mass')
plt.title('Relationship between planetary distance and mass')
plt.show()
```
```{python}
#| label: fig-planets-log-scale
#| fig-cap: "散点图: 行星距离-质量,对数尺度"
planets = sns.load_dataset('planets')
g = sns.scatterplot(data=planets, x='distance', y='mass')
g.set_xscale('log') # 默认底数为 10,可通过 base 参数修改
g.set_yscale('log')
plt.show()
```
> 注:@fig-planets-log-scale 中,刻度 $(10^0, 10^1, 10^2, ...)$ 是等距的对数尺度刻度。每两个大刻度间的小刻度代表等差的实际数值,如从 $10^0$ 到 $10^1$ 之间分别为 $2, 3, ..., 9$,从 $10^1$ 到 $10^2$ 之间分别为 $20, 30, ..., 90$,以此类推。
由于对数尺度无 0 值 (以 1 即底数的 0 次方为原点) ,**对数尺度适合用于展示比例数据**。如 [Wilke (2019, pp.18-20)](https://clauswilke.com/dataviz/coordinate-systems-axes.html#fig:texas-counties-pop-ratio-log) 将德克萨斯州各县人口除以人口中位数作为纵轴,用对数尺度 (@fig-texas-counties-pop-ratio-log) 展示了各县人口在中位数附近的分布 (比值为 1 时说明该县人口恰好为中位数) 。
[{#fig-texas-counties-pop-ratio-log fig-alt="德克萨斯州各县人口分布情况 - 对数尺度"}](https://clauswilke.com/dataviz/coordinate-systems-axes.html#fig:texas-counties-pop-ratio-log)
如果改用线性尺度展示 @fig-texas-counties-pop-ratio-log 中的数据,则以 0 为原点,无法清晰展示数据在 1 两侧的分布 (@fig-texas-counties-pop-ratio-lin) 。
[{#fig-texas-counties-pop-ratio-lin fig-alt="德克萨斯州各县人口分布情况 - 线性尺度"}](https://clauswilke.com/dataviz/coordinate-systems-axes.html#fig:texas-counties-pop-ratio-lin)
## 回归图
**回归图 (regression plot)** 将散点图拟合成一条线,用于展示两个变量之间的关系。最常见的是 **线性拟合 (linear fitting)** ,即将散点图拟合成线性回归线。置信区间用于显示回归线 (作为估计值) 的不确定性:置信水平 95% 时,真实值有 95% 的可能落在该区间内。如 @fig-regression-plot ,直线是线性回归线,阴影部分是置信区间。
```{python}
#| label: fig-regression-plot
#| fig-cap: "线性回归图"
sns.lmplot(data=df, x='bill_length_mm', y='bill_depth_mm', hue='sex')
plt.show()
```
`sns.lmplot()` (linear model plot) 默认使用 95% 置信区间来衡量回归线的不确定性。
> 注:`hue` 参数仅适用于离散型数据。
# 折线图 {#sec-line-plot}
**散点图 (scatter plot)** 中数据点独立存在,通常用于探索 **两个变量** 之间的相关性或分布,数据点之间无先后关系。**折线图 (line plot)** 中数据点通过线段连接,强调数据的连续性或变化趋势,通常用于时间序列数据,展示 **一个变量** 随时间的变化,数据点之间存在先后关系。
如 @fig-lineplot-hue ,展示了某航空公司每月乘客量随年份增长的变化:
```{python}
#| label: fig-lineplot-hue
#| fig-cap: "按月份颜色区分的折线图"
sns.lineplot(
data=flights, x='year', y='passengers',
hue='month',
)
# 注:年份和人数虽非严格连续数据,但数据量足以体现变化趋势
plt.show()
```
也可以通过设置 `markers=True` 和 `dashes=False` 展示折点 (@fig-lineplot-hue-style) :
```{python}
#| label: fig-lineplot-hue-style
#| fig-cap: "按月份颜色和点形状区分的折线图"
sns.lineplot(
data=flights, x='year', y='passengers',
hue='month', style='month',
markers=True, # 需与 style 联用
dashes=False,
)
plt.show()
```
当折点很多时,不建议在折线图中展示折点,过多的折点会阻碍阅读;清晰的线条更能彰显变化趋势 [(Wilke, 2019, pp. 135-137)](https://clauswilke.com/dataviz/time-series.html#multiple-time-series-and-doseresponse-curves)。
也可以用点图达到类似效果 (见 @fig-pointplot-passenger-trend) ,但 `sns.pointplot()` 不可用不同点形状区分变量,也不可去除点,因此要观察变量随时间的变化趋势,最好选择 `sns.lineplot()`。
```{python}
#| label: fig-pointplot-passenger-trend
#| fig-cap: "点图: 乘客量随时间的变化趋势"
sns.pointplot(
data=flights, x='year', y='passengers', hue='month',
)
plt.show()
```
当 y 轴变量在每个时间点上有多个值,且未对其进行颜色区分时,`sns.lineplot()` 会自动生成平均值折线和误差区间 (默认 95% 置信水平) ,见 @fig-lineplot-without-hue-style:
```{python}
#| label: fig-lineplot-without-hue-style
#| fig-cap: "不做区分则生成平均值折线 (上下边缘为旺淡季)"
sns.lineplot(data=flights, x='year', y='passengers')
plt.show()
```
**在折线图中使用颜色区分线条时,需要注意:**
- **图例颜色顺序应当符合线条颜色顺序。**
- **选色尽量兼顾色觉缺陷读者。**
@fig-tech-stocks-bad-legend 中图例和线条颜色顺序不一致,会增加阅读困难,[Wilke (2019, p.248)](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-bad-legend) 提供了反面案例:
[{#fig-tech-stocks-bad-legend fig-alt="反面案例:图例和线条颜色顺序不匹配" width="85%"}](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-bad-legend)
相反,@fig-tech-stocks-good-legend 中图例和线条颜色顺序相符,[Wilke (2019, p.249)](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-legend) 提供了改良后的图表:
[{#fig-tech-stocks-good-legend fig-alt="改良版:图例和线条颜色顺序匹配 (且选色兼顾色觉缺陷读者) " width="85%"}](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-legend)
[Wilke (2019, p.250)](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-legend-cvd) 还展示了 @fig-tech-stocks-good-legend 在不同色觉缺陷模拟下及去除饱和度后的效果 (@fig-tech-stocks-good-legend-cvd) :
[{#fig-tech-stocks-good-legend-cvd fig-alt="不同色觉缺陷模拟 & 去饱和度下的图表"}](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-legend-cvd)
由 @fig-tech-stocks-good-legend-cvd 可见,@fig-tech-stocks-good-legend 的配色对三种色觉缺陷患者均可区分,去除饱和度后也能通过明度区分。因此图例与线条颜色顺序匹配尤为重要。
此外,[Wilke (2019, p.251)](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-no-legend) 还建议**去除图例,直接在折线旁标注文字** (@fig-tech-stocks-good-no-legend) ,可节省读者对照图例的工作量,让图表更易读。但这种做法通过 Seaborn 实现较困难,本课程中使用 @fig-tech-stocks-good-legend 中符合颜色顺序的图例即可。
[{#fig-tech-stocks-good-no-legend fig-alt="去除图例,直接在折线旁边标注文字" width="90%"}](https://clauswilke.com/dataviz/redundant-coding.html#fig:tech-stocks-good-no-legend)
# 热力图
## 数据透视表
在绘制热力图之前,需要先为原数据创建 **pivot table (数据透视表,又称枢轴表) **。数据透视表将原表格中的两个变量以矩阵形式展现:列名是一个变量,行名是另一个变量。
pivot 操作将原表某列中的所有数据种类转变为新的列名 (column label) 或行名/索引 (index) 。如 @tbl-flights-pivot 将 @tbl-flights-head 中 `'year'` 列的所有数据种类 (1949~1960) 变为新列名,将 `'month'` 列的数据种类变为新行名。
pivot 操作和 melt 操作相反:pivot 将"长表格"变为"宽表格",melt 将"宽表格"变为"长表格" (melt 将原列名变为数据值,让表格行数增多) 。
```{python}
#| label: tbl-flights-head
#| tbl-cap: "原飞行乘客表 (预览前五行)"
flights.head()
```
```{python}
#| label: tbl-flights-pivot
#| tbl-cap: "数据透视表: 年&月 - 乘客量"
# 创建数据透视表 (也可命名为 matrix)
flights_pivot = pd.pivot_table(
flights,
index='month', # 'month' 的数据种类作为新行名
columns='year', # 'year' 的数据种类作为新列名
values='passengers',
observed=False, # 显示所有分类变量的可能组合
)
flights_pivot
```
**关于 `aggfunc` 参数。** `pd.pivot_table()` 的 `aggfunc` (aggregation function) 默认为 `'mean'`,即当一个单元格对应多行原数据时,默认取平均值。
@tbl-flights-head 中特定 year 和 month 下 passenger 只有一个值,不需要求平均值。而如 @tbl-penguins-head 所示的企鹅数据表,同一种类、同一岛屿的企鹅不止一只,在数据透视表 (@tbl-penguins-pivot) 中只对应一个单元格,因此默认求平均值。
```{python}
#| label: tbl-penguins-head
#| #| tbl-cap: "原企鹅数据表 (预览前五行)"
df.head()
```
```{python}
#| label: tbl-penguins-pivot
#| tbl-cap: "数据透视表:企鹅种类 & 岛屿 - 喙长"
# 用企鹅数据集的种类和岛屿列制作数据透视表
df_pivot = pd.pivot_table(
df,
index='species',
columns='island',
values='bill_length_mm',
)
df_pivot
```
## 绘制热力图
使用 @tbl-flights-pivot 绘制热力图,见 @fig-heatmap-flights:
```{python}
#| label: fig-heatmap-flights
#| fig-cap: "基础热力图: 飞行航班"
sns.heatmap(
data=flights_pivot,
cbar_kws={'label': 'passengers'}, # 色彩条标签
)
plt.show()
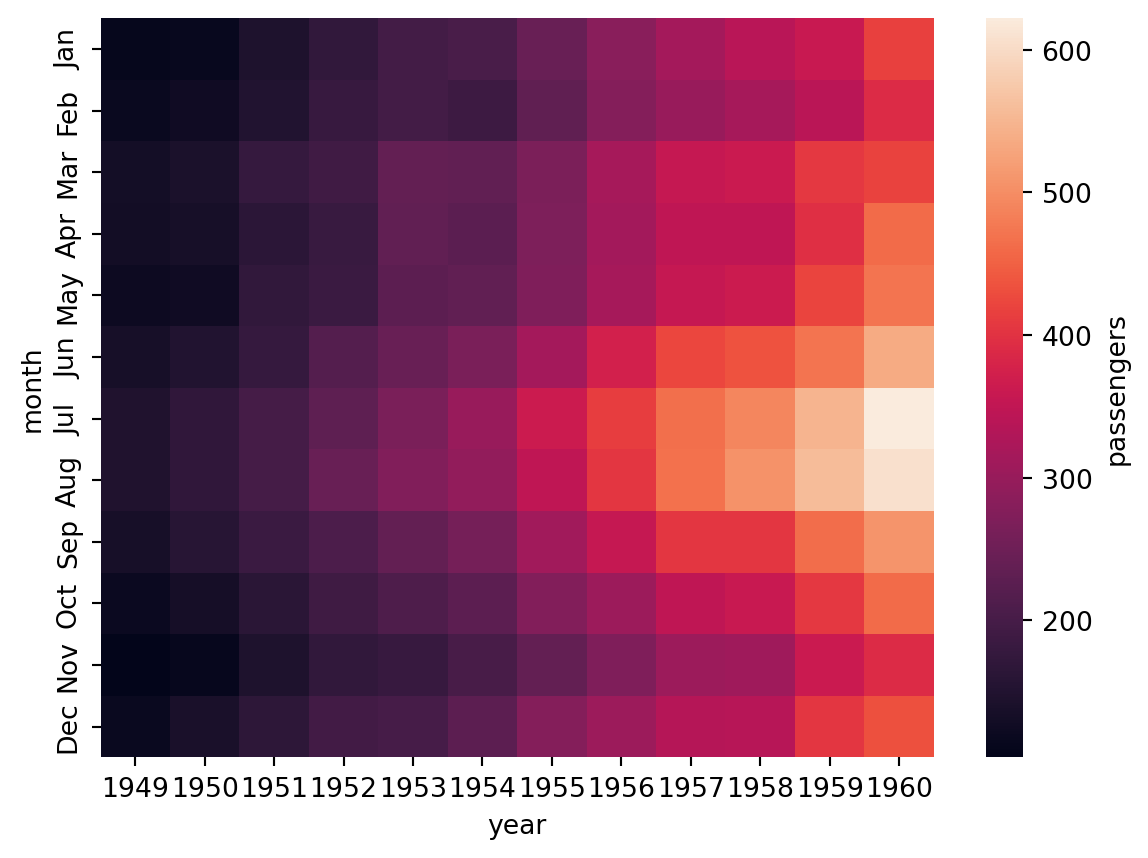
```
`.heatmap` 直接使用矩阵形式的表格画图,而非通过 x/y 参数指定特定列。`cbar_kws` (colorbar keyword arguments) 用于设置色彩条的标签。
还可以通过设置 `cmap` 和 `annot` 等参数进一步修改热力图 (@fig-heatmap-flights-arguments) :
```{python}
#| label: fig-heatmap-flights-arguments
#| fig-cap: "热力图: 添加更多参数 (args)"
sns.heatmap(
data=flights_pivot,
cbar_kws={'label': 'passengers'},
cmap='viridis', # Matplotlib 预制 colormap
annot=True, # 在格子中显示数值
fmt='.0f', # 格式:保留整数 ('.nf' 保留 n 位小数)
)
plt.show()
```
`cmap` 可以使用 Seaborn 或 Matplotlib 中预制的 color palette 或 colormap 名称,如 `'crest'`、`'flare'`、`'viridis'`、`'pink'` 等。
同理,使用 @tbl-penguins-pivot 绘制热力图 (@fig-heatmap-penguins) :
```{python}
#| label: fig-heatmap-penguins
#| fig-cap: "企鹅数据热力图"
sns.heatmap(
data=df_pivot,
cmap='crest',
cbar_kws={'label': 'bill_length_mm'},
annot=True,
)
plt.show()
```
# 二维直方图
根据 [Wilke (2019, pp. 222-225)](https://clauswilke.com/dataviz/overlapping-points.html#fig:nycflights-points),含半透明点的散点图可展示数据在两个变量控制下的分布,但当数据点过多、过密时,散点图难以展示整体分布 (见 @fig-nycflights-points: 点密度高的区域显示为均匀深色斑点,密度低的区域几乎不可见) 。
[{#fig-nycflights-points fig-alt="数据点过多、过密的散点图 (Wilke, 2019, p. 223)" width="80%"}](https://clauswilke.com/dataviz/overlapping-points.html#fig:nycflights-points)
此时可改用 **二维直方图 (2D histogram)** :将 x-y 平面细分为小矩形 (分箱,bin) ,计算落入每个分箱的数据量,并按数据量对矩形着色 (见 @fig-2d-histogram) :
```{python}
#| label: fig-2d-histogram
#| fig-cap: "二维直方图"
sns.histplot(
data=df, x='bill_depth_mm', y='bill_length_mm',
cbar=True, # 显示色彩条
cbar_kws={'label': 'count'},
)
plt.show()
```
@tbl-heatmap-2d-histogram 展示了热力图和二维直方图的区别:
| 特性 | 热力图 (Heatmap) | 二维直方图 (2D Histogram) |
|------|------|------|
| 输入数据 | 预处理的矩阵 (通常来自 Pivot Table) | 原始数据 |
| 横纵轴 | 通常表示两个离散变量 | 通常表示两个连续变量 |
| 变量个数 | 三个:横纵轴和颜色 | 两个:横纵轴 |
| 颜色含义 | 单元格中的数值大小 | 分箱 (bin) 中的数据点数量 |
| 排布方式 | 行列数固定,颜色对应值固定 | 根据分箱数量可改变形状 |
| 主要用途 | 展示矩阵中的数值模式 | 展示两个变量的联合分布密度 |
: 热力图和二维直方图的区别 {#tbl-heatmap-2d-histogram}
# 双变量图
利用 `sns.jointplot()` 可以同时展示两个变量的二元分布图和各自的一元分布图。
如 @fig-jointplot-histograms,可以在展示二维直方图 (同 @fig-2d-histogram) 的同时,展示两个变量各自的一维直方图:
```{python}
#| label: fig-jointplot-histograms
#| fig-cap: "双变量图: 直方图形式"
sns.jointplot(
data=df, x='bill_depth_mm', y='bill_length_mm',
kind='hist', # 默认为 'scatter',此处改为直方图
)
plt.show()
```
还可以通过 `kind='hex'` 让中间的格子呈六边形 (@fig-jointplot-hexagonal) :
```{python}
#| label: fig-jointplot-hexagonal
#| fig-cap: "双变量图: 六边形图形式"
sns.jointplot(
data=df, x='bill_depth_mm', y='bill_length_mm',
kind='hex',
)
plt.show()
```
还可以用颜色区分变量 (@fig-jointplot-hue) :
```{python}
#| label: fig-jointplot-hue
#| fig-cap: "双变量图: 用 hue 区分 (外部一元图自动变为密度图)"
sns.jointplot(
data=df, x="bill_depth_mm", y="bill_length_mm",
hue="species",
)
plt.show()
```
还可以通过 `kind='kde'` (kernel density estimation) 生成光滑化的分布曲线 (见 @fig-jointplot-kde) 。 但光滑化后的曲线并非真实数据,尤其在数据点很少时可能误导读者,因此本课程中不建议使用。
```{python}
#| label: fig-jointplot-kde
#| fig-cap: "双变量图: 用 kde 人工光滑化 (不推荐)"
sns.jointplot(
data=df, x="bill_depth_mm", y="bill_length_mm",
hue="species", kind='kde',
)
plt.show()
```
# 配对图
使用 `sns.pairplot()` 可以轻松画出原数据表中多个变量 (即多列) 各自两两配对的分布图,形成图表阵 (@fig-pairplot) :
```{python}
#| label: fig-pairplot
#| fig-cap: "配对图 (height 调整图片高度)"
sns.pairplot(data=df, hue='species', height=1.7)
plt.show()
```
@fig-pairplot 中,原 DataFrame 中的四个 ratio 变量被自动识别并画图:对角线的图是各变量各自的一元分布图,其余每个子图是基于一对变量绘制的二元分布图。
还可以通过设置 `diag_kind` 和 `kind` 来修改对角线图表和其他二元图表的格式 (@fig-pairplot-histograms) :
```{python}
#| label: fig-pairplot-histograms
#| fig-cap: "配对图: 直方图形式"
sns.pairplot(
data=df,
hue='species',
diag_kind='hist', # 对角线图表的形式
kind='hist', # 其他二元分布图的形式
height=1.7,
)
plt.show()
```