环境与版本
python==3.12
pandas==2.2.2python==3.12
pandas==2.2.2读取 CSV 文件:
pd.read_csv(path) 将 CSV 文件读取为 Pandas DataFrame。/(Windows 中也可以使用转义反斜杠 \\)。# 导入数据
import pandas as pd
path = "../../../src/data/beer-and-curry.csv"
df = pd.read_csv(path) # 将 CSV 文件读取为 DataFrame
df.head(2) # 查看前 2 行| created_at | utc_time | mentions | text | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 06/05/2020 | 11:11:49 | NaN | NINE SPICES?????????????????\n?9??SPICE????NIN... | https://t.co/wddjIaJTcD | 24 | 12 | 9spices | ??????????2-1-2 HANROKU??B1 | 3820 | 1961 | 10/02/2010 | 296 | False |
| 1 | 07/07/2020 | 08:08:54 | @lizzie_hubbard2 @JetsettersFlyin @suziday123 ... | Thanks for the invite to join #TravelWinePart... | https://t.co/6Z7GgkJE8v | 6 | 17 | ExpressionsSA | Cape Town South Africa | 5088 | 5284 | 24/06/2011 | 15625 | False |
当分析所需的列中存在缺失值时,可以使用 dropna() 删除对应行。
# 删除 'text' 或 'retweet_count' 缺失(值为 NA 或 NaN)的行
df_clean = df.dropna(subset=["text", "retweet_count"])
删除缺失值:
df.dropna() 删除包含缺失值(NA 或 NaN)的行。subset 指定列名列表,只根据这些列中的缺失值来决定是否删除整行。subset 的列名集合可以使用圆括号 () 或方括号 []。注意: 数据预处理时,通常不需要直接删除所有包含缺失值的行。更稳妥的做法是只针对分析所需的关键列删除缺失值,以尽量保持数据准确性。
df.shape # 查看原始形状(行数和列数)(430, 14)df_clean.shape # 删除缺失值后的形状(429, 14)当缺失值应该被替换而不是删除时,可以使用 fillna()。
# 用占位字符串填充 'mentions' 中的缺失值
df["mentions"] = df["mentions"].fillna("No Mentioned User")

# 查看 'mentions' 列中替换后的值
df.head(3)["mentions"]
0 No Mentioned User
1 @lizzie_hubbard2 @JetsettersFlyin @suziday123 ...
2 @craftbeerncl! @RidgesideBrewer @Manjitskitche...
Name: mentions, dtype: object填充缺失值:
df.fillna(value) 将某一列中的缺失值替换为指定占位值,例如字符串。使用 replace() 可以将占位值转换为更适合后续分析的表示方式。
# 将占位字符串替换为 0
df["mentions"] = df["mentions"].replace("No Mentioned User", 0)

# 查看 'mentions' 列中替换后的值
df.head(3)["mentions"]
0 0
1 @lizzie_hubbard2 @JetsettersFlyin @suziday123 ...
2 @craftbeerncl! @RidgesideBrewer @Manjitskitche...
Name: mentions, dtype: object替换特定值:
df.replace(old_value, new_value) 替换某一列中的特定值。使用 rename() 可以让列名更简短、更清晰。
# 将 'text' 重命名为 'content',将 'created_at' 重命名为 'date'
df = df.rename(columns={"text": "content", "created_at": "date"})

# 查看重命名后的列
df.head(2)| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 06/05/2020 | 11:11:49 | 0 | NINE SPICES?????????????????\n?9??SPICE????NIN... | https://t.co/wddjIaJTcD | 24 | 12 | 9spices | ??????????2-1-2 HANROKU??B1 | 3820 | 1961 | 10/02/2010 | 296 | False |
| 1 | 07/07/2020 | 08:08:54 | @lizzie_hubbard2 @JetsettersFlyin @suziday123 ... | Thanks for the invite to join #TravelWinePart... | https://t.co/6Z7GgkJE8v | 6 | 17 | ExpressionsSA | Cape Town South Africa | 5088 | 5284 | 24/06/2011 | 15625 | False |
重命名列:
df.rename(columns={'old_name': 'new_name'}) 通过字典重命名列。index 参数重命名索引。在创建衍生指标前,先删除粉丝数缺失的行。
# 指定特定列,用于删除含缺失值的行
df = df.dropna(subset=["user.followers_count"])

# 查看已清理的数据,其中粉丝数没有缺失值
df.head(2)| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 06/05/2020 | 11:11:49 | 0 | NINE SPICES?????????????????\n?9??SPICE????NIN... | https://t.co/wddjIaJTcD | 24 | 12 | 9spices | ??????????2-1-2 HANROKU??B1 | 3820 | 1961 | 10/02/2010 | 296 | False |
| 1 | 07/07/2020 | 08:08:54 | @lizzie_hubbard2 @JetsettersFlyin @suziday123 ... | Thanks for the invite to join #TravelWinePart... | https://t.co/6Z7GgkJE8v | 6 | 17 | ExpressionsSA | Cape Town South Africa | 5088 | 5284 | 24/06/2011 | 15625 | False |
创建新列:
df.dropna(subset=['column']) 清理相关列中的缺失值。可以对现有列进行向量化计算,并将结果保存为新列。
# 通过将 'user.followers_count' 除以 1000 创建新列 'followers_k'
df["followers_k"] = df["user.followers_count"] / 1000

# 同时查看新列和原始粉丝数
df.head(3)[["followers_k", "user.followers_count"]]| followers_k | user.followers_count | |
|---|---|---|
| 0 | 3.820 | 3820 |
| 1 | 5.088 | 5088 |
| 2 | 0.446 | 446 |
创建新列:
df['new_col'] = df['existing_col'] / 1000。当转换逻辑用命名函数表达更清晰时,可以先定义可复用函数。
# 定义函数,用于计算百分比形式的互动率(Engagement Rate: ER)
def calc_er(engagement_count, follower_count):
    return (engagement_count / follower_count) * 100
# 应用计算出的互动率,并赋值给新列 'er_rt_fo'
df["er_rt_fo"] = calc_er(
df["retweet_count"],
df["user.followers_count"],
)
# 同时查看新的互动率列和原始指标
df.head(3)[["er_rt_fo", "retweet_count", "user.followers_count"]]| er_rt_fo | retweet_count | user.followers_count | |
|---|---|---|---|
| 0 | 0.628272 | 24 | 3820 |
| 1 | 0.117925 | 6 | 5088 |
| 2 | 0.896861 | 4 | 446 |
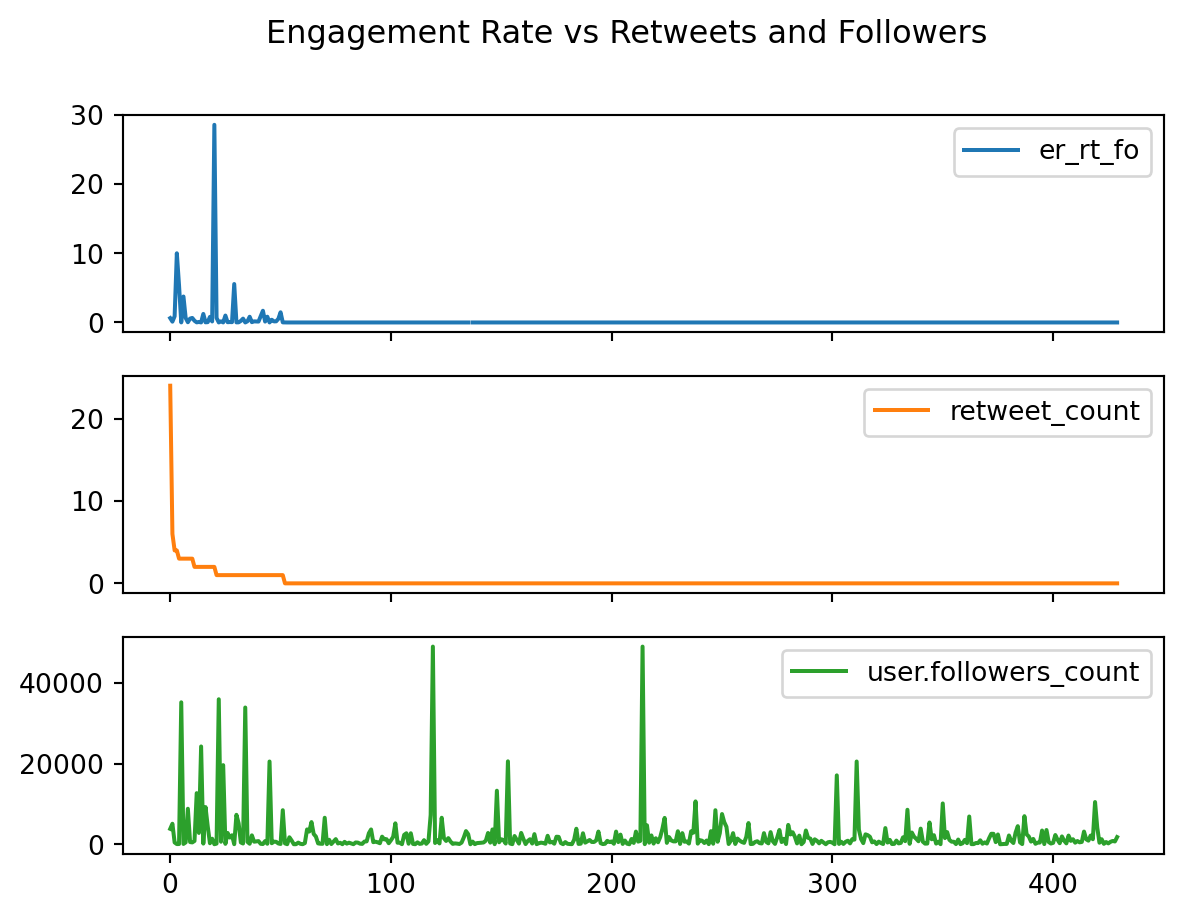
# 可视化互动率与另外两个指标之间的关系
ax = df[["er_rt_fo", "retweet_count", "user.followers_count"]].plot(
    subplots=True,
    title="Engagement Rate vs Retweets and Followers",
)
创建新列:
.values 从 Series 中提取数组值。df.plot() 进行快速可视化;subplots=True 会生成分面图,figsize 控制尺寸,kind 控制图形类型(默认是 'line',也可以使用 'bar'、'hist'、'scatter'、'pie')。使用 duplicated() 删除完全重复的行。
# 删除完全重复的行(保留第一次出现的记录)
# ~ 是取反运算符
df = df[~df.duplicated()]
查找重复值:
df.duplicated() 识别重复行;它会返回一个布尔值 Series。~df.duplicated() 可以只保留非重复行。subset 指定列名列表,只根据这些列判断是否重复。keep=False 可以标记所有重复项。通过指定列子集,可以找出同一个用户在同一天发布多条内容的记录。
# 根据 'user' 和 'date' 列查找重复行(保留所有重复记录)
df[df.duplicated(subset=["user", "date"], keep=False)].head(2)| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | followers_k | er_rt_fo | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 7 | 29/02/2020 | 14:42:01 | @MCRCycleSam @CatrionaSwanson @bricycle @marty... | A gathering of UK transport activists; cycle s... | https://t.co/OcyyKkhmUh | 3 | 15 | davelostdave | somewhere | 459 | 1287 | 15/06/2009 | 23700 | False | 0.459 | 0.653595 |
| 10 | 29/02/2020 | 23:41:58 | @CatrionaSwanson @Chris_Boardman @Chris_Boardman | Maybe we could put the spotlight on #Bradford ... | https://t.co/0ExO7wr1ld | 3 | 11 | davelostdave | somewhere | 459 | 1287 | 15/06/2009 | 23700 | False | 0.459 | 0.653595 |
使用 sort_values() 按多个列对行排序。
# 先按 'retweet_count',再按 'user.followers_count' 降序排序
df.sort_values(
    by=["retweet_count", "user.followers_count"],
    ascending=False,
).head(2)| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | followers_k | er_rt_fo | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 06/05/2020 | 11:11:49 | 0 | NINE SPICES?????????????????\n?9??SPICE????NIN... | https://t.co/wddjIaJTcD | 24 | 12 | 9spices | ??????????2-1-2 HANROKU??B1 | 3820 | 1961 | 10/02/2010 | 296 | False | 3.820 | 0.628272 |
| 1 | 07/07/2020 | 08:08:54 | @lizzie_hubbard2 @JetsettersFlyin @suziday123 ... | Thanks for the invite to join #TravelWinePart... | https://t.co/6Z7GgkJE8v | 6 | 17 | ExpressionsSA | Cape Town South Africa | 5088 | 5284 | 24/06/2011 | 15625 | False | 5.088 | 0.117925 |
重新排序和重塑:
df.sort_values(by=['col1', 'col2'], ascending=False) 可以按多个列进行降序排序。df.transpose() 可以交换行和列。当需要切换行和列以便检查数据时,可以转置 DataFrame。
df.transpose().head(3) # 查看行列互换后的 DataFrame| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | ... | 420 | 421 | 422 | 423 | 424 | 425 | 426 | 427 | 428 | 429 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| date | 06/05/2020 | 07/07/2020 | 31/03/2020 | 29/05/2020 | 28/11/2020 | 01/07/2020 | 08/01/2020 | 29/02/2020 | 03/05/2020 | 16/01/2020 | ... | 10/04/2020 | 27/11/2020 | 09/12/2020 | 25/03/2020 | 25/06/2020 | 30/12/2020 | 30/08/2020 | 04/03/2020 | 10/08/2020 | 07/03/2020 |
| utc_time | 11:11:49 | 08:08:54 | 13:39:02 | 20:58:17 | 04:46:37 | 06:35:04 | 10:26:36 | 14:42:01 | 17:05:51 | 17:50:08 | ... | 23:23:26 | 23:31:09 | 23:32:06 | 23:36:02 | 23:38:41 | 23:45:00 | 23:54:19 | 23:55:19 | 23:55:38 | 23:59:42 |
| mentions | 0 | @lizzie_hubbard2 @JetsettersFlyin @suziday123 ... | @craftbeerncl! @RidgesideBrewer @Manjitskitche... | @StCannas @keralankaravan | @yooneedmorejodi | 0 | 0 | @MCRCycleSam @CatrionaSwanson @bricycle @marty... | @DrewPritchard | @Nellachops73 @MotorheadBeer @CameronsBrewery ... | ... | @ashley_collings | @101andyhibberd | @MariaMo71609443 @jckiker @ScottAdamsSays | @lonelyplanet | 0 | @Photos_in_Chile | @jesshousty @WilliamHousty | @beer_porter @siretoknote | 0 | 0 |
3 rows × 430 columns
读取第二个数据集,并使用 concat() 合并。
path2 = "../../../src/data/keto-and-vegan.csv"
df2 = pd.read_csv(path2, encoding="latin-1") # 加载 df
df2.head(2) # 查看前 2 行| created_at | utc_time | mentions | text | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 01/01/2020 | 23:10:27 | @BioLayne | is one of the most respected and unbiased nutr... | https://t.co/WDDhoIvXl5 | 0 | 0 | Eric_OGrey | Sacramento, CA | 2333 | 1084 | 10/03/2016 | 23996 | False |
| 1 | 02/01/2020 | 18:16:26 | @greggprescott1 | I am O +, which is high protein, than fat, the... | https://t.co/1hBpp6MGnu | 0 | 0 | Glory32X | Belgium | 636 | 64 | 11/07/2009 | 22357 | False |
将列结构匹配的数据表纵向追加:
# 纵向拼接 df 和 df2(堆叠行)
pd.concat([df, df2]).iloc[428:432,] # 查看第 428 到 431 行| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | followers_k | er_rt_fo | created_at | text | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 428 | 10/08/2020 | 23:55:38 | 0 | Made the terrible horrible no-good mistake of ... | https://t.co/AF23qFRBTv | 0 | 3 | elizvogt | NYC now, Texas forever | 687 | 1105 | 07/03/2011 | 39909 | False | 0.687 | 0.0 | NaN | NaN |
| 429 | 07/03/2020 | 23:59:42 | 0 | This is how I'm celebrating tonight y'all! Bee... | https://t.co/Fh7wRYCguR | 0 | 30 | Rose262 | Atlanta, GA | 1776 | 1121 | 10/05/2009 | 30246 | False | 1.776 | 0.0 | NaN | NaN |
| 0 | NaN | 23:10:27 | @BioLayne | NaN | https://t.co/WDDhoIvXl5 | 0 | 0 | Eric_OGrey | Sacramento, CA | 2333 | 1084 | 10/03/2016 | 23996 | False | NaN | NaN | 01/01/2020 | is one of the most respected and unbiased nutr... |
| 1 | NaN | 18:16:26 | @greggprescott1 | NaN | https://t.co/1hBpp6MGnu | 0 | 0 | Glory32X | Belgium | 636 | 64 | 11/07/2009 | 22357 | False | NaN | NaN | 02/01/2020 | I am O +, which is high protein, than fat, the... |
连接数据:
pd.read_csv() 读取额外数据集,必要时指定 encoding。pd.concat([df1, df2]) 可以将列结构匹配的 DataFrame 纵向拼接。.reset_index(drop=True) 可以重置索引,使合并后的行索引连续。拼接后,如果希望得到连续的行索引,可以重置索引。
# 拼接 df 和 df2,然后重置索引
pd.concat([df, df2]).reset_index(drop=True).iloc[428:432,]| date | utc_time | mentions | content | url | retweet_count | favorite_count | user | user.location | user.followers_count | user.friends_count | user.created_at | user.favourites_count | user.verified | followers_k | er_rt_fo | created_at | text | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 428 | 10/08/2020 | 23:55:38 | 0 | Made the terrible horrible no-good mistake of ... | https://t.co/AF23qFRBTv | 0 | 3 | elizvogt | NYC now, Texas forever | 687 | 1105 | 07/03/2011 | 39909 | False | 0.687 | 0.0 | NaN | NaN |
| 429 | 07/03/2020 | 23:59:42 | 0 | This is how I'm celebrating tonight y'all! Bee... | https://t.co/Fh7wRYCguR | 0 | 30 | Rose262 | Atlanta, GA | 1776 | 1121 | 10/05/2009 | 30246 | False | 1.776 | 0.0 | NaN | NaN |
| 430 | NaN | 23:10:27 | @BioLayne | NaN | https://t.co/WDDhoIvXl5 | 0 | 0 | Eric_OGrey | Sacramento, CA | 2333 | 1084 | 10/03/2016 | 23996 | False | NaN | NaN | 01/01/2020 | is one of the most respected and unbiased nutr... |
| 431 | NaN | 18:16:26 | @greggprescott1 | NaN | https://t.co/1hBpp6MGnu | 0 | 0 | Glory32X | Belgium | 636 | 64 | 11/07/2009 | 22357 | False | NaN | NaN | 02/01/2020 | I am O +, which is high protein, than fat, the... |
使用 groupby() 搭配 agg() 可以按组计算汇总统计值。下面的例子会计算每个用户的总转发量和平均粉丝数。
# 按 'user' 分组,然后对 'retweet_count' 求和,
# 对 'user.followers_count' 求平均值
df_agg = df.groupby("user").agg(
    {"retweet_count": "sum", "user.followers_count": "mean",}
)

# 查看聚合结果
df_agg.head(3)| retweet_count | user.followers_count | |
|---|---|---|
| user | ||
| 1nnkeeper | 0 | 557.0 |
| 353a9f40f97e4a9 | 2 | 4440.0 |
| 6M70_JET | 0 | 548.0 |
分组和聚合:
df.groupby('column').agg({'col1': 'sum', 'col2': 'mean'}) 可以按某一列分组,并计算聚合统计值。df[~df.duplicated(subset='column')].shape 或 df['column'].nunique() 检查分组数量。可以将分组结果与唯一用户数量进行比较:
# 通过基于 'user' 列删除重复值来统计唯一用户
df[~df.duplicated(subset="user")].shape
(390, 16)# 或者直接用 nunique() 统计唯一用户数量
df["user"].nunique()390Melt: wide → long
使用 melt() 可以将宽表转换为长表,便于分析和绘图。
# 创建一个包含宠物类型和数量的宽格式示例 DataFrame
df_wide = pd.DataFrame(
    data=[
        ["cat", 4, 5],
        ["dog", 7, 4],
        ["rabbit", 2, 3],
    ],
    columns=["pet", "male", "female"],
)

df_wide # 查看该 DataFrame| pet | male | female | |
|---|---|---|---|
| 0 | cat | 4 | 5 |
| 1 | dog | 7 | 4 |
| 2 | rabbit | 2 | 3 |
不传入参数时,melt() 会将所有列折叠为 variable-value 形式。
df_wide.melt() # 将所有列转换为变量-值对(转换为长表)| variable | value | |
|---|---|---|
| 0 | pet | cat |
| 1 | pet | dog |
| 2 | pet | rabbit |
| 3 | male | 4 |
| 4 | male | 7 |
| 5 | male | 2 |
| 6 | female | 5 |
| 7 | female | 4 |
| 8 | female | 3 |
可以指定标识符列和值列,得到结构更清晰的长表。
melted_df = pd.melt(
    df_wide,
    id_vars=["pet"], # 保留 'pet' 作为标识符列
    value_vars=["male", "female"], # 值列
    var_name="sex", # 新变量列的名称
    value_name="count", # 新值列的名称
)Pivot: long → wide
将长表重新转换回宽表:
df_pivot = melted_df.pivot(
    index="pet", # 标识符列变为索引
    columns="sex", # 变量列中的类别变为新列
    values="count", # 值列变为新的数值
).reset_index() # 重置索引,将 'pet' 转回普通列

df_pivot.columns.name = None # 移除列索引的名称

df_pivot # 查看透视后的 DataFrame| pet | female | male | |
|---|---|---|---|
| 0 | cat | 5 | 4 |
| 1 | dog | 4 | 7 |
| 2 | rabbit | 3 | 2 |
当 index/column 组合存在重复值时,应使用 pivot_table() 而不是 pivot(),并指定类似 aggfunc='mean' 的聚合函数来汇总重复项。
例如,如果存在重复的宠物记录:
# 创建一个包含重复宠物记录的示例 DataFrame
df_long = pd.DataFrame(
    data=[
        ["cat", "male", 4],
        ["cat", "female", 5],
        ["dog", "female", 7],
        ["dog", "male", 4],
        ["rabbit", "male", 2],
        ["rabbit", "female", 3],
    ],
    columns=["pet", "sex", "count"],
)
df_long # 查看包含重复值的长格式 DataFrame| pet | sex | count | |
|---|---|---|---|
| 0 | cat | male | 4 |
| 1 | cat | female | 5 |
| 2 | dog | female | 7 |
| 3 | dog | male | 4 |
| 4 | rabbit | male | 2 |
| 5 | rabbit | female | 3 |
要将这个长表转换回宽表,可以使用 pivot_table() 处理重复项:
# 创建透视表,对重复记录的数量取平均值
(df_long
.pivot_table(
    index="pet",
    columns="sex",
    values="count",
    aggfunc="mean", # 对重复记录的数量取平均值
)
.rename_axis(None, axis=1) # 移除列标题的名称
.rename_axis(None) # 移除索引的名称
)| female | male | |
|---|---|---|
| cat | 5.0 | 4.0 |
| dog | 7.0 | 4.0 |
| rabbit | 3.0 | 2.0 |