环境与版本
python==3.12
pandas==2.2.2
matplotlib==3.9.x
plotly==5.24.1python==3.12
pandas==2.2.2
matplotlib==3.9.x
plotly==5.24.1本项目使用由欧洲大学学院移民政策中心研究人员创建的全球签证费用数据集 (Recchi 等, 2020),该数据集提供了 2019 年各国家对之间七类签证费用的详细信息(详细说明见附录)。数据主要通过手动从各国政府官网收集。以下各节将使用三种交互式图表——桑基图、条形图和等值线地图——对数据进行可视化。
import pandas as pd  # 用于处理 DataFrame

# 定义数据集文件路径并读取数据集
path = "../../../src/data/GMP_GlobalVisaCostDataset_version1.1.csv"
df = pd.read_csv(path, delimiter='\t') # 读取以制表符分隔的 CSV 文件

#【delimiter】
# 该参数指定读取 CSV 文件时使用的分隔符,
# 其中 '\t' 表示制表符(Pandas, 2024e)。## 定义新变量 df0,用于存储指定列中不含缺失值的 DataFrame,
# 从而确保桑基图只包含有效节点。
df0 = df.dropna(
subset=[
'tourist_visa',
'source',
'source_region',
'source_subregion',
]
)
#【.dropna()】
# 该方法会删除包含任意缺失值的行(Pandas, 2024b)。
#【subset】
# 该参数指定删除缺失值时需要考虑哪些列。在本例中,
# 这些列将用于创建桑基图。
# 为了简化分析,本项目仅使用最常见的旅游签证数据
# (Recchi et al., 2021, p. 7)。##############################################################################
## 定义列表,用于存储节点标签
source_region_labels = list(df0['source_region'].unique())
source_subregion_labels = list(df0['source_subregion'].unique())
#【.unique()】
# 该方法会从 Series 对象中返回一个包含唯一值列表的 Array 对象
# (Pandas, 2024f)。在本例中,DataFrame df0 中的
# 'source_region' 和 'source_subregion' 列作为 Series 对象,
# 且缺失值已通过 .dropna() 方法删除。随后使用 .unique() 方法
# 从各列返回包含唯一值列表的 Array 对象。这些值将用于创建节点标签。
#【list()】
# 该 Python 内置函数(也是类)会将输入转换为列表(Python, 2024a)。
# 在本例中,它用于将上述 Array 对象转换为 Python 列表对象。
##############################################################################
## 合并列表,定义一个包含全部节点标签的完整列表
node_labels = ['World'] + source_region_labels + source_subregion_labels
#【+】
# 该运算符会将两个或多个序列(如列表)拼接成一个序列
# (Python, 2024b)。在本例中,它用于将多个节点标签列表合并为一个列表。
#【'World'】
# 'World' 被添加到列表开头,作为根节点标签。
##############################################################################
## 定义可迭代的 range 对象,用于存储各节点的索引
node_ids = range(len(node_labels))
#【len()】
# 该 Python 内置函数会返回对象中的项目数量(即对象长度),
# 对象可以是序列(如列表)或集合(如字典)(Python, 2024a)。
# 在本例中,它用于返回存储全部节点标签的 node_labels 列表长度,
# 该长度等于 23。
#【range()】
# 该 Python 内置函数(也是类)会返回一个数字序列,
# 默认从 0 开始(Python, 2024a)。在本例中,
# range(23) 表示从 0 到 22,正好对应 node_labels 列表中各项的索引。
##############################################################################
## 定义字典,用于存储各节点的标签与索引
nodes = dict(zip(node_labels, node_ids))
#【zip()】
# 该 Python 内置函数会并行迭代多个可迭代对象,
# 并生成由各对象对应元素组成的元组(Python, 2024a)。
#【dict()】
# 该 Python 内置函数(也是类)会从两个或多个序列创建字典
# (Python, 2024a)。在本例中,它用于创建一个字典,
# 其中键为节点标签,值为节点标签对应的索引。##############################################################################
## 创建聚合后的 DataFrame,用于存储相关数据,
# 并计算指向各子地区链接的数值。
to_subregion_value = df0.groupby('source_subregion').agg(
{
'source_region':'first', # 各子地区所属地区
'tourist_visa':'mean', # 各子地区的旅游签证费用均值
}
)
#【.groupby()】
# 该方法用于根据 'source_region' 列对 df0 中的行进行分组。
#【.agg()】
# 该方法用于计算各分组内数值的聚合结果。
#【'first'】
# 该聚合函数会返回 DataFrameGroupBy 对象中各分组内每列的第一个值
# (Pandas, 2024a)。在本例中,它用于选择各子地区分组中遇到的第一个地区
# (即该子地区所属地区)。
##############################################################################
## 创建聚合后的 DataFrame,用于存储指向各地区链接的数值。
to_region_value = (
to_subregion_value
.groupby('source_region')
.agg({'tourist_visa':'sum'})
)
##############################################################################
## 创建空列表,用于存储每条链接的来源、目标和值
sources = [] # 用于填入来源节点在节点标签中的索引
targets = [] # 用于填入目标节点在节点标签中的索引
values = [] # 用于填入每条链接的数值(tourist_visa)
## 从 'World' 到各地区
for region in source_region_labels:
# 将 'World' 作为来源节点加入列表
sources.append(nodes['World'])
# 将各地区作为目标节点加入列表
targets.append(nodes[region])
# 将 df0_agg1 中各地区的数值作为对应链接的值加入列表
values.append(to_region_value.loc[region,'tourist_visa'])
## 从各地区到各子地区
for subregion in source_subregion_labels:
# 将对应地区作为来源节点加入列表
# 获取对应地区
region = to_subregion_value.loc[subregion,'source_region']
sources.append(nodes[region])
# 将各子地区作为目标节点加入列表
targets.append(nodes[subregion])
# 将 df0_agg2 中各子地区的数值作为对应链接的值加入列表
values.append(to_subregion_value.loc[subregion,'tourist_visa'])print("地区:")
print(source_region_labels) # 检查 df0 中的地区地区:
['Asia', 'Africa', 'Europe', 'Americas', 'Oceania']##############################################################################
## 定义字典,用于存储地区颜色
region_colors = {
'Africa': '#6B3A09', # 棕色
'Asia': '#7FA709', # 绿色
'Americas': '#EC6C92', # 粉色
'Oceania': '#F5DA29', # 黄色
'Europe': '#85D6D5', # 蓝色
}
# 这些十六进制颜色由 Nichols(无日期)的配色生成器生成,
# 以便提高色盲人群的可见性。
##############################################################################
## 根据地区定义节点颜色
node_colors = [] # 创建空列表,用于存储节点颜色
# 使用 for 循环将节点颜色加入列表
for label in node_labels:
if label in source_region_labels:
node_colors.append(region_colors[label])
elif label in source_subregion_labels:
# 获取对应地区
region = to_subregion_value.loc[label,'source_region']
node_colors.append(region_colors[region])
else: # 如果标签为 'World'
node_colors.append('silver')
##############################################################################
## 定义带透明度的链接颜色
import matplotlib.colors as c # 用于创建 RGBA 格式的浅色
## 定义字符串,用于存储 RGBA 格式的浅色链接颜色
faint_Africa = 'rgba'+str(c.to_rgba(region_colors['Africa'], 0.5))
faint_Asia = 'rgba'+str(c.to_rgba(region_colors['Asia'], 0.5))
faint_Americas = 'rgba'+str(c.to_rgba(region_colors['Americas'], 0.5))
faint_Oceania = 'rgba'+str(c.to_rgba(region_colors['Oceania'], 0.5))
faint_Europe = 'rgba'+str(c.to_rgba(region_colors['Europe'], 0.5))
# 0.5: alpha=0.5,表示颜色透明度为 50%
##############################################################################
## 定义字典,用于按地区存储浅色链接颜色
faint_region_colors = {
'Africa': faint_Africa, # 浅棕色
'Asia': faint_Asia, # 浅绿色
'Americas': faint_Americas, # 浅粉色
'Oceania': faint_Oceania, # 浅黄色
'Europe': faint_Europe, # 浅蓝色
}
##############################################################################
## 根据地区定义链接颜色
link_colors = [] # 创建空列表,用于存储链接颜色
# 使用 for 循环将链接颜色加入列表
for source, target in zip(sources, targets):
if node_labels[source] in source_region_labels:
link_colors.append(faint_region_colors[node_labels[source]])
elif node_labels[target] in source_region_labels:
link_colors.append(faint_region_colors[node_labels[target]])
##############################################################################
# 检查节点颜色数量是否与节点数量一致
print('节点颜色数量 == 节点数量?')
print(len(node_colors) == len(nodes))
# 检查链接颜色数量是否与链接数量一致
print('链接颜色数量 == 链接数量?')
print(len(link_colors) == len(sources) == len(targets) == len(values))节点颜色数量 == 节点数量?
True
链接颜色数量 == 链接数量?
True##############################################################################
import plotly.graph_objects as go # 用于创建桑基图
## 通过 go.Sankey() 函数创建 Sankey 对象,用于存储桑基图数据
sankey_data = go.Sankey( # 定义变量,用于存储桑基图数据
# 定义节点
node = dict(
label = node_labels, # 节点标签
color = node_colors, # 节点颜色
pad = 30, # 节点之间的水平距离
thickness = 20, # 节点厚度
line = {'color':'black','width':0.5}, # 节点轮廓样式
),
# 定义链接
link = dict(
source = sources, # 来源节点在 node_labels 中的索引
target = targets, # 目标节点在 node_labels 中的索引
value = values, # 链接数值
color = link_colors, # 链接颜色
)
)
##############################################################################
# 通过 go.Figure() 函数创建 Figure 对象,用于存储桑基图数据
fig1 = go.Figure(sankey_data)
# 更新图形布局
fig1.update_layout(
# width = 800, height = 600,
margin = dict(t=60, b=24, l=20, r=20), # 边距
title_text = '''
各地区平均旅游签证费用桑基图
''',
title_x = 0.5, title_y = 0.95, # 标题位置
font = {'style':'italic'}, # 图形字体样式
)
#【.update_layout()】
# 该方法用于更新图形布局,
# 包括尺寸、标题、字体等(Plotly, 2024b)。
# fig1.show(config = {"responsive": True}) # 显示桑基图
fig1.show() # 显示桑基图
#【renderer】
# 该参数用于指定渲染图形时使用的渲染器(Plotly, 2024b),
# 其中 'notebook' 指 Jupyter notebook。
# 本项目使用带 Jupyter 扩展的 Visual Studio Code 编辑并导出为 HTML 文件。
# 在这种情况下,renderer='notebook' 对 Visual Studio Code 中的图形显示
# 和导出的 HTML 文件有效。不过,该参数在 Jupyter 的输出单元格中
# 似乎无法正常显示图形(但对导出的 HTML 文件有效)。如上所示,图 1 展示了全球各地区(如亚洲、欧洲、非洲)到其对应子地区(如东亚、北欧)的平均旅游签证费用流向。从各地区到子地区的链接宽度代表每个子地区(作为签证申请来源地)各国的平均旅游签证费用,而左侧从”世界”节点到各地区节点的链接宽度则为其对应子地区链接的总和。总体而言,该桑基图(图 1)展示了全球旅游签证费用的流向分布。
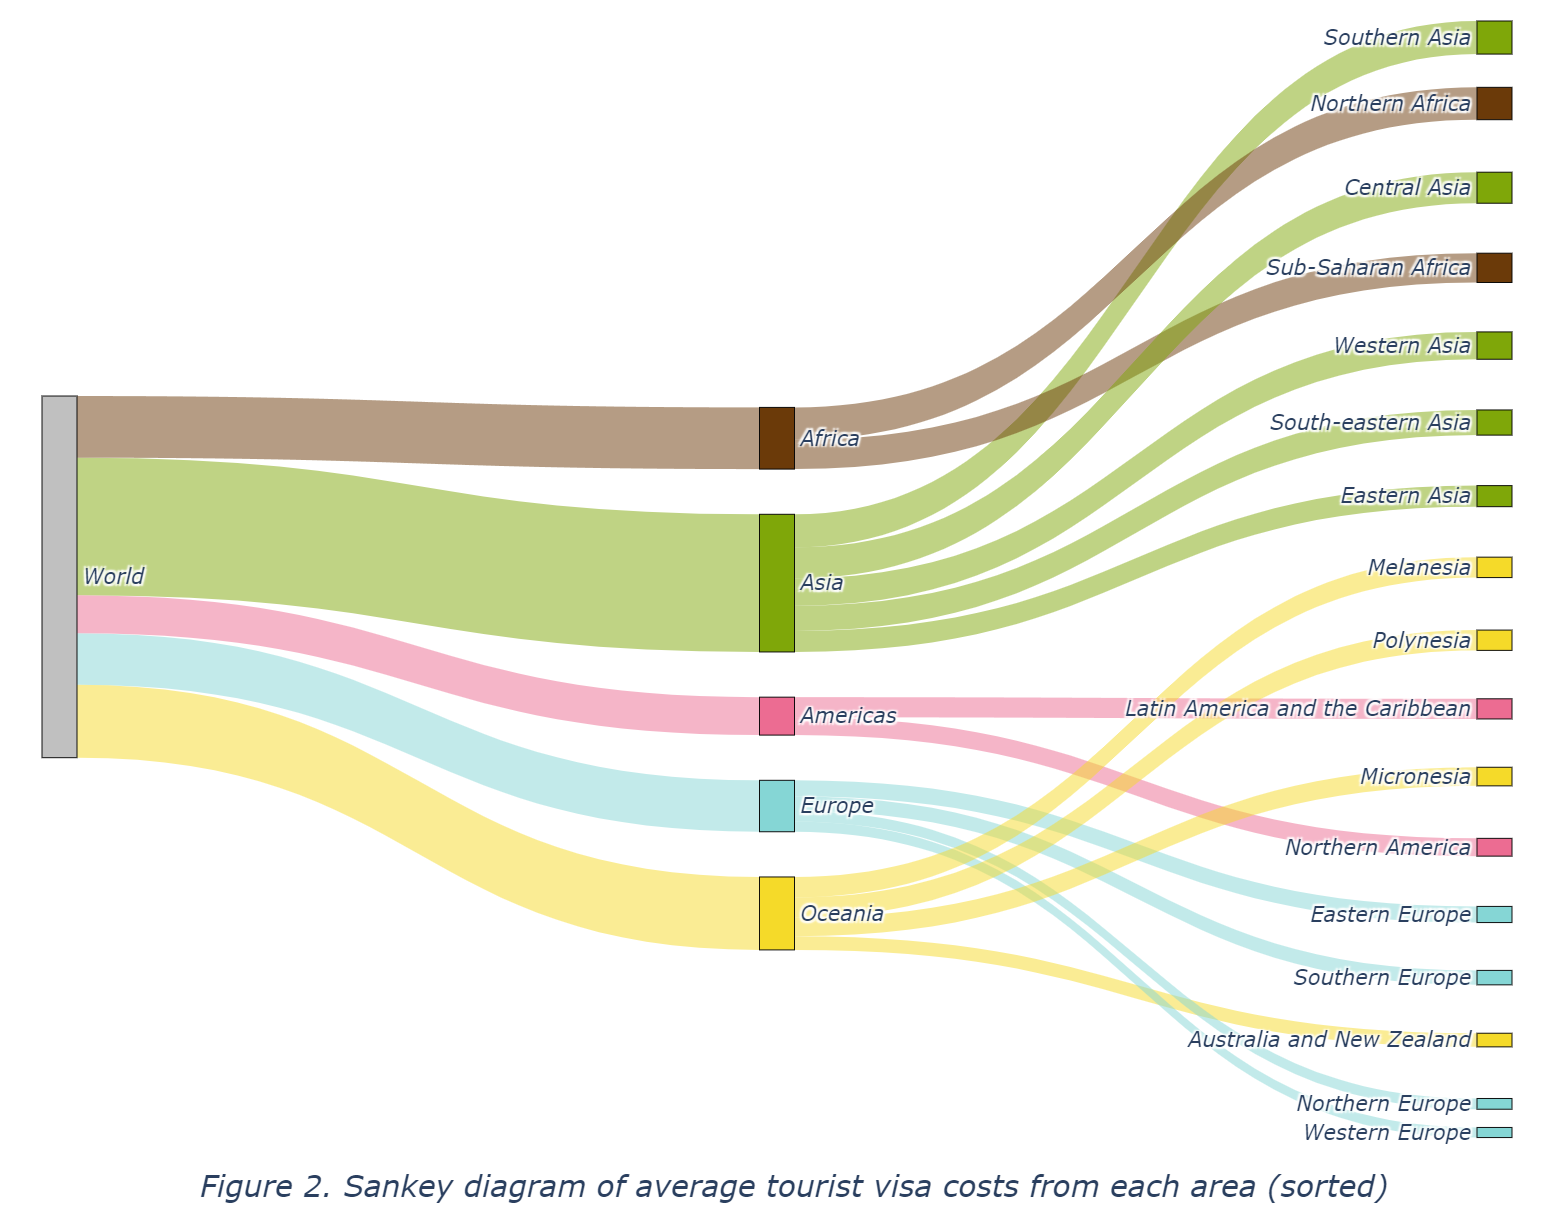
此外,图 2 提供了经手动按链接值(平均旅游签证费用)对子地区节点排序后的同一桑基图,以便更直观地解读各地区签证费用之间的差距。如 图 2 所示,属于亚洲和非洲的子地区呈现出显著更大的流量,反映出其较高的平均旅游签证费用。相比之下,欧洲、澳大利亚与新西兰以及北美洲的流量较小,说明这些地区的平均旅游签证费用较低。在亚洲内部,南亚地区费用最高,而东亚最低;类似地,西欧在欧洲各子地区中费用最低。
总体而言,图 1 和 图 2 揭示了不同地区国家在出境能力方面的潜在不平等。这一差距将在下一节的条形图(图 3 和 图 4)中进一步呈现。
import plotly.express as px  # 用于创建 Plotly 交互式图表

# 聚合数据,用于绘制条形图
bar_agg = df.groupby('source_subregion').agg(
    {
    'source_region':'first', # 各子地区所属地区
    'tourist_visa':'mean',   # 平均旅游签证费用
    'tourist_perdailyincome':'mean', # 按日收入折算的平均旅游签证费用
    }
).reset_index()  # 重置索引,使 'source_subregion' 成为普通列

#【.reset_index()】
# 该方法用于重置聚合后 DataFrame 的索引,
# 将所有列放回单层索引结构中(Pandas, 2024c)。
# 也就是说,将自动生成的索引('source_subregion')转换为普通列。# 创建条形图,展示各子地区的平均旅游签证费用
fig2 = px.bar(
bar_agg, x = 'tourist_visa', y = 'source_subregion',
labels = { # 指定 x 轴和 y 轴标签
'tourist_visa':'平均旅游签证费用(美元)',
'source_subregion':'子地区',
},
color = 'source_region', # 按地区分组,并使用不同颜色显示条形
color_discrete_map = region_colors # 指定颜色(前文已定义)
)
# 更新图形布局属性
fig2.update_layout(
# width=800, height=480,
margin = dict(t = 90, b = 10), # 上下边距
title_text='各子地区平均旅游签证费用',
title_x = 0.5, title_y = 0.95, # 标题位置
titlefont = {'style': 'italic'}, # 标题字体样式
yaxis = {'categoryorder': 'total ascending'}, # 按数值升序排序
legend = {
'title':'地区',
'orientation': 'h', # 水平图例
'xanchor': 'right',
'yanchor': 'bottom',
'x': 1, 'y': 1,
},
)
# fig2.show(config = {"responsive": True}) # 显示图形
fig2.show() # 显示图形图 3 与 图 1 和 图 2 呈现了相同的数据,即各地区(在 图 3 中仅显示子地区)按大洲分色的平均旅游签证费用。相比于桑基图,条形图能更清晰地展示数值差异,因为条形长度比链接宽度更易于区分,这也与 Wilke (Wilke, 2019, chap. 6) 的建议一致——条形图更适合呈现数值量的变化。由 图 1、图 2 和 图 3 可以推断:来自欧洲等发达地区的公民出境所需支付的签证费用较少,而来自南亚、北非等欠发达地区的公民则需支付更高的签证费用。然而,为了反映签证费用的真实负担,另一变量 ‘tourist_perdailyincome’(详见附录)被引入,以各国平均日收入为基准衡量签证的实际可负担性 (Recchi 等, 2021, p. 4)。
# 创建条形图,展示各子地区按日收入折算的平均旅游签证费用,
# 即各子地区国家居民负担旅游签证所需的平均工作天数。

fig3 = px.bar(
    bar_agg, x = 'tourist_perdailyincome', y = 'source_subregion',
    labels = dict( # 指定 x 轴和 y 轴标签
        tourist_perdailyincome = '''
            负担旅游签证所需平均工作天数(天)
        ''',
        source_subregion = '子地区',
    ),
    color = 'source_region', # 按地区分组,并使用不同颜色显示
    color_discrete_map = region_colors # 指定颜色(前文已定义)
)

# 更新图形布局属性
fig3.update_layout(
    # width=800, height=480,
    margin = dict(t = 90, b = 10),    # 上下边距
    title_text='''
        各子地区负担旅游签证所需平均工作天数
    ''',
    title_x = 0.5, title_y = 0.95,    # 标题位置
    titlefont = {'style': 'italic'},  # 标题字体样式
    yaxis = {'categoryorder': 'total ascending'}, # 按数值升序排序
    legend = {
        'title':'地区',
        'orientation': 'h',  # 水平图例
        'xanchor': 'right',
        'yanchor': 'bottom',
        'x': 1, 'y': 1,
    },
)

# fig3.show(config = {"responsive": True}) # 显示图形
fig3.show() # 显示图形如 图 4 所示,以日收入为基准的平均旅游签证费用(即负担旅游签证所需的平均工作天数)在各地区之间的差距更为悬殊,揭示了一个全球性的悖论:越贫穷的国家,其公民出境所需支付的签证费用反而越高。
# 聚合数据,用于绘制等值线地图
choro_agg = (
    df.groupby('source')
    .agg({
        'source_iso3': 'first',
        'tourist_visa': 'mean',
    })
    .sort_values('tourist_visa', ascending=False)
    .reset_index()
)

#【.sort_values()】
# 该方法用于按 'tourist_visa' 列对聚合后的 DataFrame 进行排序,
# 此处为降序排序(ascending=False)(Pandas, 2024d)。

#【.reset_index()】
# 重置索引,使 'source_iso3' 成为普通列# 创建等值线地图,展示各国平均旅游签证费用
fig4 = px.choropleth(
choro_agg,
locations = 'source_iso3', # 地理位置标识符
locationmode = 'ISO-3', # 国家代码
color = 'tourist_visa', # 按旅游签证费用设置地图颜色
hover_name = 'source', # 悬停显示:地区名称
hover_data = 'tourist_visa', # 悬停显示:数据
color_continuous_scale = 'aggrnyl', # 等值线地图色标
)
# 更新图形布局属性
fig4.update_layout(
# width = 800, height = 500,
title = '各国平均旅游签证费用等值线地图',
margin = dict(t = 50, b = 0),
title_x = 0.5, title_y = 0.95, # 标题位置
title_font = {'style':'italic'}, # 标题字体样式
coloraxis = dict(
colorbar = dict( # 指定色条属性
orientation = 'h', # 色条方向:水平
title = '平均旅游签证费用(美元)', # 色条标题
xanchor = 'right', x = 1,
yanchor = 'top', y = 1,
len = 0.8, thickness = 16, # 色条长度和厚度
),
),
)
# fig4.show(config = {"responsive": True}) # 显示图形
fig4.show() # 显示图形进一步地,将分析粒度从子地区细化到国家层面可以获得更多洞见。图 5 通过连续色标直观呈现了全球各国平均旅游签证费用的分布情况。根据 Wilke (2019, p. 173) 的观点,在等值线地图中,深色背景区域通常比浅色背景区域在网页上具有更好的可视性,因此 图 5 采用了深色背景的配色方案,颜色随数值增大而逐渐变浅 (Plotly, 2024)。
本项目仍有改进余地。例如,项目仅讨论了旅游签证这一类别;纳入其他签证类型将有助于深入了解签证费用的细微差异。此外,等值线地图(图 5)的色条可以采用分箱式连续色标加以优化,因为连续色标在辨识具体色值并与地图区域对应方面较为困难 (Wilke, 2019, pp. 174–175)。
综上所述,本项目对全球不同地区的旅游签证费用数据进行了可视化与分析,揭示了一个悖论性的全球现象:一个国家越富裕,其公民出境所需支付的签证费用反而越低。
本附录包含本项目所用数据集(全球签证费用数据集 v1.1)的补充信息,包括数据集介绍及各变量的详细说明。
全球签证费用数据集由欧洲大学学院移民政策中心的研究人员创建,提供了 2019 年各国家对之间七类签证费用的全面数据,主要通过手动从官方政府网站和领事馆收集。
签证费用按以下类别编码(单位:美元):旅游、学生、商务、工作、家庭团聚、过境及其他目的。
对于无法通过英语、法语、西班牙语、阿拉伯语、意大利语或俄语获取信息的国家,使用了翻译网站从该国主要语言中获取相关信息。
由于缺乏进入其领土的旅行信息,巴勒斯坦和阿拉伯叙利亚共和国等国家未被编入数据集。部分国家因其签证政策和签证要求信息难以获取,需进行第二轮核查。对于许多国家对,虽有签证政策信息,但无实际签证费用说明。例如,大洋洲的瑙鲁需要特别费力地搜索才能找到一份 2014 年 1 月的官方移民法规文件,其中列出了签证类别和费用,而该信息在任何其他官方在线渠道上均未出现。对于数据集中无法获取信息的国家对,引入缺失值。
这些变量表示来源国和目的国的国家与地区,其中”地区”指国家所在的大洲,“子地区”指大洲内的次级区域。
source: 来源国
target: 目的国
source_iso3: 来源国 ISO3 代码
target_iso3: 目的国 ISO3 代码
source_region: 来源国所在的世界地区
target_region: 目的国所在的世界地区
source_subregion: 来源国所在的世界子地区
target_subregion: 目的国所在的世界子地区
注:地区与子地区基于联合国 M.49 地理方案。
这些变量为目的国基于其官方签证政策与要求向来源国收取的 2019 年签证费用,以美元计。
tourist_visa: 旅游签证费用(美元)
student_visa: 学生签证费用(美元)
business_visa: 商务签证费用(美元)
work_visa: 工作签证费用(美元)
family_reunification_visa: 家庭团聚签证费用(美元)
transit_visa: 过境签证费用(美元)
other_motives_visa: 其他目的签证费用(美元)
这些变量估算来源国居民平均需要工作多少天才能负担前往目的国的签证费用,以天为单位。
tourist_perdailyincome: 旅游签证费用(以平均日收入为单位)
student_perdailyincome: 学生签证费用(以平均日收入为单位)
business_perdailyincome: 商务签证费用(以平均日收入为单位)
work_perdailyincome: 工作签证费用(以平均日收入为单位)
family_perdailyincome: 家庭团聚签证费用(以平均日收入为单位)
transit_perdailyincome: 过境签证费用(以平均日收入为单位)
other_perdailyincome: 其他目的签证费用(以平均日收入为单位)
注:作者使用人均国民总收入(GNI per capita)作为各国居民平均收入的近似值,以计算签证的实际成本水平。人均 GNI 数据来自世界银行(2019),可在以下链接获取:https://data.worldbank.org/indicator/NY.GNP.PCAP.CD 。
该变量记录与上一版本数据集相比的更新内容。
updated: 若该值在 2020 年 11 月从 1.0 版更新至 1.1 版时被添加或修改,则标记为 1。
注:1.1 版相比 1.0 版的更新包括数据修正、多国补充数据以及新增 ‘updated’ 变量以追踪变更。本项目仅使用更新版本(1.1 版)的数据集。